
Surveiller votre serveur dédié ou votre VPS : quelles sont les options en 2025 ?
12 min de lecture - 28 novembre 2025
Découvrez les meilleurs outils de surveillance pour les serveurs dédiés et les VPS en 2025, en mettant l'accent sur l'IA, l'automatisation et l'analyse en temps réel.
Surveillance de votre serveur dédié ou VPS : quelles sont les options en 2025 ?
En 2025, la surveillance de votre serveur dédié ou de votre VPS consistera avant tout à anticiper les problèmes potentiels grâce à des outils plus intelligents et plus efficaces. Les solutions modernes s'appuient désormais sur l'IA, l'analyse en temps réel et l'automatisation pour prédire les pannes, suivre les performances et réduire les temps d'arrêt. Voici un bref aperçu des principales options :
- Prometheus + Grafana : un duo open source pour la collecte de données chronologiques et la création de tableaux de bord personnalisables. Idéal pour les environnements cloud natifs.
- Zabbix : une solution de surveillance de niveau entreprise avec des alertes puissantes et une cartographie des dépendances pour les infrastructures complexes.
- Netdata : surveillance légère des performances en temps réel, avec une configuration rapide.
- Checkmk : une surveillance évolutive avec découverte automatisée des périphériques et analyses détaillées.
- Datadog : une surveillance axée sur le cloud avec des fonctionnalités basées sur l’IA et un traçage approfondi des applications.
Chaque outil répond à des besoins différents, des petites installations aux grandes entreprises. Vous trouverez ci-dessous un comparatif rapide pour vous aider à faire votre choix :
Comparaison rapide
| Outil | Idéal pour | Fonctionnalités clés | Coût |
|---|---|---|---|
| Prometheus + Grafana | Environnements natifs du cloud | Données chronologiques, tableaux de bord personnalisés | Gratuit (auto-hébergé) |
| Zabbix | Configurations informatiques complexes | Cartographie des dépendances, avec ou sans agent | Gratuit (auto-hébergé) |
| Netdata | Suivi des performances en temps réel | Métriques légères et instantanées | Gratuit / 4,50 $ par nœud |
| Checkmk | Déploiements à grande échelle | Détection automatique, large champ de surveillance | Environ 80 $/mois (100 hôtes) |
| Datadog | Surveillance au niveau du cloud et des applications | Analyses basées sur l'IA, traçage des applications, intégrations | À partir de 15 $/hôte/mois |
Faites votre choix en fonction de la taille de votre infrastructure, de votre expertise technique et de votre budget. Les outils open source tels que Prometheus et Zabbix sont économiques mais nécessitent davantage de configuration, tandis que les solutions payantes comme Datadog offrent une grande facilité d’utilisation et des fonctionnalités avancées. Commencez modestement et évoluez au fur et à mesure que vos besoins grandissent.
Guide complet de surveillance des serveurs | Cours de surveillance n° 2
1. Prometheus et Grafana
Prometheus et Grafana constituent ensemble l’une des solutions de surveillance open source les plus efficaces disponibles à l’heure actuelle. Prometheus se concentre sur la collecte et le stockage des données, tandis que Grafana transforme ces données en tableaux de bord visuellement intuitifs. Cette combinaison offre un moyen flexible et économique de surveiller les serveurs dédiés et les environnements VPS.
Portée de la surveillance
Prometheus est réputé pour sa capacité à collecter des données chronologiques sur divers systèmes. Il suit des indicateurs clés tels que l’utilisation du processeur, la consommation de mémoire et les E/S disque, tout en gérant des statistiques plus spécialisées, spécifiques aux applications. Grâce à un modèle de type « pull », il récupère les métriques à intervalles réguliers à partir des points de terminaison configurés, ce qui le rend adapté à la surveillance aussi bien des environnements conteneurisés que des serveurs traditionnels « bare-metal ».
Pour étendre ses capacités, Prometheus prend en charge de nombreux exportateurs officiels, ce qui lui permet de collecter des données provenant de presque tous les services ou applications fonctionnant au sein de votre infrastructure.
Grafana complète Prometheus en présentant ces données via des tableaux de bord personnalisables. Ces tableaux de bord peuvent afficher des graphiques en temps réel, des cartes thermiques et des états d’alerte. De plus, Grafana intègre des données provenant de multiples sources, vous offrant ainsi une vue unifiée et complète des performances de votre système.
Capacités en temps réel
Prometheus collecte des métriques à des intervalles pouvant être définis toutes les quelques secondes, bien que la valeur par défaut se situe généralement entre 15 et 30 secondes. De son côté, les tableaux de bord de Grafana s’actualisent automatiquement à mesure que de nouvelles données arrivent. Vous pouvez ajuster les intervalles de rafraîchissement en fonction de vos besoins, que ce soit toutes les quelques secondes ou sur des périodes plus longues. Cette réactivité est inestimable pour suivre les pics de trafic soudains ou les goulots d’étranglement au niveau des ressources, vous garantissant ainsi d’être toujours au courant des performances du système et prêt à intervenir en cas de problème.
Fonctionnalités d’IA et d’automatisation
Bien que Prometheus et Grafana ne reposent pas principalement sur l’IA, ils intègrent des fonctionnalités d’automatisation pour améliorer la surveillance. Prometheus inclut Alertmanager, qui envoie des notifications en fonction de conditions prédéfinies. Ce système prend en charge des règles d’alerte complexes, en exploitant à la fois les métriques en temps réel et les données historiques pour plus de précision.
Grafana a introduit des outils de détection d’anomalies qui utilisent l’apprentissage automatique pour repérer des schémas inhabituels dans vos métriques. Ces outils contribuent à réduire les fausses alertes en apprenant le comportement typique de votre système. Ils peuvent également prendre en charge l’automatisation en déclenchant des actions telles que la mise à l’échelle des ressources ou l’alerte des systèmes d’orchestration lorsque des seuils sont dépassés.
Facilité de déploiement
La mise en place de Prometheus et de Grafana est simple. Ces deux outils peuvent fonctionner dans des conteneurs Docker, ce qui garantit des installations cohérentes sur différents systèmes d’exploitation. Grâce à des outils tels que docker-compose, vous pouvez déployer une pile de surveillance complète en quelques minutes seulement.
Pour ceux qui utilisent des serveurs dédiés, les deux applications peuvent également être installées directement à l’aide des gestionnaires de paquets natifs sur la plupart des distributions Linux. Même les configurations avancées sont relativement faciles à mettre en place et à dépanner, ce qui rend ce duo accessible aux utilisateurs quel que soit leur niveau d’expertise.
Tarification
Prometheus et Grafana sont entièrement gratuits et open source, sans frais de licence, sans limite d’utilisateurs ni restriction de conservation des données. Cela en fait une solution économique pour la surveillance de votre infrastructure.
Pour ceux qui préfèrent une option gérée, Grafana propose un service basé sur le cloud. L’offre gratuite fournit des fonctionnalités de base, tandis que les formules payantes évolutives incluent des fonctionnalités et des capacités supplémentaires. Si de nombreux utilisateurs estiment que l’auto-hébergement répond à leurs besoins, le service géré constitue une alternative pratique, en particulier pour ceux qui cherchent à simplifier les tâches de maintenance et d’assistance.
2. Zabbix
Zabbix est une puissante plateforme de surveillance qui a été perfectionnée pendant plus de deux décennies pour répondre aux besoins des environnements d'entreprise. Elle offre une interface unifiée pour gérer les serveurs dédiés et les VPS, ce qui en fait un choix fiable pour les configurations complexes.
Portée de la surveillance
Zabbix va au-delà des métriques système de base, offrant une visibilité sur les périphériques réseau, les applications, les bases de données, les services web et les plateformes de virtualisation, le tout depuis un tableau de bord centralisé. Que vous préfériez une surveillance avec ou sans agent, Zabbix peut tout suivre, de l’utilisation du processeur et de la mémoire aux métriques d’applications personnalisées.
La plateforme simplifie la gestion dans les environnements dynamiques en détectant automatiquement les nouveaux périphériques et services. Elle prend en charge la surveillance des périphériques SNMP, l’exécution de requêtes sur les bases de données, la vérification des temps de réponse Web et l’analyse des journaux à la recherche d’erreurs.
L’une de ses fonctionnalités phares est sa capacité à cartographier les dépendances entre les composants de l’infrastructure. Ces cartes de dépendances offrent une vue claire de la manière dont les serveurs, les applications et les composants réseau interagissent, ce qui facilite l’identification et la résolution des problèmes.
Fonctionnalités en temps réel
Zabbix collecte et traite les données de surveillance à des intervalles que vous pouvez configurer, allant généralement de 30 secondes à 5 minutes, en fonction de l’importance des métriques. Son interface Web comprend des tableaux de bord en temps réel qui se mettent à jour automatiquement, vous offrant ainsi une vue toujours à jour de vos systèmes.
Vous pouvez personnaliser la fréquence de collecte des différents indicateurs. Par exemple, les données critiques peuvent être collectées plus fréquemment, tandis que les indicateurs moins essentiels sont enregistrés moins souvent. Cette flexibilité garantit une utilisation efficace des ressources système et de l’espace de stockage.
Fonctionnalités prédictives et automatisées
À partir des données historiques, Zabbix peut prévoir les tendances afin de détecter les anomalies à un stade précoce. Il automatise également les réponses en exécutant des scripts lorsque des seuils spécifiques sont atteints. Par exemple, la plateforme peut redémarrer un service ou exécuter automatiquement un script de maintenance lorsque des conditions prédéfinies sont remplies.
Son système d’alerte est conçu pour réduire la surcharge de notifications. Il regroupe les alertes liées et gère les dépendances, garantissant ainsi que seules les notifications pertinentes sont envoyées via les canaux de communication de votre choix.
Facilité de déploiement
Bien que Zabbix puisse nécessiter un peu plus d’efforts lors de la configuration initiale, il prend en charge diverses méthodes de déploiement, notamment les conteneurs Docker, les appliances virtuelles et les installations natives sur les distributions Linux courantes et les systèmes Windows.
Des modèles prédéfinis pour les applications et services les plus courants permettent de gagner du temps lors de la configuration. De plus, les fonctionnalités de détection et d’enregistrement automatiques de Zabbix simplifient la mise en place de la surveillance des nouveaux périphériques et services. Vous pouvez même automatiser le déploiement des agents sur l’ensemble des serveurs à l’aide d’outils de gestion de configuration ou des options intégrées à Zabbix.
Tarification
Zabbix est entièrement gratuit et open source, sans frais de licence ni limite d’utilisateurs. Pour ceux qui ont besoin d’une assistance supplémentaire, des formules d’abonnement commerciales sont disponibles, dont les tarifs dépendent du niveau d’assistance requis.
Les principaux coûts associés à Zabbix comprennent le matériel nécessaire au serveur et à la base de données Zabbix, ainsi que le temps consacré à la configuration et à la maintenance. Grâce à ses fonctionnalités étendues et à l’absence de frais de licence, Zabbix reste un concurrent de poids sur le marché de la surveillance à l’approche de 2025.
Vous en avez assez des déploiements lents ou des limites de bande passante ? FDC Servers offre une puissance dédiée instantanée, une couverture mondiale et des formules flexibles adaptées à toutes les échelles.
Mettez à jour dès maintenant3. Netdata
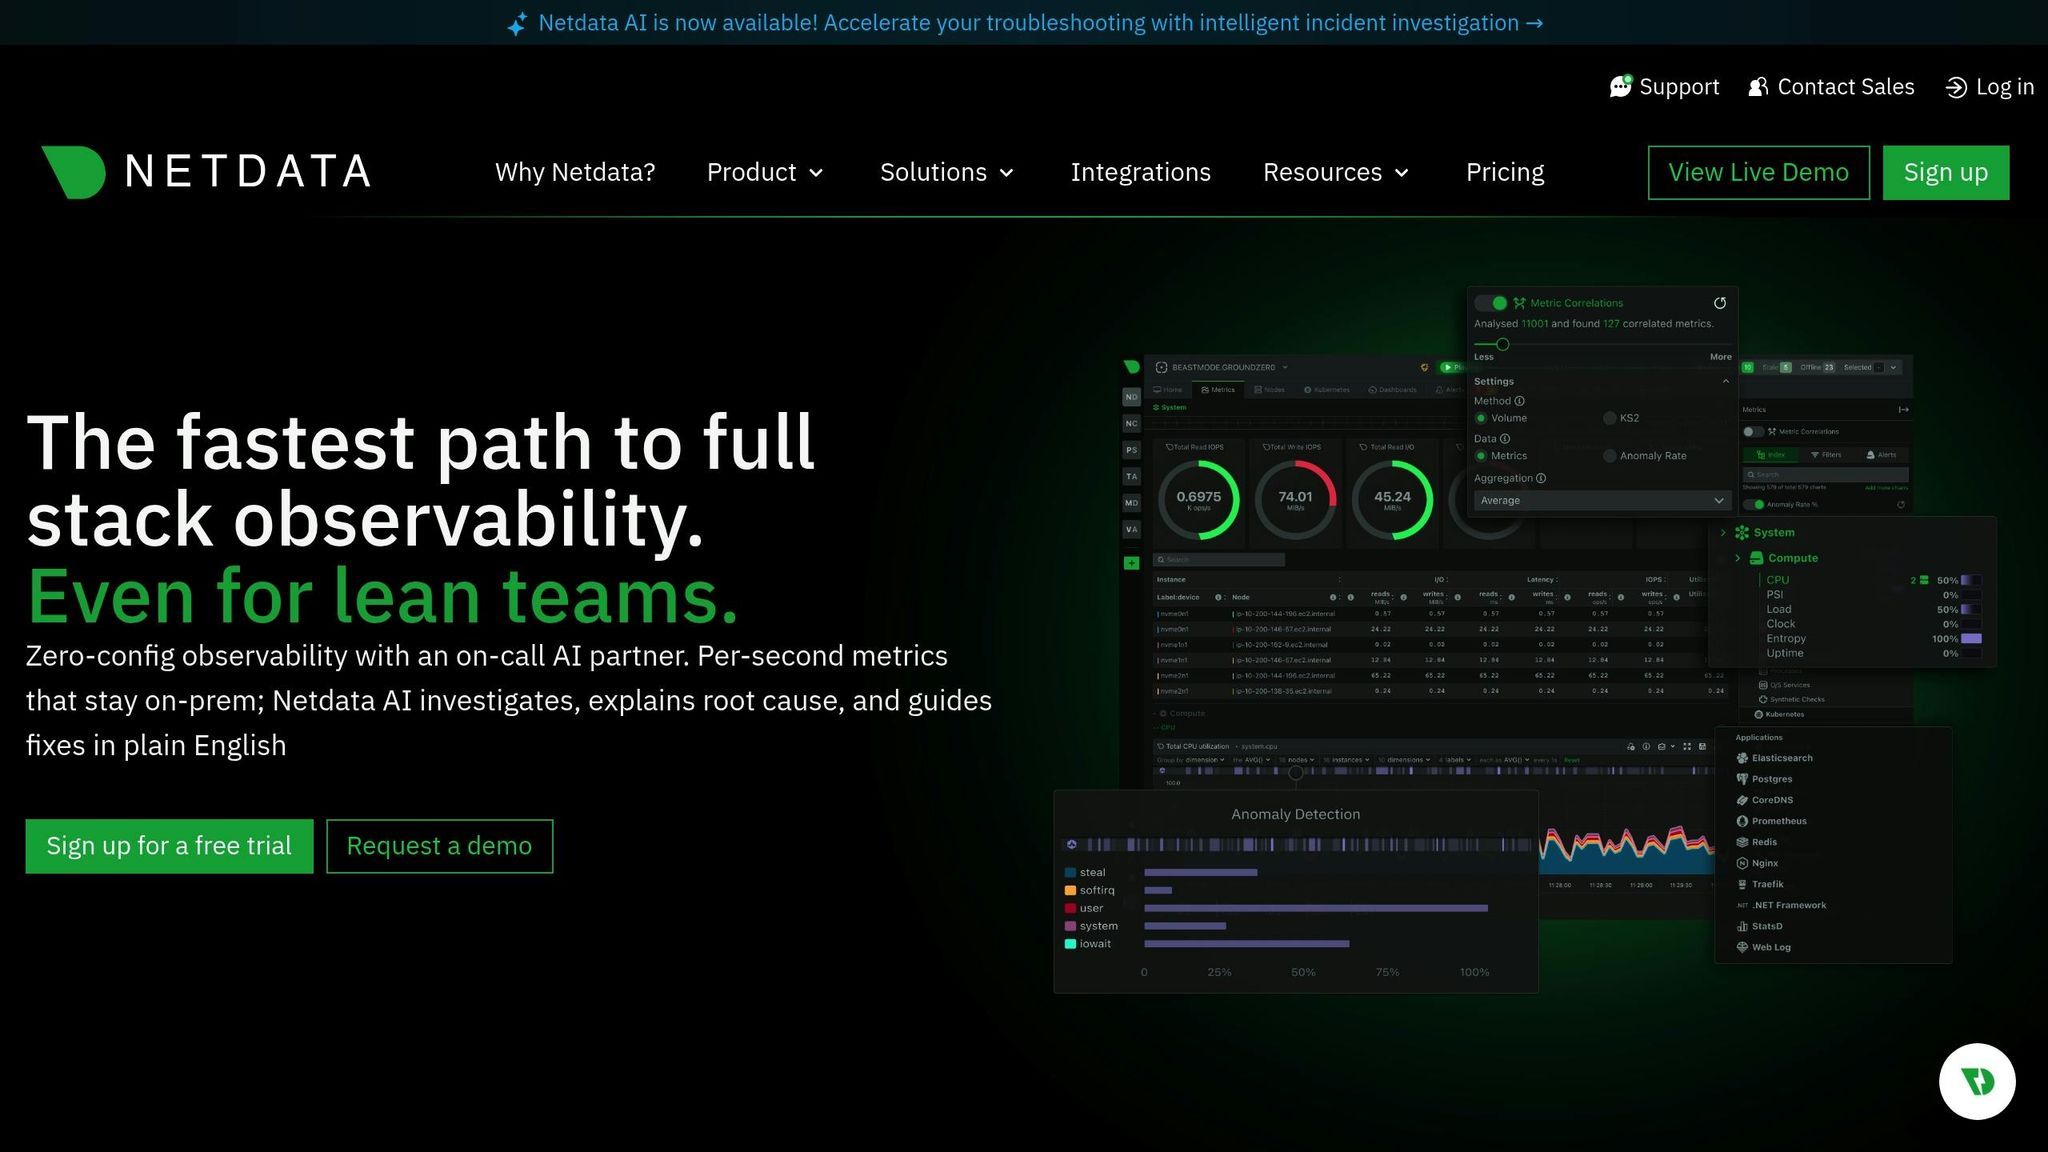
Netdata est un outil léger conçu pour la surveillance des performances en temps réel. Sa capacité à fournir des informations instantanées avec un impact minimal sur les ressources système en fait un choix incontournable pour les organisations ayant besoin d'une visibilité immédiate sur leur infrastructure.
Portée de la surveillance
Netdata surveille plus de 800 indicateurs, couvrant tout, de l’utilisation du processeur et de la mémoire aux E/S disque et au trafic réseau. Il fonctionne de manière transparente sur les serveurs dédiés et les VPS, et fournit même des indicateurs détaillés sur les conteneurs. En collectant des données toutes les secondes, il détecte les pics et les anomalies presque instantanément. Cette collecte de données en temps quasi réel complète les analyses historiques plus approfondies proposées par d’autres outils. Il suit également automatiquement les nouveaux services, applications et conteneurs dès leur mise en ligne. Pour ceux qui ont besoin d’un stockage à long terme ou d’analyses plus avancées, Netdata peut transmettre les métriques vers des plateformes externes telles que Prometheus ou OpenObserve.
Fonctionnalités en temps réel
Netdata propose des tableaux de bord en temps réel qui s’actualisent en continu, offrant une vue en direct de l’état de santé de votre système. Ces tableaux de bord sont personnalisables, ce qui vous permet de vous concentrer sur les métriques les plus importantes pour un dépannage rapide. Malgré la richesse de ses informations, la conception légère de Netdata garantit un fonctionnement avec une consommation minimale de ressources.
Fonctionnalités d’IA et d’automatisation
Netdata utilise la détection d’anomalies basée sur l’IA pour apprendre le comportement normal de votre système et signaler les écarts comme des problèmes potentiels. Il inclut également des alertes préconfigurées qui s’adaptent à votre infrastructure, réduisant ainsi les fausses alertes en tenant compte des tendances historiques et du contexte. Cependant, son système d’alerte moins centralisé peut nécessiter une intégration avec des outils externes pour des workflows plus complexes de routage des alertes ou d’escalade.
Facilité de déploiement
Netdata est facile à mettre en place, avec des options d’installation allant de simples scripts aux images Docker. Il prend en charge à la fois les environnements sur site et dans le cloud, s’intégrant en toute transparence aux piles de surveillance existantes. Sa nature open source permet une personnalisation sans dépendre d’un fournisseur spécifique. Pour les configurations conteneurisées, les images Docker et les charts Helm de Kubernetes simplifient le déploiement, tandis que la détection automatique garantit que les nouveaux services et applications sont immédiatement surveillés.
Tarification
Netdata propose une formule « Free Community » qui inclut des fonctionnalités essentielles telles que la surveillance en temps réel, les alertes de base et un tableau de bord web facile à utiliser — idéal pour les petites installations. Pour les grandes entreprises ou celles qui ont besoin de fonctionnalités avancées telles que la conservation prolongée des données, des alertes améliorées et une assistance prioritaire, les formules payantes commencent à 4,50 $ par nœud et par mois (facturation annuelle). Cette combinaison d’une offre gratuite solide et d’options payantes abordables rend Netdata accessible à un large éventail d’utilisateurs. Dans la suite de cet article, nous examinerons de plus près l’approche de Checkmk en matière de surveillance.
4. Checkmk
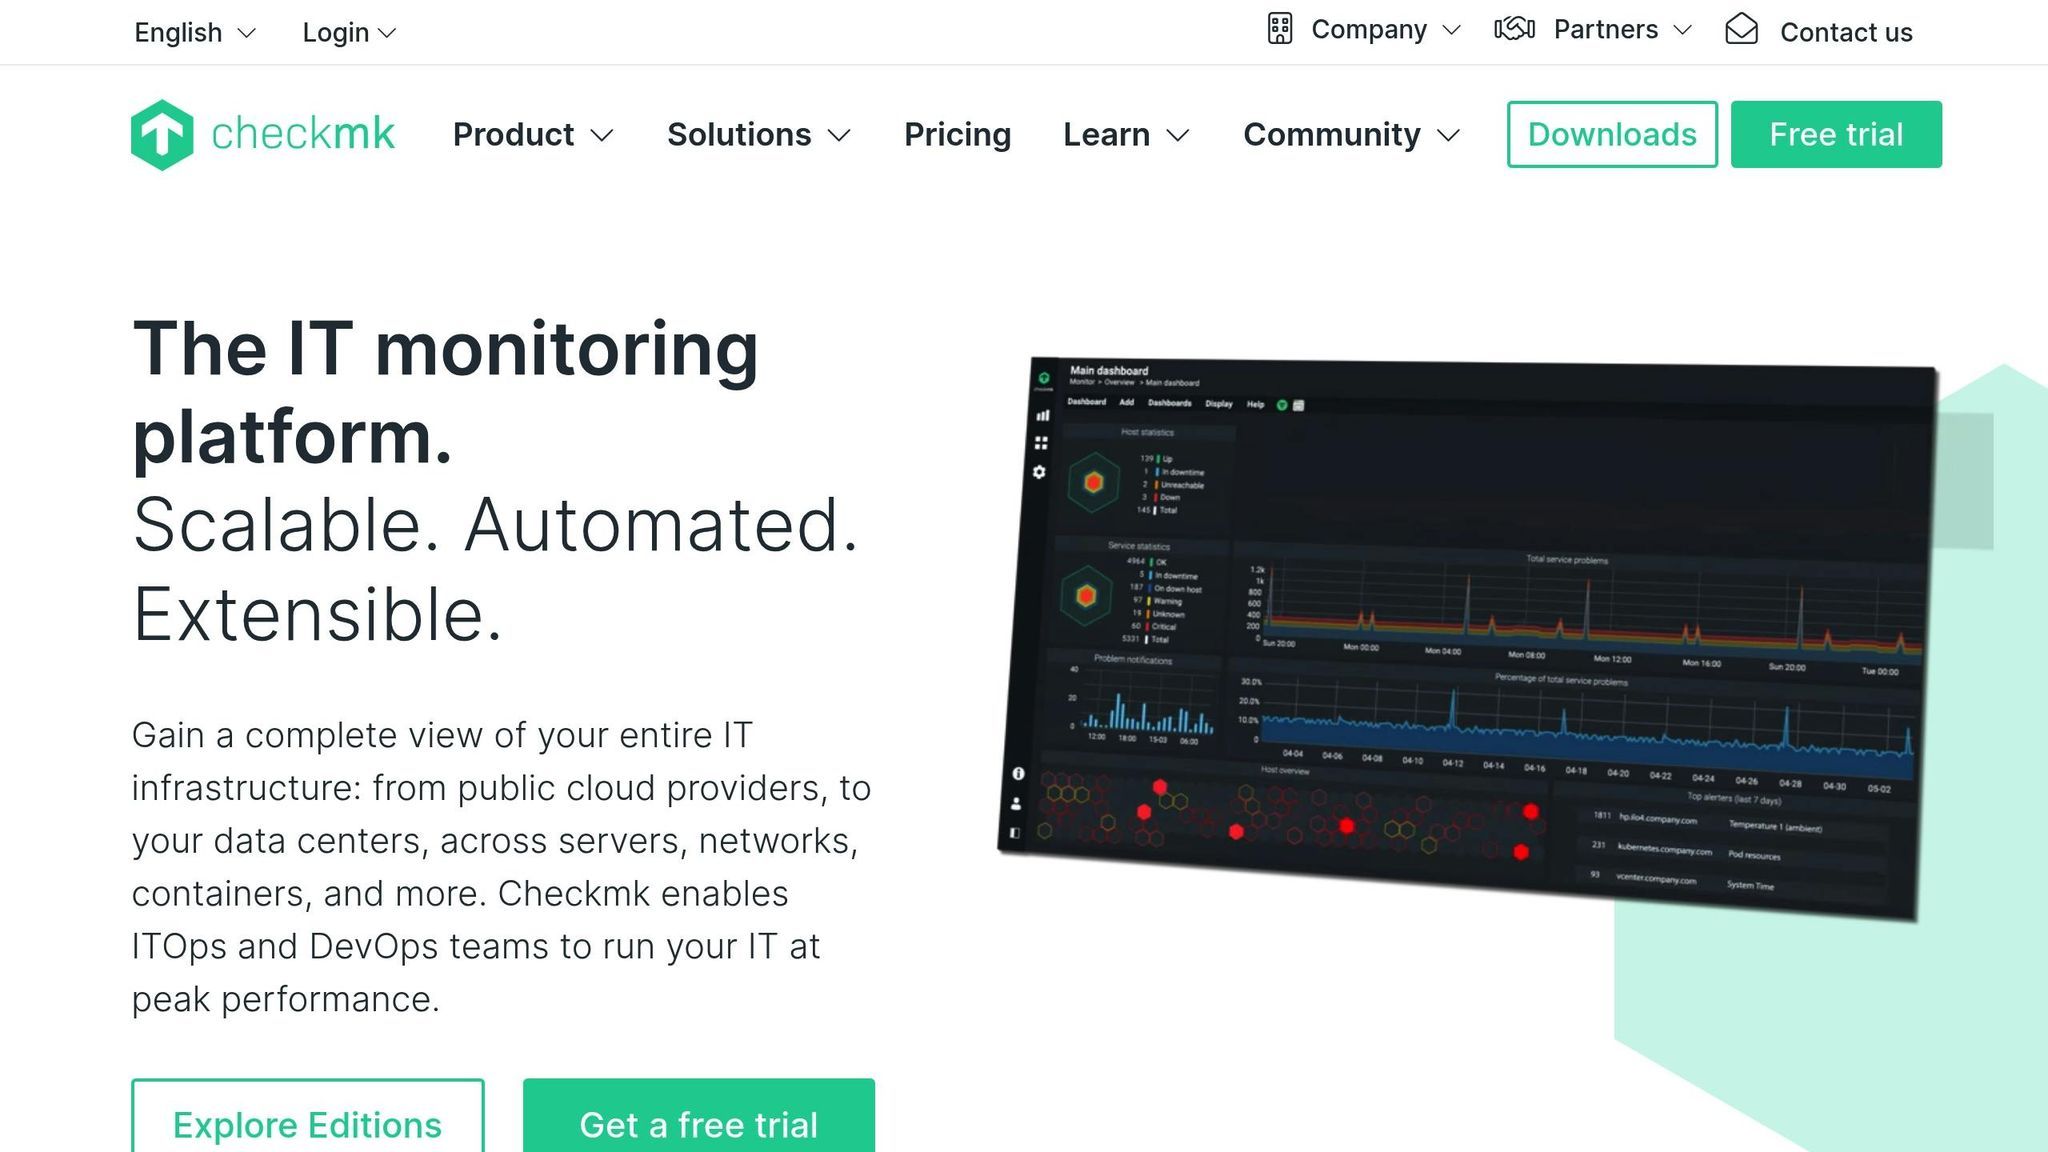
Checkmk est une puissante plateforme de surveillance conçue pour la gestion de serveurs dédiés et d’environnements VPS. L’une de ses fonctionnalités phares est sa capacité à détecter et à surveiller automatiquement les périphériques réseau, les serveurs et les services dès leur mise en ligne, vous évitant ainsi les tracas liés à la configuration manuelle.
Portée de la surveillance
Checkmk couvre un large champ de surveillance, permettant de suivre l’infrastructure, les réseaux, les applications, les conteneurs et les services cloud à partir d’une seule et même plateforme. Il offre des contrôles approfondis des hôtes et des services grâce à son vaste catalogue de plugins de surveillance, vous permettant d’observer l’état du matériel, des bases de données, des systèmes de stockage, des couches de virtualisation et des applications personnalisées. Il collecte des métriques détaillées à intervalles courts et met en corrélation les changements d’état entre les systèmes pour mettre en évidence les problèmes émergents. Sa conception hybride prend en charge à la fois la surveillance avec et sans agent, offrant ainsi une grande flexibilité dans les centres de données, les installations sur site et les environnements distribués.
Fonctionnalités en temps réel
Checkmk fournit des tableaux de bord en direct qui se mettent à jour en continu, affichant l’état des hôtes, les contrôles de services et les métriques de performance au fur et à mesure de leur évolution. Il prend en charge l’interrogation rapide des hôtes critiques et peut afficher des graphiques en temps réel sur la charge, la mémoire, le réseau et l’état des applications. Les tableaux de bord sont personnalisables, ce qui permet aux équipes de mettre en avant les systèmes prioritaires et de détecter rapidement les problèmes urgents. Son noyau de surveillance efficace maintient une faible charge système, même avec des milliers de contrôles par minute, ce qui permet aux grandes installations de conserver une visibilité réactive en temps réel.
Fonctionnalités d’IA et d’automatisation
Checkmk intègre un réglage automatisé des seuils et un traitement intelligent des règles qui réduisent la fatigue liée aux alertes en s’adaptant au comportement de référence. Il peut détecter automatiquement les hôtes et les services et appliquer des règles de surveillance prédéfinies sans configuration manuelle. Les fonctions prédictives facilitent l’analyse des tendances et la planification des capacités, aidant ainsi les équipes à détecter rapidement les risques de saturation. Pour les environnements complexes, son système d’automatisation basé sur des règles rationalise les mises à jour de configuration, l’activation des contrôles et la logique de notification. Les fonctionnalités d’IA plus avancées nécessitent généralement d’être associées à des outils d’analyse externes, car Checkmk se concentre sur la surveillance déterministe plutôt que sur l’automatisation complète des incidents.
Facilité de déploiement
Checkmk est simple à déployer grâce à un processus d’installation rapide et à des guides de configuration clairs. L’édition « Raw » utilise des composants open source, tandis que l’édition « Enterprise » inclut une interface utilisateur optimisée et des améliorations de performances. Les agents peuvent être installés à l’aide d’un petit script, et la détection automatique repère immédiatement les nouveaux services. La solution s’intègre bien aux environnements virtualisés et conteneurisés, et s’adapte facilement grâce à des sites de surveillance distribués pour les déploiements à grande échelle ou multirégionaux. Comme elle offre de solides paramètres par défaut dès son installation, les équipes peuvent rapidement mettre en place un système de surveillance complet sans avoir à procéder à des réglages approfondis.
Tarifs
Checkmk propose une édition « Raw » gratuite qui inclut les fonctionnalités de base de surveillance, les tableaux de bord et les alertes, ce qui la rend adaptée aux petites équipes ou aux environnements de laboratoire. L’édition « Enterprise » ajoute des fonctionnalités avancées telles que de meilleures performances, une automatisation étendue, des analyses prédictives et des rapports à long terme. La tarification de l’édition « Enterprise » est généralement basée sur le nombre d’hôtes surveillés, avec un niveau d’entrée abordable et une évolutivité adaptée aux infrastructures de plus grande envergure. Cela permet de maintenir des coûts globaux prévisibles et attractifs pour les organisations qui souhaitent disposer d’un système de surveillance puissant sans avoir à payer des frais d’utilisation élevés de type SaaS.
5. Datadog
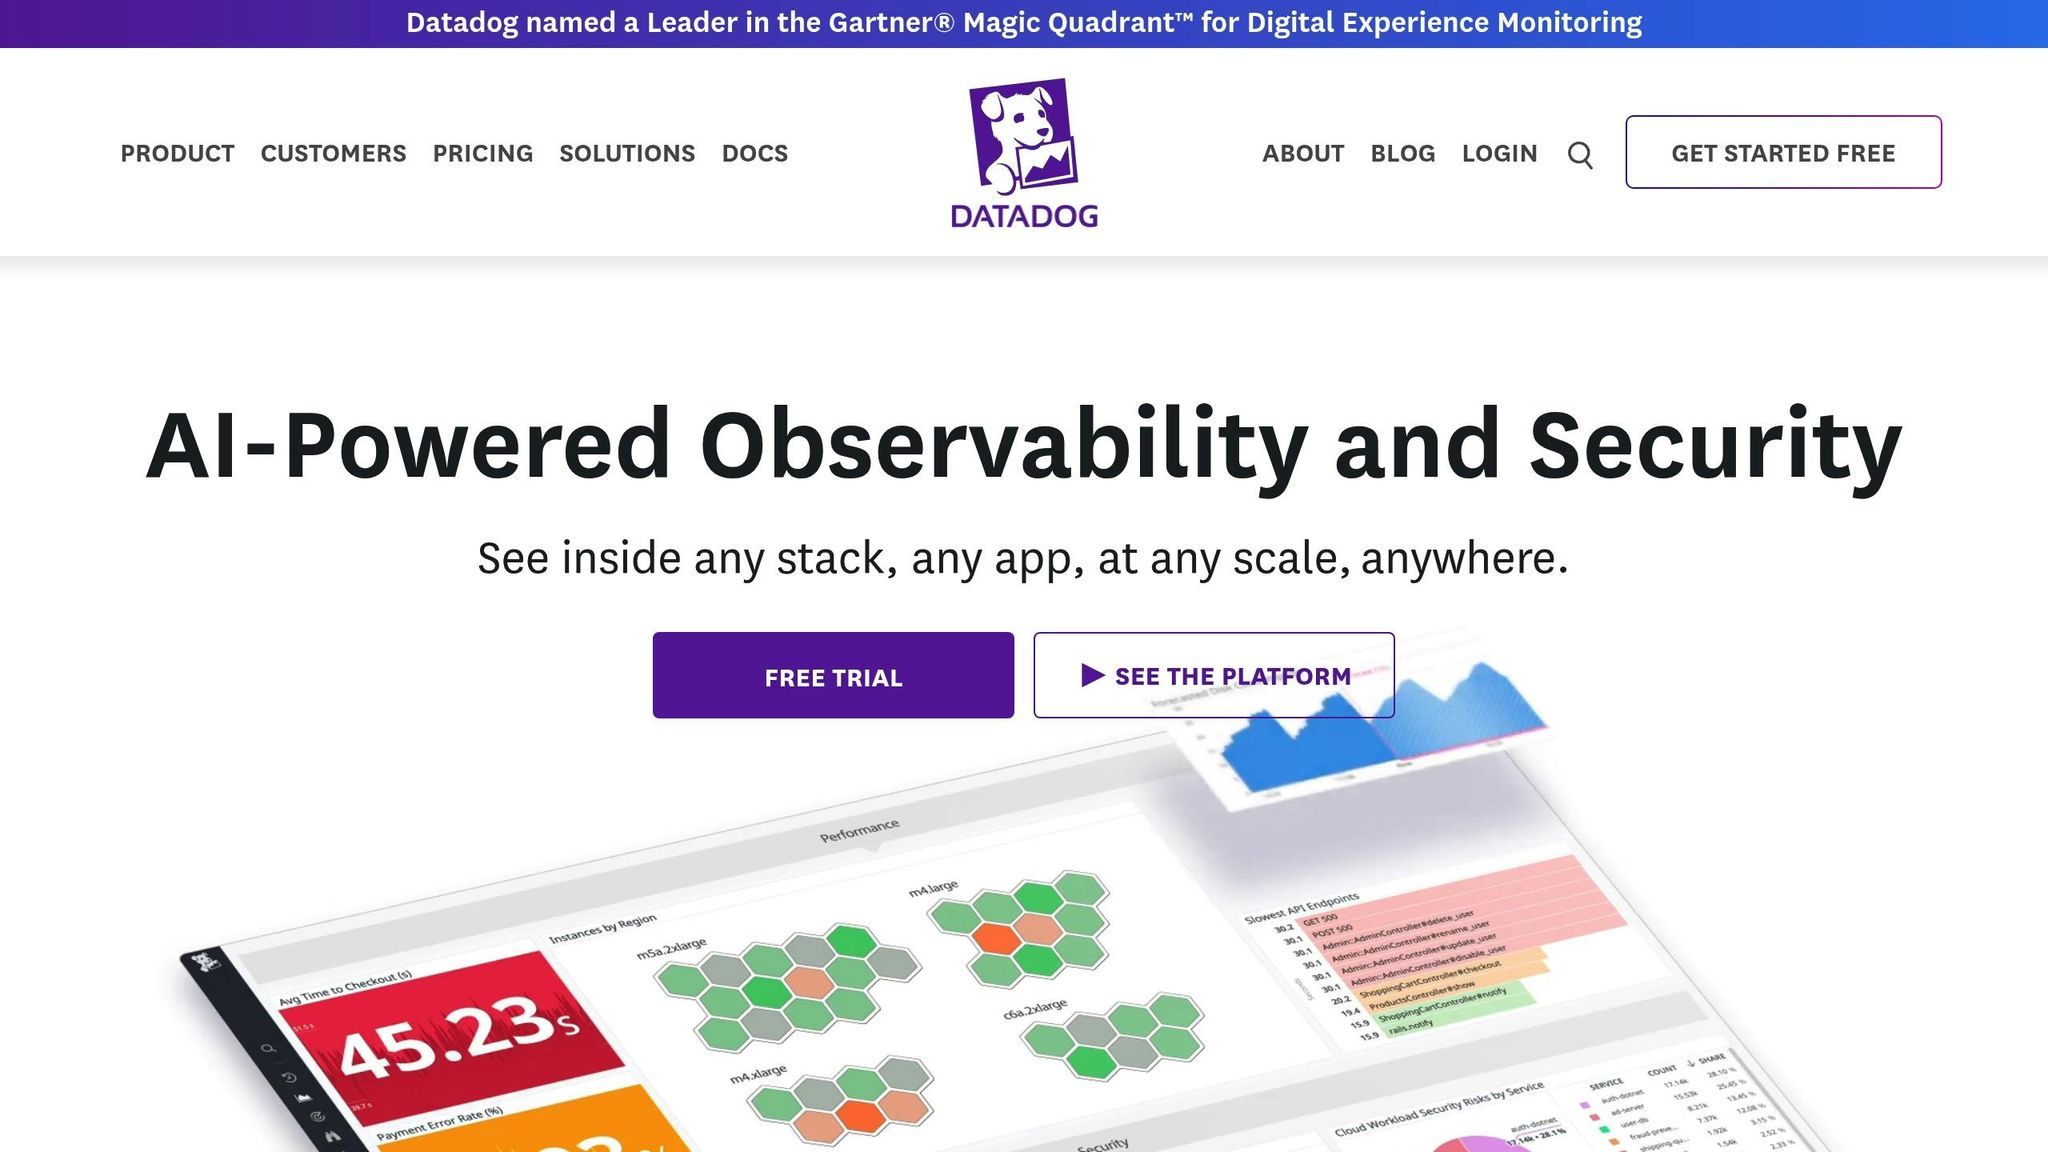
Datadog fait passer la surveillance des serveurs et des VPS à un niveau supérieur en analysant en profondeur les performances au niveau du code. Grâce à son traçage distribué alimenté par l’IA, il vous aide à identifier précisément les goulots d’étranglement et à détecter les anomalies dès qu’elles se produisent. En associant les journaux d’application aux métriques système, Datadog facilite l’identification des causes profondes des problèmes et leur résolution rapide, garantissant ainsi le bon fonctionnement de votre infrastructure.
Portée de la surveillance
Datadog rassemble les métriques d’infrastructure, les journaux, les traces et les signaux de sécurité au sein d’une plateforme d’observabilité unique. Il peut ingérer des données de télémétrie provenant d’hôtes, de conteneurs, de fonctions serverless, de services cloud gérés et d’applications personnalisées. Ses intégrations couvrent des centaines de technologies, ce qui vous permet de suivre le comportement des bases de données, les performances des API, les clusters Kubernetes et les charges de travail cloud natives à partir d’une vue unifiée. Les données sont collectées à haute fréquence et corrélées entre les métriques, les journaux et les traces afin de mettre en évidence les tendances de performance et les goulots d’étranglement. Cette large portée aide les équipes à comprendre comment chaque composante de leur pile se comporte sous une charge réelle.
Fonctionnalités en temps réel
Datadog propose des tableaux de bord en direct qui s’actualisent en permanence, affichant l’utilisation du processeur, la latence des requêtes, l’état des conteneurs, le débit réseau et bien plus encore, au fur et à mesure de leur évolution. Vous pouvez personnaliser les tableaux de bord pour mettre en avant les signaux pertinents et faciliter un diagnostic rapide. La solution prend également en charge les alertes en temps réel : ainsi, des problèmes tels que les pics d’erreurs ou la saturation de la mémoire peuvent déclencher des notifications dès leur apparition. Même face à d’importants volumes de données, son agent et son backend SaaS sont conçus pour maintenir une faible surcharge tout en offrant une visibilité à la seconde près sur l’ensemble des systèmes distribués.
Fonctionnalités d’IA et d’automatisation
Datadog intègre des outils basés sur l’IA qui analysent les références historiques pour détecter les anomalies et réduire le bruit lié aux faux positifs. Sa suite Bits AI ajoute le triage automatisé, la corrélation entre signaux et les résumés d’incidents afin d’accélérer les investigations. Elle peut suggérer des causes profondes probables, proposer des mesures correctives au niveau du code ou de la configuration, et générer de la documentation après les incidents. Vous pouvez également créer des workflows en utilisant le langage naturel, transformant ainsi les tâches opérationnelles courantes en séquences automatisées sans avoir à écrire de scripts. Cela aide les équipes à rationaliser les processus d’intervention tout en conservant le contrôle sur les voies d’escalade.
Facilité de déploiement
Datadog est simple à déployer grâce à son agent léger et à sa conception native du cloud. Vous pouvez installer l’agent à l’aide d’un seul script, utiliser des images Docker ou le déployer via Kubernetes avec Helm. Ses intégrations détectent automatiquement les services et commencent à collecter des données de télémétrie avec une configuration minimale. Comme tout s’exécute sur la plateforme hébergée de Datadog, il n’y a pas de backend à maintenir. La solution s’intègre facilement dans les environnements hybrides et multicloud, et s’adapte à une infrastructure en constante évolution, ce qui la rend idéale pour les équipes qui souhaitent bénéficier d’une visibilité totale sans avoir à gérer leur propre pile de surveillance.
Tarification
Datadog fonctionne selon un modèle tarifaire modulaire : les forfaits de base sont facturés par hôte surveillé, tandis que les fonctionnalités optionnelles sont facturées à l’utilisation. Le forfait Pro commence à environ 15 $ par hôte et par mois en cas de facturation annuelle, tandis que les forfaits Entreprise sont plus onéreux et incluent des fonctionnalités avancées de gouvernance et d’IA. Des frais supplémentaires s’appliquent pour les logs, les traces, les tests synthétiques, les métriques personnalisées et la conservation prolongée. Cela permet aux équipes de n’adopter que les composants dont elles ont besoin, même si les coûts peuvent augmenter rapidement dans les environnements comportant de nombreux hôtes ou générant un volume important de logs. Il s’agit néanmoins d’une option flexible pour les organisations qui souhaitent bénéficier d’une observabilité complète, soutenue par une plateforme SaaS mature.
Avantages et inconvénients
Après avoir exploré les fonctionnalités de chaque outil, analysons leurs atouts et leurs limites afin de vous aider à déterminer lequel correspond le mieux à vos besoins. Le choix approprié dépendra de facteurs tels que les fonctionnalités, la facilité d’utilisation et le budget.
Prometheus offre des performances exceptionnelles grâce à une collecte efficace des données chronologiques et à un langage de requête robuste (PromQL) spécialement conçu pour les environnements cloud natifs. Cependant, il ne dispose pas d’outils de visualisation intégrés ni de capacités de stockage à long terme, ce qui nécessite de recourir à des solutions externes pour ces fonctionnalités.
Grafana excelle dans la visualisation flexible et avancée des données, s’intégrant de manière transparente à diverses sources de données, y compris Prometheus, pour créer des tableaux de bord visuellement attrayants. Sa principale limite réside dans l’absence de collecte de données native, ce qui le rend dépendant d’outils externes pour l’ingestion.
Zabbix est une solution de surveillance évolutive et complète. Étant open source, elle élimine les coûts de licence mais nécessite souvent une configuration plus complexe et une maintenance continue, ce qui peut mobiliser d’importantes ressources.
Netdata se distingue par sa conception légère et sa surveillance des performances en temps réel, avec un processus de configuration rapide – souvent achevé en quelques minutes. Cela en fait un excellent choix pour les environnements de petite à moyenne taille. Cependant, ses capacités d’analyse historique des données à long terme sont limitées et ses fonctionnalités d’alerte sont plus basiques que celles des plateformes destinées aux grandes entreprises.
Checkmk offre une surveillance évolutive avec des métriques en temps réel et des alertes personnalisables, ce qui en fait la solution idéale pour les déploiements de serveurs à grande échelle. Ses fonctionnalités avancées s’accompagnent toutefois d’une courbe d’apprentissage plus raide et d’une complexité de configuration accrue à mesure que la taille du déploiement augmente.
Datadog offre une expérience de surveillance complète avec des analyses basées sur l’IA, couvrant l’infrastructure, les applications et la gestion des journaux. Bien que ses fonctionnalités soient étendues, les coûts d’abonnement peuvent rapidement grimper (par exemple, 15 dollars US par hôte et par mois pour l’infrastructure, avec des frais supplémentaires pour l’APM et la gestion des journaux). De plus, la maîtrise de ses fonctionnalités avancées nécessite un investissement important en temps et en formation.
Le tableau ci-dessous résume les principaux avantages, inconvénients et structures de coûts de chaque outil pour une comparaison rapide :
| Outil | Principaux atouts | Principaux points faibles | Structure des coûts |
|---|---|---|---|
| Prometheus | Collecte efficace de données chronologiques et langage de requête puissant | Pas de fonctionnalités intégrées de visualisation et de stockage | Open source (coûts d'exploitation uniquement) |
| Grafana | Visualisation flexible et avancée avec prise en charge de plusieurs sources | Pas de collecte de données native | Open source (coûts d'exploitation uniquement) |
| Zabbix | Surveillance évolutive et complète pour les environnements informatiques traditionnels | Configuration et maintenance complexes | Gratuit (frais d'hébergement et de maintenance en sus) |
| Netdata | Surveillance légère et en temps réel avec une configuration rapide | Analyse des données historiques et alertes limitées | À partir de 4,50 $ US par nœud et par mois |
| Checkmk | Surveillance évolutive avec des indicateurs en temps réel et des alertes personnalisées | Courbe d'apprentissage raide pour les fonctionnalités avancées | Environ 80 $ US par mois pour environ 100 hôtes |
| Datadog | Surveillance étendue à l'échelle du cloud avec des analyses basées sur l'IA | Coûts plus élevés et courbe d'apprentissage abrupte | À partir de 15 dollars US par hôte et par mois (frais supplémentaires en sus) |
Votre choix dépendra en fin de compte de l'expertise et du budget de votre équipe. Les outils open source tels que Prometheus et Zabbix peuvent s'avérer très efficaces si votre équipe dispose du savoir-faire technique nécessaire pour les gérer. En revanche, les solutions commerciales telles que Checkmk, Netdata et Datadog offrent des solutions prêtes à l’emploi qui réduisent la charge de travail en interne, mais s’accompagnent souvent de coûts plus élevés.
Conclusion
En 2025, le choix de l’outil de surveillance adapté à votre serveur dédié ou à votre VPS dépendra de la compréhension de votre environnement spécifique, de votre savoir-faire technique et de vos contraintes budgétaires.
Pour les petites installations ou celles nécessitant des résultats rapides, Netdata constitue un choix solide. Ses informations en temps réel et sa configuration simple en font l’outil idéal pour une surveillance immédiate sans nécessiter de configuration lourde.
Les environnements plus vastes et plus complexes nécessitent souvent des solutions évolutives. Si vous travaillez avec des systèmes cloud-native ou conteneurisés, Prometheus et Grafana constituent d’excellentes options. Ils combinent une collecte puissante de données chronologiques avec des visualisations personnalisables, bien qu’ils exigent un niveau d’expertise technique plus élevé pour être gérés efficacement.
Pour les entreprises, Checkmk et Datadog méritent d’être pris en considération. Checkmk offre de vastes capacités de surveillance et peut s’avérer rentable pour les déploiements à grande échelle. De son côté, Datadog se distingue par ses analyses basées sur l’IA et ses intégrations étendues, même si sa mise à l’échelle peut nécessiter une planification plus minutieuse des ressources.
Dans les environnements informatiques traditionnels dotés d’infrastructures variées, Zabbix reste un concurrent de taille. Bien que sa mise en place puisse s’avérer plus complexe, ses fonctionnalités robustes et l’absence de frais de licence en font une solution attrayante pour les organisations disposant d’administrateurs système dédiés.
En fin de compte, la meilleure solution de surveillance est celle qui correspond à la capacité de votre équipe à la gérer efficacement. Un outil regorgeant de fonctionnalités peut rapidement devenir un fardeau s’il dépasse vos capacités opérationnelles. Commencer par une option allégée comme Netdata vous permet d’établir une base de référence en matière de surveillance, tout en conservant la flexibilité nécessaire pour adopter des plateformes plus complètes à mesure que votre infrastructure et votre expertise se développent.
L’objectif est de privilégier une surveillance cohérente et exploitable plutôt que de courir après toutes les fonctionnalités avancées. En adoptant une approche progressive et sur mesure, vous pouvez vous assurer que votre stratégie de surveillance évolue au rythme des exigences de votre environnement d’hébergement.
FAQ
Comment l’IA et l’automatisation améliorent-elles la surveillance des serveurs en 2025, et quels outils offrent ces fonctionnalités ?
En 2025, l’IA et l’automatisation transforment la surveillance des serveurs, rendant la gestion des serveurs dédiés et des VPS plus intelligente, plus efficace et plus réactive. Grâce à des systèmes basés sur l’IA, il est possible d’identifier les schémas inhabituels, d’anticiper les pannes potentielles et de résoudre automatiquement les problèmes courants. Cette approche réduit les temps d’arrêt et renforce la fiabilité globale des serveurs.
Des outils tels que Dynatrace, Logz.io et Datadog ouvrent la voie en intégrant l’IA et l’automatisation. Ils fournissent des informations en temps réel, détectent les anomalies et proposent des analyses prédictives spécialement conçues pour les environnements d’hébergement hautes performances. Ces capacités garantissent un fonctionnement fluide et sécurisé des serveurs, même en cas de charges de travail intenses.
Que dois-je prendre en compte pour choisir entre des outils de surveillance open source et payants pour mon serveur ou mon VPS ?
Lorsque vous comparez les outils de surveillance open source et payants, il est essentiel de déterminer ce qui correspond le mieux à vos besoins et à vos ressources. Les outils open source sont généralement gratuits et offrent un haut degré de personnalisation, ce qui est idéal si vous disposez du savoir-faire technique nécessaire et avez besoin d’une solution flexible. À l’inverse, les outils payants sont souvent dotés d’interfaces intuitives, de fonctionnalités avancées et d’une assistance dédiée, ce qui vous permet de gagner du temps et de simplifier le processus.
Pour faire le bon choix, tenez compte de plusieurs facteurs clés : votre budget, le niveau d’assistance dont vous pourriez avoir besoin, la facilité de configuration de l’outil et sa capacité à évoluer en fonction des besoins de votre serveur ou de votre VPS. Prendre le temps d’évaluer ces éléments vous aidera à choisir l’option qui correspond le mieux à vos objectifs en matière de surveillance et de performances.
Comment s’assurer que votre solution de surveillance de serveurs s’adapte à la croissance de votre infrastructure ?
Pour que votre solution de surveillance suive le rythme de l’expansion de votre infrastructure, il est essentiel de privilégier les outils et les stratégies axés sur l’évolutivité et l’automatisation. Optez pour des plateformes capables de gérer des architectures distribuées, permettant une surveillance fluide de plusieurs serveurs ou machines virtuelles à mesure que votre système se développe. Des fonctionnalités telles que les analyses basées sur l’IA et les tableaux de bord en temps réel sont particulièrement utiles : elles permettent de traiter des volumes de données plus importants tout en fournissant des informations pertinentes sans ralentissement.
Il est également judicieux de choisir des outils proposant des alertes personnalisables et s’intégrant facilement à vos workflows actuels. Vous pourrez ainsi détecter et résoudre rapidement les problèmes à mesure que votre infrastructure évolue. Prenez l’habitude d’évaluer et d’ajuster régulièrement votre configuration de surveillance afin de garantir son efficacité et sa fiabilité tout au long de votre parcours de croissance.

Comment héberger les modèles d'IA Ollama sur des serveurs dédiés
Découvrez comment héberger les modèles d'IA Ollama sur des serveurs dédiés afin de garantir la sécurité des données, d'assurer l'évolutivité et d'améliorer les performances.
5 min de lecture - 8 septembre 2025
Comment installer et utiliser Redis sur un VPS
9 min de lecture - 7 janvier 2026