
Supervisión de tu servidor dedicado o VPS: ¿cuáles son las opciones en 2025?
12 min de lectura - 28 de noviembre de 2025
Descubre las mejores herramientas de monitorización para servidores dedicados y VPS en 2025, centrándote en la inteligencia artificial, la automatización y el análisis en tiempo real.
Supervisión de tu servidor dedicado o VPS: ¿qué opciones habrá en 2025?
La supervisión de tu servidor dedicado o VPS en 2025 consiste en adelantarse a posibles problemas con herramientas más inteligentes y eficientes. Las soluciones modernas aprovechan ahora la inteligencia artificial, el análisis en tiempo real y la automatización para predecir fallos, realizar un seguimiento del rendimiento y reducir el tiempo de inactividad. A continuación, te ofrecemos un breve resumen de las principales opciones:
- Prometheus + Grafana: dúo de código abierto para la recopilación de datos de series temporales y paneles personalizables. Ideal para configuraciones nativas de la nube.
- Zabbix: monitorización de nivel empresarial con potentes alertas y mapeo de dependencias para infraestructuras complejas.
- Netdata: monitorización de rendimiento ligera y en tiempo real con una configuración rápida.
- Checkmk: monitorización escalable con detección automática de dispositivos e información detallada.
- Datadog: monitorización centrada en la nube con funciones basadas en IA y un seguimiento exhaustivo de las aplicaciones.
Cada herramienta se adapta a diferentes necesidades, desde pequeñas configuraciones hasta grandes empresas. A continuación, te ofrecemos una comparación rápida para ayudarte a decidir:
Comparación rápida
| Herramienta | Ideal para | Características principales | Coste |
|---|---|---|---|
| Prometheus + Grafana | Entornos nativos de la nube | Datos de series temporales, paneles personalizados | Gratis (autohospedado) |
| Zabbix | Configuraciones informáticas complejas | Mapeo de dependencias, con o sin agentes | Gratis (autohospedado) |
| Netdata | Seguimiento del rendimiento en tiempo real | Métricas ligeras e instantáneas | Gratuito/4,50 $ por nodo |
| Checkmk | Implementaciones a gran escala | Detección automática, amplio alcance de monitorización | ~80 $ al mes (100 hosts) |
| Datadog | Supervisión a nivel de nube y de aplicaciones | Informes basados en IA, rastreo de aplicaciones, integraciones | 15 $+/host/mes |
Elige en función del tamaño de tu infraestructura, tus conocimientos técnicos y tu presupuesto. Las herramientas de código abierto como Prometheus y Zabbix son rentables, pero requieren una mayor configuración, mientras que las opciones de pago como Datadog ofrecen facilidad de uso y funciones avanzadas. Empieza poco a poco y amplía la escala a medida que crezcan tus necesidades.
Guía completa de monitorización de servidores | Curso de monitorización n.º 2
1. Prometheus y Grafana
Prometheus y Grafana forman juntos una de las soluciones de monitorización de código abierto más eficaces disponibles en la actualidad. Prometheus se centra en la recopilación y el almacenamiento de datos, mientras que Grafana transforma esos datos en paneles de control visualmente intuitivos. Esta combinación ofrece una forma flexible y económica de monitorizar servidores dedicados y entornos VPS.
Ámbito de monitorización
Prometheus es conocido por su capacidad para recopilar datos de series temporales en diversos sistemas. Realiza un seguimiento de métricas clave como el uso de la CPU, el consumo de memoria y las E/S de disco, al tiempo que gestiona estadísticas más especializadas y específicas de cada aplicación. Mediante un modelo basado en «pull», recupera métricas de los puntos finales configurados a intervalos regulares, lo que lo hace adecuado para supervisar tanto entornos en contenedores como servidores tradicionales «bare-metal».
Para ampliar sus capacidades, Prometheus es compatible con numerosos exportadores oficiales, lo que le permite recopilar datos de casi cualquier servicio o aplicación que se ejecute en tu infraestructura.
Grafana complementa a Prometheus al presentar estos datos a través de paneles personalizables. Estos paneles pueden incluir gráficos en tiempo real, mapas de calor y estados de alerta. Además, Grafana integra datos de múltiples fuentes, lo que te ofrece una visión unificada y completa del rendimiento de tu sistema.
Capacidades en tiempo real
Prometheus recopila métricas a intervalos que pueden configurarse con una frecuencia de tan solo unos segundos, aunque el valor por defecto suele estar entre 15 y 30 segundos. Por su parte, los paneles de Grafana se actualizan automáticamente a medida que llegan nuevos datos. Puedes ajustar los intervalos de actualización según tus necesidades, ya sea cada pocos segundos o en períodos más largos. Esta rápida capacidad de respuesta es inestimable para detectar picos repentinos de tráfico o cuellos de botella en los recursos, lo que garantiza que estés siempre al día sobre el rendimiento del sistema y listo para actuar ante cualquier problema.
Funciones de IA y automatización
Aunque Prometheus y Grafana no se basan principalmente en la IA, sí incluyen funciones de automatización para mejorar la monitorización. Prometheus incluye Alertmanager, que envía notificaciones basadas en condiciones predefinidas. Este sistema admite reglas de alerta complejas, aprovechando tanto las métricas en tiempo real como los datos históricos para garantizar la precisión.
Grafana ha introducido herramientas de detección de anomalías que utilizan el aprendizaje automático para identificar patrones inusuales en tus métricas. Estas herramientas ayudan a reducir las falsas alarmas al aprender el comportamiento típico de tu sistema. También pueden facilitar la automatización al activar acciones como el escalado de recursos o el envío de alertas a los sistemas de orquestación cuando se superan los umbrales.
Facilidad de implementación
La configuración de Prometheus y Grafana es sencilla. Ambas herramientas pueden ejecutarse en contenedores Docker, lo que garantiza instalaciones uniformes en diferentes sistemas operativos. Con herramientas como docker-compose, puedes implementar una pila de monitorización completa en tan solo unos minutos.
Para quienes utilizan servidores dedicados, ambas aplicaciones también se pueden instalar directamente mediante los gestores de paquetes nativos en la mayoría de las distribuciones de Linux. Incluso las configuraciones avanzadas son relativamente fáciles de configurar y solucionar, lo que hace que este dúo sea accesible para usuarios con distintos niveles de experiencia.
Precios
Prometheus y Grafana son totalmente gratuitos y de código abierto, sin cuotas de licencia, límites de usuarios ni restricciones de retención de datos. Esto los convierte en una solución rentable para supervisar tu infraestructura.
Para quienes prefieran una opción gestionada, Grafana ofrece un servicio basado en la nube. El nivel gratuito proporciona funcionalidades básicas, mientras que los planes de pago escalables incluyen características y capacidad adicionales. Aunque muchos usuarios consideran que el autoalojamiento satisface sus necesidades, el servicio gestionado es una alternativa cómoda, especialmente para quienes buscan simplificar las tareas de mantenimiento y asistencia técnica.
2. Zabbix
Zabbix es una potente plataforma de monitorización que se ha perfeccionado a lo largo de dos décadas para satisfacer las necesidades de entornos de nivel empresarial. Ofrece una interfaz unificada para gestionar servidores dedicados y VPS, lo que la convierte en una opción fiable para configuraciones complejas.
Ámbito de monitorización
Zabbix va más allá de las métricas básicas del sistema, proporcionando visibilidad sobre dispositivos de red, aplicaciones, bases de datos, servicios web y plataformas de virtualización, todo ello desde un panel de control centralizado. Tanto si prefieres la monitorización basada en agentes como sin agentes, Zabbix puede realizar un seguimiento de todo, desde el uso de la CPU y la memoria hasta métricas personalizadas de aplicaciones.
La plataforma simplifica la gestión en entornos dinámicos al detectar automáticamente nuevos dispositivos y servicios. Permite supervisar dispositivos SNMP, ejecutar consultas en bases de datos, comprobar los tiempos de respuesta web y analizar los registros en busca de errores.
Una característica destacada es su capacidad para mapear las dependencias entre los componentes de la infraestructura. Estos mapas de dependencias ofrecen una visión clara de cómo interactúan los servidores, las aplicaciones y los componentes de red, lo que facilita la identificación y resolución de problemas.
Capacidades en tiempo real
Zabbix recopila y procesa datos de monitorización a intervalos que puedes configurar, que suelen oscilar entre 30 segundos y 5 minutos, dependiendo de la importancia de las métricas. Su interfaz web incluye paneles en tiempo real que se actualizan automáticamente, lo que te ofrece una visión siempre actualizada de tus sistemas.
Puede personalizar la frecuencia con la que se recopilan las diferentes métricas. Por ejemplo, los datos críticos pueden recopilarse con mayor frecuencia, mientras que las métricas menos esenciales se registran con menos frecuencia. Esta flexibilidad garantiza un uso eficiente de los recursos del sistema y del almacenamiento.
Funciones predictivas y automatizadas
A partir de datos históricos, Zabbix puede predecir tendencias para detectar anomalías de forma temprana. También automatiza las respuestas mediante la ejecución de scripts cuando se alcanzan umbrales específicos. Por ejemplo, la plataforma puede reiniciar un servicio o ejecutar un script de mantenimiento automáticamente cuando se dan unas condiciones predefinidas.
Su sistema de alertas está diseñado para reducir la sobrecarga de notificaciones. Agrupa las alertas relacionadas y gestiona las dependencias, garantizando que solo se envíen notificaciones relevantes a través de los canales de comunicación que elijas.
Facilidad de implementación
Aunque Zabbix puede requerir un poco más de esfuerzo durante la configuración inicial, admite diversos métodos de implementación, incluidos contenedores Docker, dispositivos virtuales e instalaciones nativas en distribuciones populares de Linux y sistemas Windows.
Las plantillas predefinidas para aplicaciones y servicios de uso generalizado ahorran tiempo durante la configuración. Además, las funciones de detección automática y registro automático de Zabbix simplifican el proceso de configuración de la supervisión de nuevos dispositivos y servicios. Incluso puedes automatizar la implementación de agentes en los servidores utilizando herramientas de gestión de la configuración u opciones integradas en Zabbix.
Precios
Zabbix es totalmente gratuito y de código abierto, sin cuotas de licencia ni límites de usuarios. Para quienes necesiten asistencia adicional, hay disponibles paquetes de suscripción comerciales, cuyos precios dependen del nivel de asistencia requerido.
Los principales costes asociados a Zabbix incluyen el hardware necesario para el servidor y la base de datos de Zabbix, así como el tiempo dedicado a la configuración y el mantenimiento. Gracias a su amplia gama de funciones y a la ausencia de cuotas de licencia, Zabbix sigue siendo un firme competidor en el ámbito de la monitorización a medida que nos acercamos al año 2025.
¿Cansado de implementaciones lentas o de límites de ancho de banda? FDC Servers ofrece potencia dedicada al instante, alcance global y planes flexibles diseñados para cualquier escala.
Actualizar ahora3. Netdata
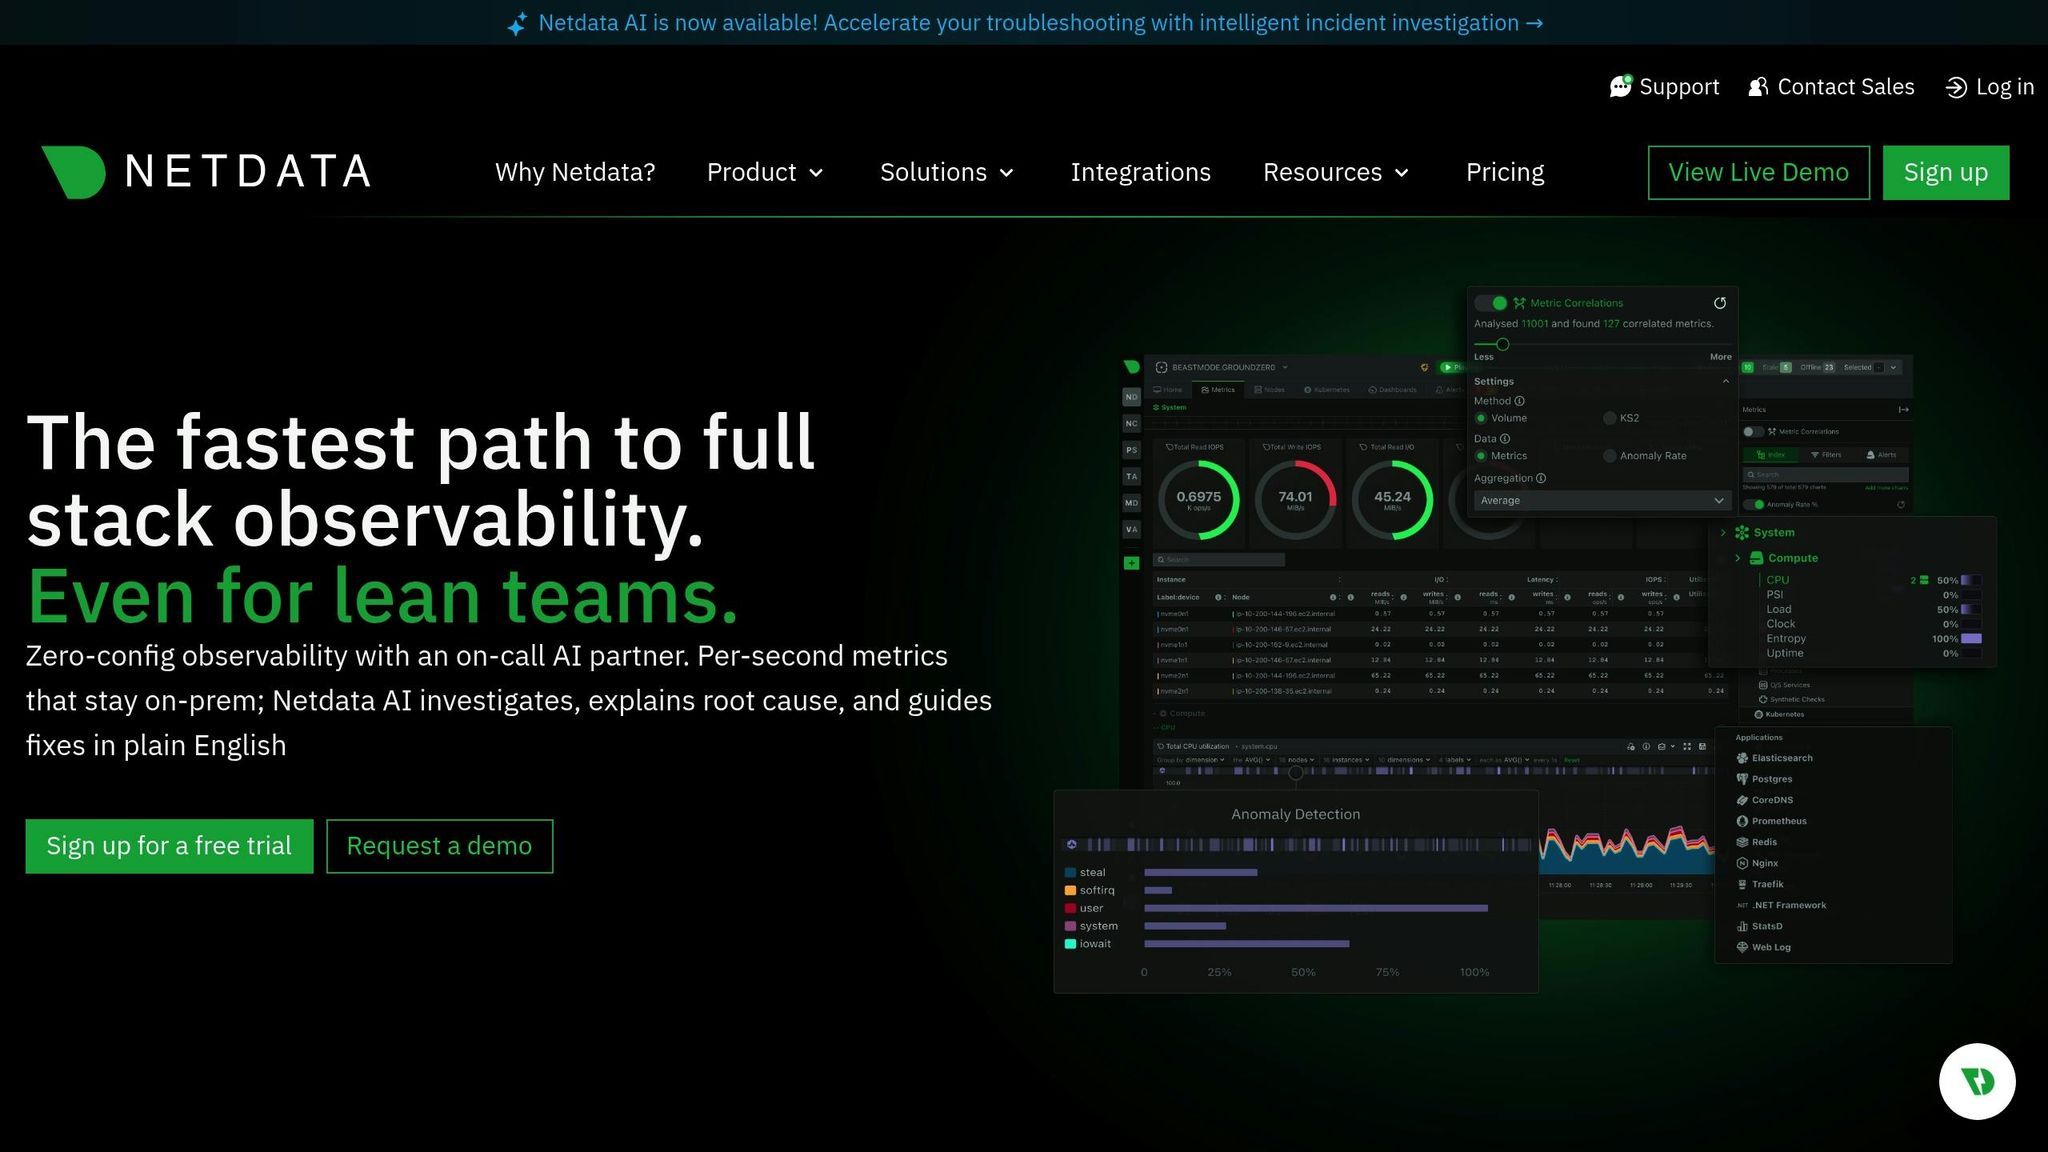
Netdata es una herramienta ligera diseñada para la supervisión del rendimiento en tiempo real. Su capacidad para ofrecer información instantánea con un impacto mínimo en los recursos del sistema la convierte en la opción ideal para las organizaciones que necesitan una visibilidad inmediata de su infraestructura.
Ámbito de supervisión
Netdata supervisa más de 800 métricas, que abarcan desde el uso de la CPU y la memoria hasta las E/S de disco y el tráfico de red. Funciona a la perfección en servidores dedicados y VPS, e incluso proporciona métricas detalladas de contenedores. Al recopilar datos cada segundo, detecta picos y anomalías casi al instante. Esta recopilación de datos casi en tiempo real complementa los análisis históricos más exhaustivos que ofrecen otras herramientas. Además, realiza un seguimiento automático de los nuevos servicios, aplicaciones y contenedores a medida que se ponen en línea. Para quienes necesiten almacenamiento a largo plazo o análisis más avanzados, Netdata puede enviar las métricas a plataformas externas como Prometheus u OpenObserve.
Funcionalidades en tiempo real
Netdata ofrece paneles de control en tiempo real que se actualizan continuamente, lo que proporciona una visión en directo del estado de tu sistema. Estos paneles son personalizables, lo que te permite centrarte en las métricas más importantes para una rápida resolución de problemas. A pesar de la profundidad de su información, el diseño ligero de Netdata garantiza que funcione con un consumo mínimo de recursos.
Funciones de IA y automatización
Netdata utiliza la detección de anomalías basada en IA para aprender el comportamiento normal de su sistema y señala las desviaciones como posibles problemas. También incluye alertas preconfiguradas que se adaptan a su infraestructura, lo que reduce las falsas alarmas al tener en cuenta las tendencias históricas y el contexto. Sin embargo, su sistema de alertas, menos centralizado, puede requerir la integración con herramientas externas para un enrutamiento de alertas más complejo o flujos de trabajo de escalado.
Facilidad de implementación
Netdata es fácil de configurar, con opciones de instalación que van desde sencillos scripts hasta imágenes de Docker. Es compatible tanto con entornos locales como en la nube, y se integra a la perfección con las pilas de monitorización existentes. Su naturaleza de código abierto permite la personalización sin estar vinculado a un proveedor específico. Para configuraciones en contenedores, las imágenes de Docker y los gráficos Helm de Kubernetes simplifican la implementación, mientras que la detección automática garantiza que los nuevos servicios y aplicaciones se supervisen de inmediato.
Precios
Netdata ofrece un plan gratuito «Community» que incluye funciones esenciales como la monitorización en tiempo real, alertas básicas y un panel de control web fácil de usar, ideal para configuraciones más pequeñas. Para organizaciones más grandes o aquellas que necesiten funciones avanzadas como retención de datos ampliada, alertas mejoradas y asistencia prioritaria, los planes de pago comienzan a partir de 4,50 dólares por nodo al mes (facturados anualmente). Esta combinación de un sólido nivel gratuito y opciones de pago asequibles hace que Netdata sea accesible para una amplia gama de usuarios. A continuación, analizaremos más detenidamente el enfoque de Checkmk en materia de monitorización.
4. Checkmk
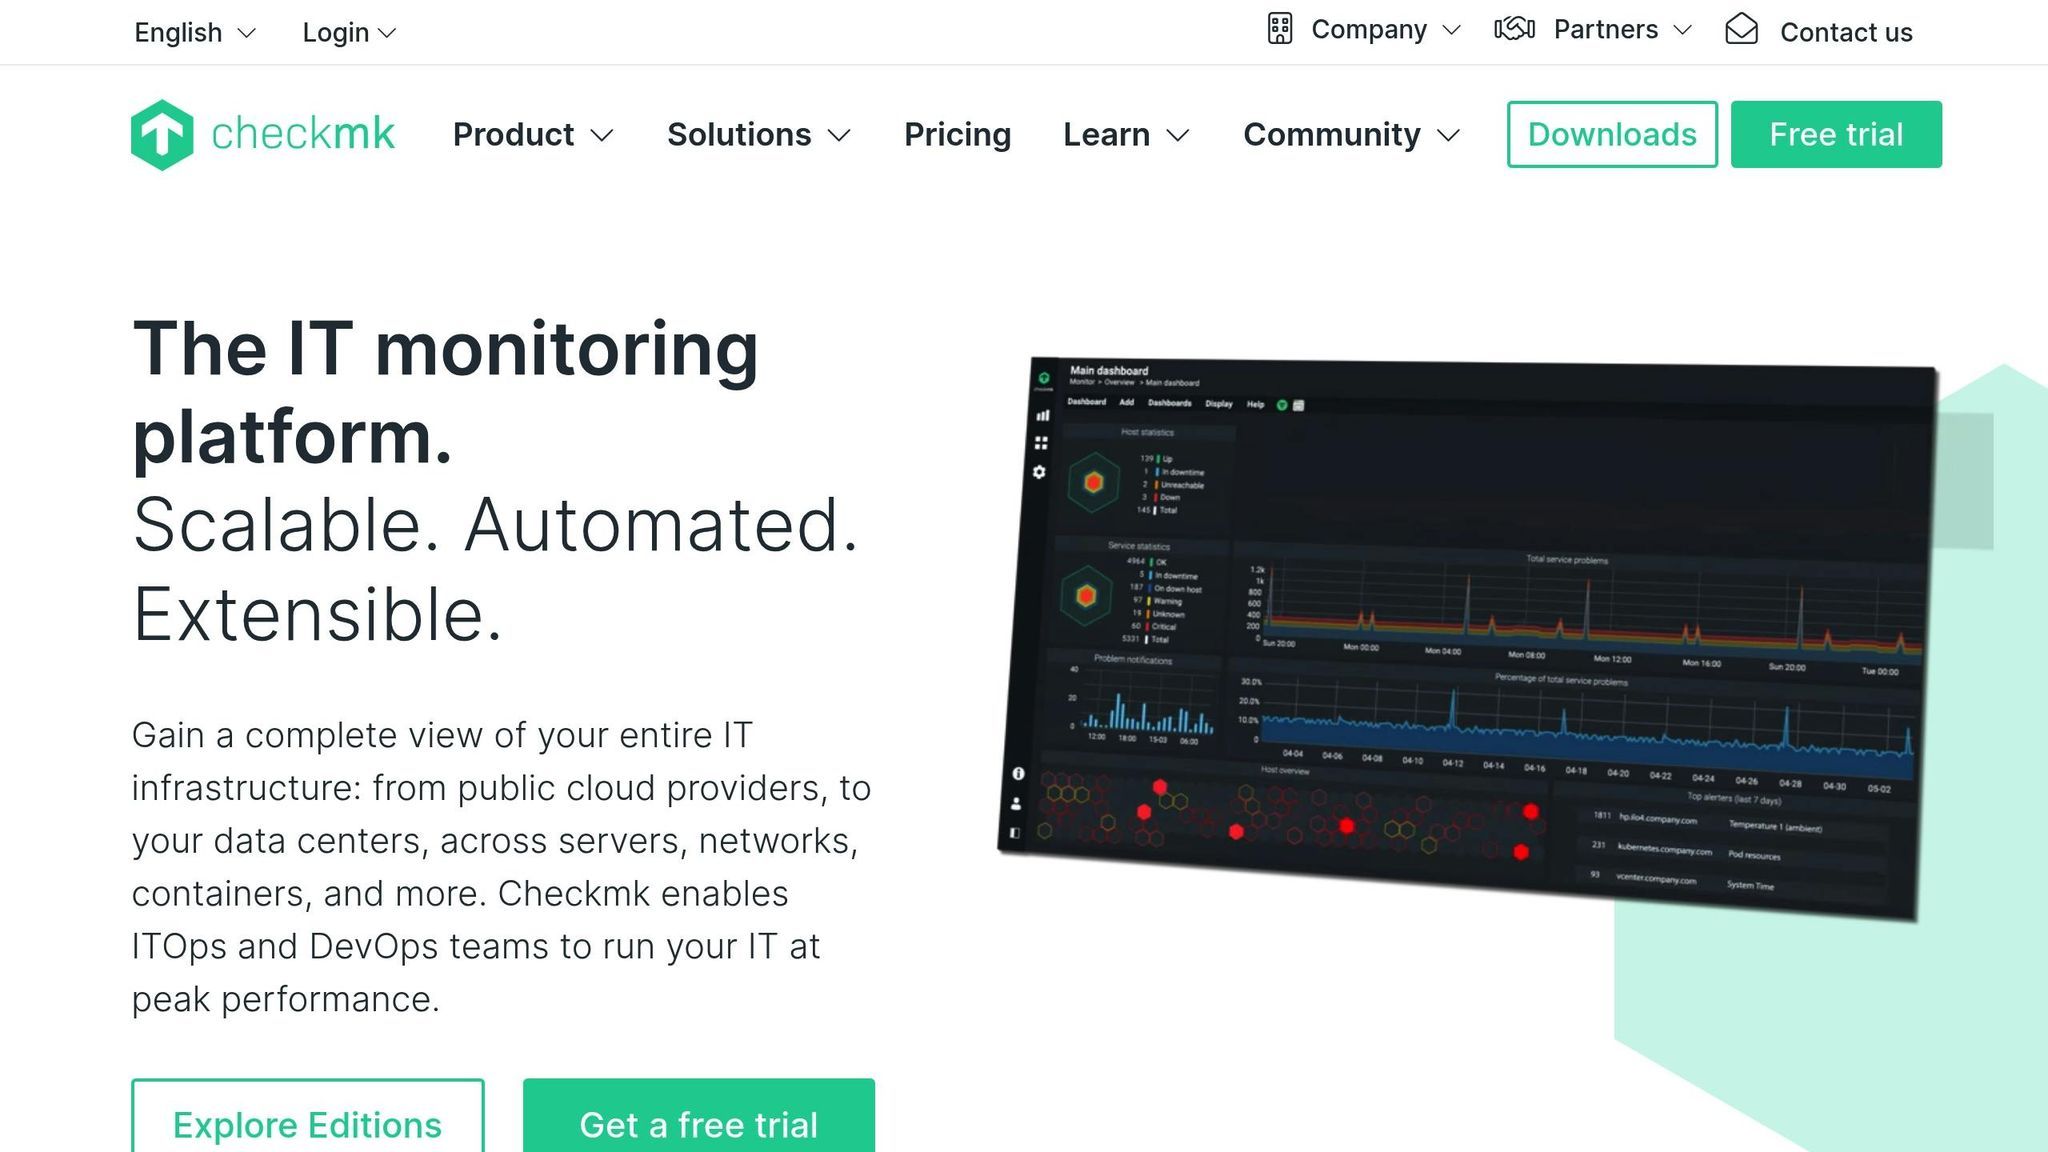
Checkmk es una potente plataforma de monitorización diseñada para gestionar servidores dedicados y entornos VPS. Una de sus características más destacadas es su capacidad para detectar y monitorizar automáticamente dispositivos de red, servidores y servicios en cuanto se conectan, lo que te ahorra la molestia de la configuración manual.
Ámbito de monitorización
Checkmk abarca un amplio ámbito de monitorización, realizando un seguimiento de la infraestructura, las redes, las aplicaciones, los contenedores y los servicios en la nube desde una única plataforma. Ofrece comprobaciones exhaustivas de hosts y servicios a través de su amplio catálogo de complementos de monitorización, lo que te permite observar el estado del hardware, las bases de datos, los sistemas de almacenamiento, las capas de virtualización y las aplicaciones personalizadas. Recopila métricas detalladas a intervalos cortos y correlaciona los cambios de estado entre los distintos sistemas para destacar los problemas emergentes. Su diseño híbrido admite tanto la supervisión basada en agentes como sin agentes, lo que proporciona flexibilidad en centros de datos, instalaciones locales y entornos distribuidos.
Funcionalidades en tiempo real
Checkmk ofrece paneles de control en directo que se actualizan continuamente, mostrando el estado de los hosts, las comprobaciones de servicios y las métricas de rendimiento a medida que cambian. Admite sondeos rápidos para hosts críticos y puede mostrar gráficos en tiempo real sobre la carga, la memoria, la red y el estado de las aplicaciones. Los paneles de control son personalizables, por lo que los equipos pueden destacar los sistemas prioritarios y detectar rápidamente los problemas urgentes. Su eficiente núcleo de monitorización mantiene baja la sobrecarga incluso con miles de comprobaciones por minuto, lo que permite a las grandes instalaciones mantener una visibilidad en tiempo real con gran capacidad de respuesta.
Funciones de IA y automatización
Checkmk incluye el ajuste automatizado de umbrales y el procesamiento inteligente de reglas que reducen la fatiga por alertas al adaptarse al comportamiento de referencia. Puede detectar hosts y servicios automáticamente y aplicar reglas de monitorización predefinidas sin necesidad de configuración manual. Las funciones predictivas facilitan el análisis de tendencias y la planificación de la capacidad, lo que ayuda a los equipos a detectar a tiempo los riesgos de saturación. En entornos complejos, su sistema de automatización basado en reglas agiliza las actualizaciones de configuración, la activación de comprobaciones y la lógica de notificaciones. Las funciones de IA más avanzadas suelen requerir la integración con herramientas de análisis externas, ya que Checkmk se centra en la monitorización determinista más que en la automatización completa de incidencias.
Facilidad de implementación
Checkmk es fácil de implementar, con un proceso de instalación rápido y guías de configuración claras. La edición «raw» utiliza componentes de código abierto, mientras que la edición «enterprise» incluye una interfaz de usuario mejorada y optimizaciones de rendimiento. Los agentes se pueden instalar con un pequeño script, y la detección automática identifica los nuevos servicios de inmediato. Se integra bien con entornos virtualizados y en contenedores, y se adapta fácilmente a través de sitios de monitorización distribuidos para implementaciones de gran envergadura o multirregionales. Dado que ofrece unos ajustes predeterminados sólidos desde el primer momento, los equipos pueden poner en marcha rápidamente un sistema de monitorización completo sin necesidad de un ajuste exhaustivo.
Precios
Checkmk ofrece una edición «raw» gratuita que incluye la monitorización básica, paneles de control y alertas, lo que la hace adecuada para equipos pequeños o entornos de laboratorio. La edición «enterprise» añade funciones avanzadas como un mejor rendimiento, automatización ampliada, análisis predictivo e informes a largo plazo. El precio de la edición «Enterprise» suele basarse en el número de hosts supervisados, partiendo de un nivel de entrada asequible y escalando para infraestructuras más grandes. Esto mantiene los costes generales predecibles y atractivos para las organizaciones que desean un potente sistema de supervisión sin las elevadas tarifas de uso propias del modelo SaaS.
5. Datadog
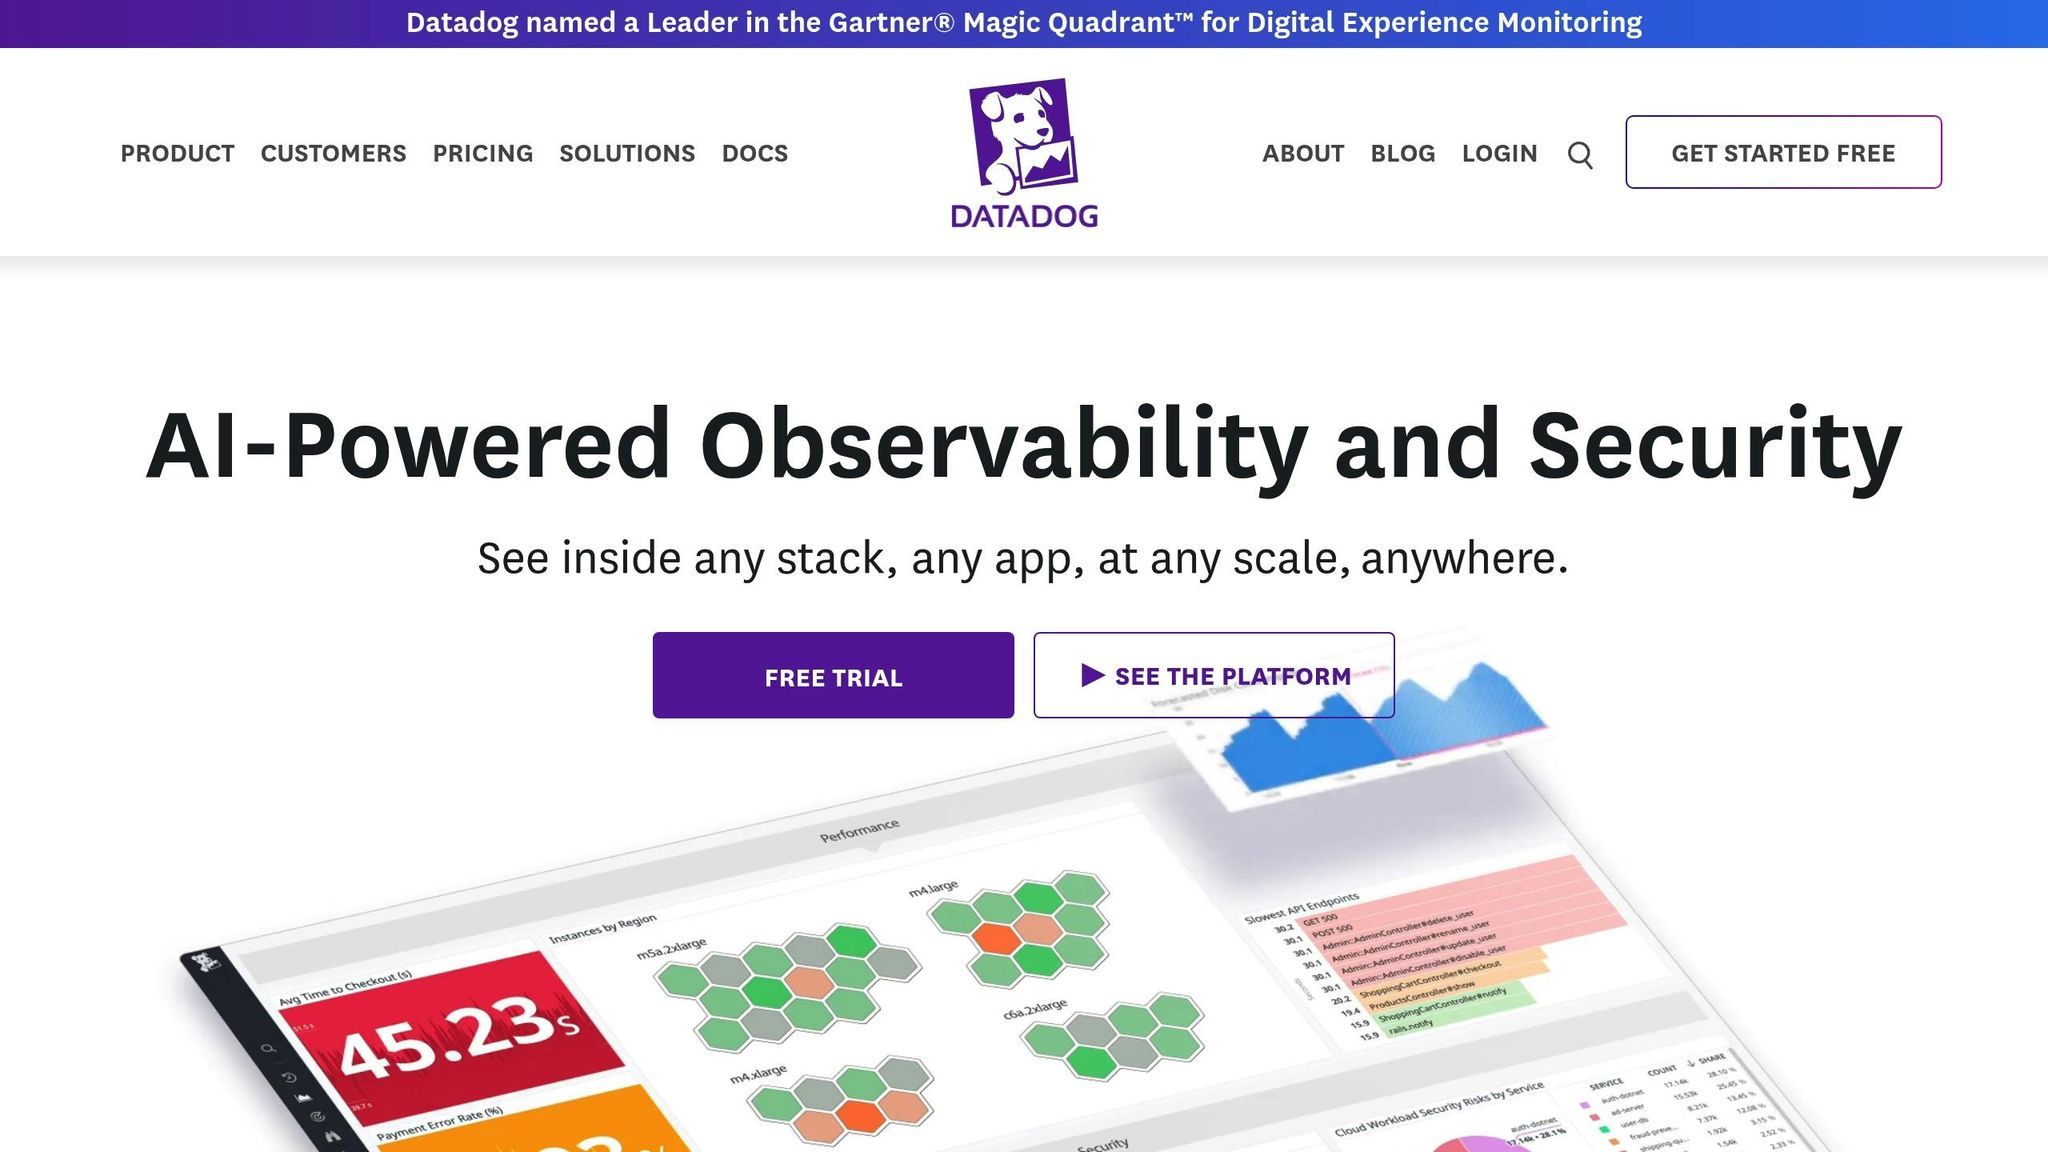
Datadog lleva la monitorización de servidores y VPS a un nuevo nivel al analizar en profundidad el rendimiento a nivel de código. Con su rastreo distribuido basado en IA, te ayuda a identificar los cuellos de botella en el rendimiento y a detectar anomalías en el momento en que se producen. Al conectar los registros de las aplicaciones con las métricas del sistema, Datadog facilita la identificación de las causas raíz de los problemas y su rápida resolución, lo que garantiza el buen funcionamiento de tu infraestructura.
Ámbito de monitorización
Datadog reúne métricas de infraestructura, registros, rastreos y señales de seguridad en una única plataforma de observabilidad. Puede recopilar datos de telemetría de hosts, contenedores, funciones sin servidor, servicios gestionados en la nube y aplicaciones personalizadas. Sus integraciones abarcan cientos de tecnologías, por lo que puedes realizar un seguimiento del comportamiento de las bases de datos, el rendimiento de las API, los clústeres de Kubernetes y las cargas de trabajo nativas de la nube desde una vista unificada. Los datos se recopilan con alta frecuencia y se correlacionan entre métricas, registros y trazas para revelar patrones de rendimiento y cuellos de botella. Este amplio alcance ayuda a los equipos a comprender cómo se comporta cada parte de su pila bajo una carga real.
Capacidades en tiempo real
Datadog ofrece paneles en directo que se actualizan continuamente, mostrando el uso de la CPU, la latencia de las solicitudes, el estado de los contenedores, el rendimiento de la red y mucho más a medida que cambian. Puedes personalizar los paneles para resaltar las señales que importan y facilitar así un diagnóstico rápido. También admite alertas en tiempo real, de modo que problemas como picos de errores o saturación de memoria pueden activar notificaciones tan pronto como se produzcan. Incluso con grandes volúmenes de datos, su agente y su backend SaaS están diseñados para mantener una baja sobrecarga, al tiempo que ofrecen visibilidad al segundo en sistemas distribuidos.
Funciones de IA y automatización
Datadog incluye herramientas basadas en IA que analizan las líneas de referencia históricas para detectar anomalías y reducir el ruido de los falsos positivos. Su suite Bits AI añade clasificación automatizada, correlación entre señales y resúmenes de incidentes para acelerar las investigaciones. Puede sugerir posibles causas raíz, proponer medidas correctivas a nivel de código o de configuración y generar documentación tras los incidentes. También es posible crear flujos de trabajo utilizando lenguaje natural, convirtiendo las tareas operativas rutinarias en secuencias automatizadas sin necesidad de escribir scripts. Esto ayuda a los equipos a optimizar los procesos de respuesta, al tiempo que mantienen el control sobre las vías de escalación.
Facilidad de implementación
Datadog es fácil de implementar gracias a su agente ligero y a su diseño nativo de la nube. Puedes instalar el agente con un único script, utilizar imágenes de Docker o implementarlo a través de Kubernetes con Helm. Sus integraciones detectan automáticamente los servicios y comienzan a recopilar datos de telemetría con una configuración mínima. Como todo se ejecuta en la plataforma alojada de Datadog, no hay que mantener ningún backend. Se adapta fácilmente tanto a entornos híbridos como multicloud, y se escala con una infraestructura en rápida evolución, lo que lo hace adecuado para equipos que desean una visibilidad total sin tener que gestionar su propia pila de monitorización.
Precios
Datadog funciona con un modelo de precios modular, en el que los planes básicos se cobran por host supervisado y las funciones opcionales se facturan según el uso. El nivel Pro parte de unos 15 dólares al mes por host si se factura anualmente, mientras que los planes Enterprise son más caros e incluyen funciones avanzadas de gobernanza e inteligencia artificial. Se aplican cargos adicionales por los registros, los rastros, las pruebas sintéticas, las métricas personalizadas y la retención ampliada. Esto permite a los equipos adoptar solo los componentes que necesitan, aunque los costes pueden aumentar rápidamente en entornos con muchos hosts o con una gran ingesta de registros. Sigue siendo una opción flexible para las organizaciones que desean una observabilidad integral respaldada por una plataforma SaaS madura.
Ventajas e inconvenientes
Tras analizar las características de cada herramienta, vamos a desglosar sus puntos fuertes y sus limitaciones para ayudarte a decidir cuál se adapta mejor a tus necesidades. La elección adecuada dependerá de factores como la funcionalidad, la facilidad de uso y el presupuesto.
Prometheus ofrece un rendimiento excepcional con una recopilación eficiente de datos de series temporales y un lenguaje de consulta robusto (PromQL) diseñado específicamente para entornos nativos de la nube. Sin embargo, carece de herramientas de visualización integradas y de capacidades de almacenamiento a largo plazo, por lo que requiere soluciones externas para estas funciones.
Grafana destaca por su visualización de datos flexible y avanzada, y se integra a la perfección con diversas fuentes de datos, incluido Prometheus, para crear paneles visualmente atractivos. Su principal limitación es la ausencia de recopilación de datos nativa, lo que le obliga a depender de herramientas externas para la ingesta de datos.
Zabbix es una solución de monitorización escalable y completa. Al ser de código abierto, elimina los costes de licencia, pero a menudo exige una configuración más compleja y un mantenimiento continuo, lo que puede requerir muchos recursos.
Netdata destaca por su diseño ligero y su monitorización del rendimiento en tiempo real, y cuenta con un proceso de configuración rápido —que a menudo se completa en cuestión de minutos—. Esto la convierte en una excelente opción para entornos pequeños y medianos. Sin embargo, tiene capacidades limitadas para el análisis de datos históricos a largo plazo y ofrece un sistema de alertas más básico en comparación con las plataformas de nivel empresarial.
Checkmk ofrece una monitorización escalable con métricas en tiempo real y alertas personalizables, lo que la hace ideal para implementaciones de servidores a gran escala. Sin embargo, sus funciones avanzadas conllevan una curva de aprendizaje más pronunciada y una mayor complejidad de configuración a medida que aumenta el tamaño de la implementación.
Datadog ofrece una experiencia de monitorización integral con información basada en inteligencia artificial, que abarca la infraestructura, las aplicaciones y la gestión de registros. Aunque sus funciones son muy amplias, los costes de suscripción pueden acumularse rápidamente (por ejemplo, 15 dólares al mes por host para la infraestructura, con tarifas adicionales para APM y la gestión de registros). Además, dominar sus funcionalidades avanzadas requiere una inversión significativa de tiempo y esfuerzo de aprendizaje.
La siguiente tabla resume las principales ventajas, inconvenientes y estructuras de costes de cada herramienta para facilitar la comparación:
| Herramienta | Puntos fuertes clave | Principales puntos débiles | Estructura de costes |
|---|---|---|---|
| Prometheus | Recopilación eficiente de datos de series temporales y potente lenguaje de consulta | Carece de visualización y almacenamiento integrados | De código abierto (solo hay que asumir los costes operativos) |
| Grafana | Visualización flexible y avanzada con soporte para múltiples fuentes | No dispone de recopilación de datos nativa | Código abierto (solo costes operativos) |
| Zabbix | Supervisión escalable y completa para entornos de TI tradicionales | Configuración y mantenimiento complejos | Gratuito (con costes de alojamiento y mantenimiento) |
| Netdata | Monitorización ligera y en tiempo real con una configuración rápida | Análisis de datos históricos y alertas limitados | A partir de 4,50 dólares estadounidenses por nodo al mes |
| Checkmk | Supervisión escalable con métricas en tiempo real y alertas personalizadas | Curva de aprendizaje pronunciada para las funciones avanzadas | Alrededor de 80 dólares al mes para unos 100 hosts |
| Datadog | Amplia supervisión a escala de nube con análisis basados en IA | Costes más elevados y curva de aprendizaje pronunciada | A partir de 15 dólares al mes por host (más tarifas adicionales) |
En última instancia, tu decisión dependerá de la experiencia y el presupuesto de tu equipo. Las herramientas de código abierto como Prometheus y Zabbix pueden resultar muy eficaces si tu equipo cuenta con los conocimientos técnicos necesarios para gestionarlas. Por otro lado, las opciones comerciales como Checkmk, Netdata y Datadog ofrecen soluciones listas para usar que reducen el esfuerzo interno, pero suelen conllevar unos costes más elevados.
Conclusión
Elegir la herramienta de monitorización adecuada para tu servidor dedicado o VPS en 2025 se reduce a comprender tu entorno específico, tus conocimientos técnicos y tus limitaciones presupuestarias.
Para configuraciones más pequeñas o aquellas que requieran resultados rápidos, Netdata es una opción sólida. Su información en tiempo real y su sencilla configuración la hacen ideal para una monitorización inmediata sin necesidad de una configuración compleja.
Los entornos más grandes y complejos suelen requerir soluciones escalables. Si trabajas con sistemas nativos de la nube o en contenedores, Prometheus y Grafana son excelentes opciones. Combinan una potente recopilación de datos de series temporales con visualizaciones personalizables, aunque requieren un mayor nivel de conocimientos técnicos para gestionarlas de forma eficaz.
Para las empresas, merece la pena considerar Checkmk y Datadog. Checkmk ofrece amplias capacidades de monitorización y puede resultar rentable para implementaciones a gran escala. Por otro lado, Datadog destaca por sus análisis basados en IA y sus amplias integraciones, aunque su escalabilidad puede requerir una planificación de recursos más cuidadosa.
En entornos de TI tradicionales con infraestructuras diversas, Zabbix sigue siendo un firme competidor. Aunque su configuración puede resultar más compleja, sus sólidas funcionalidades y la ausencia de costes de licencia lo hacen atractivo para organizaciones que cuentan con administradores de sistemas dedicados.
En última instancia, la mejor solución de monitorización es aquella que se adapta a la capacidad de tu equipo para gestionarla de forma eficaz. Una herramienta repleta de funciones puede convertirse rápidamente en una carga si desborda tu capacidad operativa. Empezar con una opción ligera como Netdata te permite establecer una base de referencia para la monitorización, con la flexibilidad de adoptar plataformas más completas a medida que crecen tu infraestructura y tu experiencia.
El objetivo es centrarse en una monitorización coherente y útil, en lugar de perseguir todas y cada una de las funciones avanzadas. Al adoptar un enfoque gradual y a medida, podrás asegurarte de que tu estrategia de monitorización evolucione al mismo ritmo que las exigencias de tu entorno de alojamiento.
Preguntas frecuentes
¿Cómo mejorarán la IA y la automatización la supervisión de servidores en 2025, y qué herramientas ofrecen estas funciones?
En 2025, la IA y la automatización están transformando la monitorización de servidores, haciendo que la gestión de servidores dedicados y VPS sea más inteligente, eficiente y ágil. Con sistemas basados en IA, es posible identificar patrones inusuales, anticipar posibles fallos y resolver problemas rutinarios de forma automática. Este enfoque reduce el tiempo de inactividad y aumenta la fiabilidad general de los servidores.
Herramientas como Dynatrace, Logz.io y Datadog están a la vanguardia al incorporar la IA y la automatización. Proporcionan información en tiempo real, detectan anomalías y ofrecen análisis predictivos diseñados específicamente para entornos de alojamiento de alto rendimiento. Estas capacidades garantizan que los servidores funcionen de forma fluida y segura, incluso bajo cargas de trabajo intensas.
¿Qué debo tener en cuenta a la hora de decidir entre herramientas de monitorización de código abierto y de pago para mi servidor o VPS?
A la hora de sopesar tus opciones entre herramientas de monitorización de código abierto y de pago, es fundamental tener en cuenta qué se adapta mejor a tus necesidades y recursos. Las herramientas de código abierto suelen ser gratuitas y ofrecen un alto grado de personalización, lo cual es ideal si dispones de los conocimientos técnicos necesarios y necesitas una solución flexible. Por el contrario, las herramientas de pago suelen contar con interfaces intuitivas, funciones avanzadas y asistencia técnica dedicada, lo que te ayuda a ahorrar tiempo y a simplificar el proceso.
Para tomar la decisión correcta, ten en cuenta algunos factores clave: tu presupuesto, el nivel de asistencia que puedas necesitar, la facilidad de configuración de la herramienta y si esta puede adaptarse a medida que crezcan los requisitos de tu servidor o VPS. Dedicar tiempo a evaluar estos elementos te ayudará a elegir la opción que mejor se ajuste a tus objetivos de monitorización y rendimiento.
¿Cuál es la mejor manera de garantizar que tu solución de monitorización de servidores se adapte a medida que crece tu infraestructura?
Para que tu solución de monitorización se adapte al crecimiento de tu infraestructura, es fundamental centrarse en herramientas y estrategias que hagan hincapié en la escalabilidad y la automatización. Opta por plataformas capaces de gestionar arquitecturas distribuidas, lo que permite una monitorización fluida de múltiples servidores o máquinas virtuales a medida que tu sistema crece. Funciones como los análisis basados en IA y los paneles de control en tiempo real resultan especialmente útiles, ya que pueden gestionar mayores volúmenes de datos y seguir ofreciendo información relevante sin ralentizar el sistema.
También es recomendable elegir herramientas que incluyan alertas personalizables y se integren fácilmente con tus flujos de trabajo actuales. De este modo, podrás detectar y resolver rápidamente los problemas a medida que evoluciona tu infraestructura. Acostúmbrate a evaluar y ajustar periódicamente tu configuración de monitorización para garantizar que siga siendo eficiente y fiable a lo largo de tu proceso de crecimiento.

Cómo alojar modelos de IA de Ollama en servidores dedicados
Descubre cómo alojar modelos de Ollama AI en servidores dedicados para mantener la seguridad de los datos, garantizar la escalabilidad y mejorar el rendimiento.
5 min de lectura - 8 de septiembre de 2025
Cómo instalar y utilizar Redis en un VPS
9 min de lectura - 7 de enero de 2026