
Monitorizar o seu servidor dedicado ou VPS: quais são as opções em 2025?
12 min de leitura - 28 de novembro de 2025
Descubra as melhores ferramentas de monitorização para servidores dedicados e VPS em 2025, com foco na IA, na automatização e na análise em tempo real.
Monitorização do seu servidor dedicado ou VPS: quais são as opções em 2025?
Monitorizar o seu servidor dedicado ou VPS em 2025 significa antecipar-se a potenciais problemas com ferramentas mais inteligentes e eficientes. As soluções modernas recorrem agora à IA, à análise em tempo real e à automatização para prever falhas, acompanhar o desempenho e reduzir o tempo de inatividade. Aqui fica um resumo rápido das principais opções:
- Prometheus + Grafana: dupla de código aberto para recolha de dados de séries temporais e painéis personalizáveis. Excelente para configurações nativas da nuvem.
- Zabbix: Monitorização de nível empresarial com alertas poderosos e mapeamento de dependências para infraestruturas complexas.
- Netdata: monitorização de desempenho leve e em tempo real, com configuração rápida.
- Checkmk: monitorização escalável com deteção automatizada de dispositivos e informações detalhadas.
- Datadog: monitorização centrada na nuvem com funcionalidades baseadas em IA e rastreio aprofundado de aplicações.
Cada ferramenta adapta-se a diferentes necessidades, desde pequenas configurações até grandes empresas. Segue-se uma comparação rápida para o ajudar a decidir:
Comparação rápida
| Ferramenta | Ideal para | Principais funcionalidades | Custo |
|---|---|---|---|
| Prometheus + Grafana | Ambientes nativos da nuvem | Dados de séries temporais, painéis personalizados | Gratuito (auto-hospedado) |
| Zabbix | Configurações complexas de TI | Mapeamento de dependências, com ou sem agente | Gratuito (auto-hospedado) |
| Netdata | Monitorização do desempenho em tempo real | Métricas leves e instantâneas | Gratuito/$4,50 por nó |
| Checkmk | Implementações em grande escala | Detecção automática, amplo âmbito de monitorização | ~80 $/mês (100 hosts) |
| Datadog | Monitorização ao nível da nuvem e das aplicações | Informações baseadas em IA, rastreamento de aplicações, integrações | 15 $+/host/mês |
Escolha com base na dimensão da sua infraestrutura, nos seus conhecimentos técnicos e no seu orçamento. Ferramentas de código aberto como o Prometheus e o Zabbix são económicas, mas exigem mais configuração, enquanto opções pagas como o Datadog oferecem facilidade de utilização com funcionalidades avançadas. Comece em pequena escala e expanda à medida que as suas necessidades crescem.
Guia Completo de Monitorização de Servidores | Curso de Monitorização n.º 2
1. Prometheus e Grafana
O Prometheus e o Grafana, em conjunto, constituem uma das soluções de monitorização de código aberto mais eficazes disponíveis atualmente. O Prometheus centra-se na recolha e armazenamento de dados, enquanto o Grafana transforma esses dados em painéis visualmente intuitivos. Esta combinação proporciona uma forma flexível e económica de monitorizar servidores dedicados e ambientes VPS.
Âmbito do monitorização
O Prometheus é conhecido pela sua capacidade de recolher dados de séries temporais em diversos sistemas. Acompanha métricas-chave como a utilização da CPU, o consumo de memória e a E/S do disco, ao mesmo tempo que lida com estatísticas mais especializadas e específicas de aplicações. Utilizando um modelo baseado em pull, recupera métricas de pontos finais configurados a intervalos regulares, tornando-o adequado para monitorizar tanto configurações em contentores como servidores bare-metal tradicionais.
Para expandir as suas capacidades, o Prometheus suporta inúmeros exportadores oficiais, permitindo-lhe recolher dados de praticamente qualquer serviço ou aplicação em execução na sua infraestrutura.
O Grafana complementa o Prometheus, apresentando estes dados através de painéis personalizáveis. Estes painéis podem incluir gráficos em tempo real, mapas de calor e estados de alerta. Além disso, o Grafana integra dados de várias fontes, proporcionando-lhe uma visão unificada e abrangente do desempenho do seu sistema.
Capacidades em tempo real
O Prometheus recolhe métricas em intervalos que podem ser definidos com uma frequência de apenas alguns segundos, embora o valor predefinido seja normalmente entre 15 e 30 segundos. Por outro lado, os painéis do Grafana atualizam-se automaticamente à medida que chegam novos dados. Pode ajustar os intervalos de atualização de acordo com as suas necessidades, quer seja a cada poucos segundos ou em períodos mais longos. Esta capacidade de resposta rápida é inestimável para monitorizar picos repentinos de tráfego ou estrangulamentos de recursos, garantindo que está sempre a par do desempenho do sistema e pronto para agir em caso de quaisquer problemas.
Funcionalidades de IA/Automação
Embora o Prometheus e o Grafana não sejam, essencialmente, orientados por IA, incluem funcionalidades de automação para melhorar a monitorização. O Prometheus inclui o Alertmanager, que envia notificações com base em condições predefinidas. Este sistema suporta regras de alerta complexas, tirando partido tanto de métricas em tempo real como de dados históricos para garantir a precisão.
O Grafana introduziu ferramentas de deteção de anomalias que utilizam aprendizagem automática para identificar padrões invulgares nas suas métricas. Estas ferramentas ajudam a reduzir os falsos alarmes, aprendendo o comportamento típico do seu sistema. Também podem apoiar a automatização, desencadeando ações como o dimensionamento de recursos ou o alerta a sistemas de orquestração quando os limiares são ultrapassados.
Facilidade de implementação
A configuração do Prometheus e do Grafana é simples. Ambas as ferramentas podem ser executadas em contentores Docker, garantindo instalações consistentes em diferentes sistemas operativos. Com ferramentas como o docker-compose, é possível implementar uma pilha completa de monitorização em apenas alguns minutos.
Para quem utiliza servidores dedicados, ambas as aplicações também podem ser instaladas diretamente através de gestores de pacotes nativos na maioria das distribuições Linux. Mesmo as configurações avançadas são relativamente fáceis de definir e de resolver problemas, tornando esta dupla acessível a utilizadores com diferentes níveis de experiência.
Preços
O Prometheus e o Grafana são totalmente gratuitos e de código aberto, sem taxas de licenciamento, limites de utilizadores ou restrições de retenção de dados. Isto torna-os uma solução económica para monitorizar a sua infraestrutura.
Para quem prefere uma opção gerida, o Grafana oferece um serviço baseado na nuvem. O plano gratuito fornece funcionalidades básicas, enquanto os planos pagos escaláveis incluem funcionalidades e capacidade adicionais. Embora muitos utilizadores considerem que a auto-hospedagem satisfaz as suas necessidades, o serviço gerido é uma alternativa conveniente, especialmente para quem procura simplificar as tarefas de manutenção e suporte.
2. Zabbix
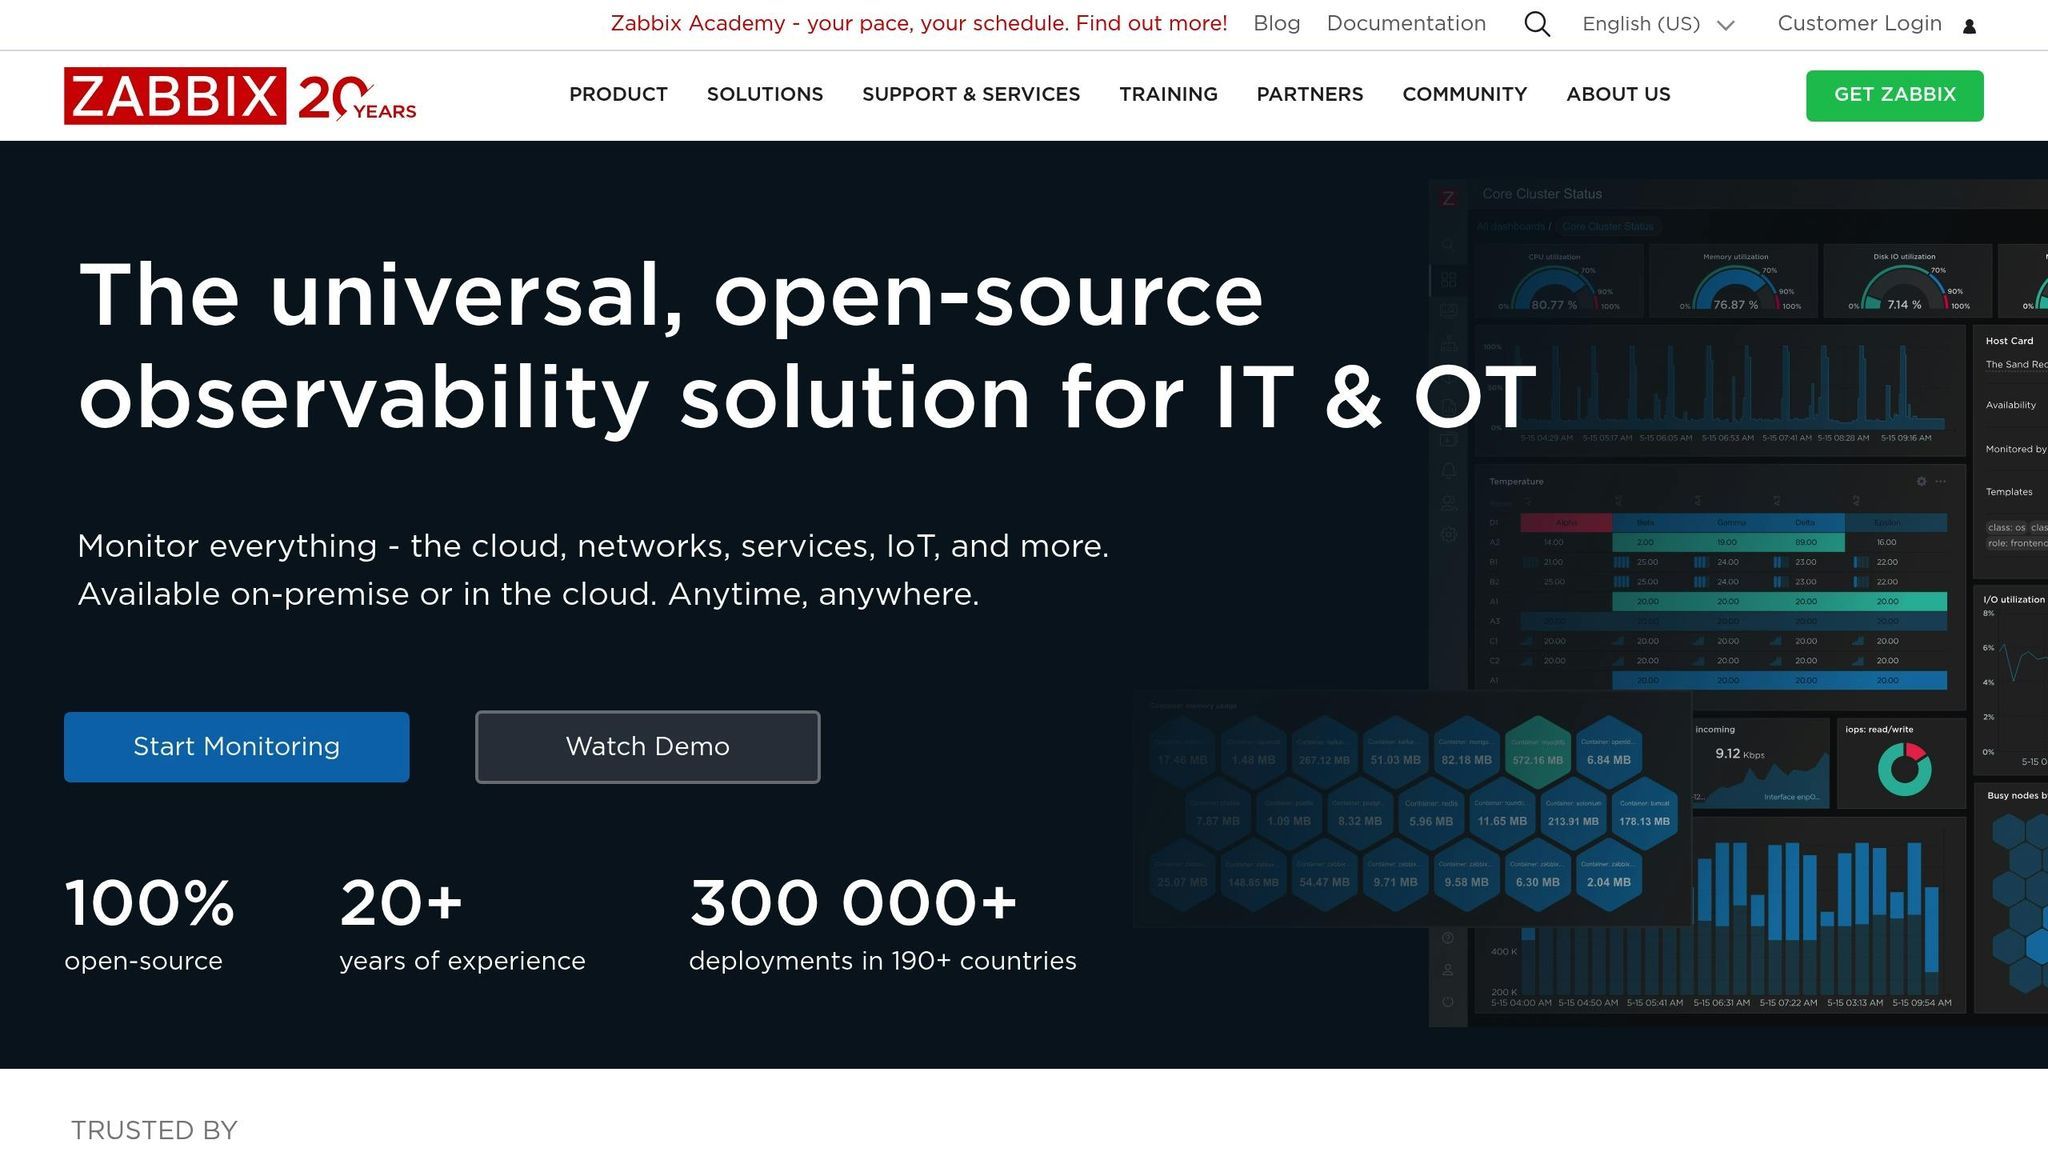
O Zabbix é uma poderosa plataforma de monitorização que tem vindo a ser aperfeiçoada ao longo de duas décadas para satisfazer as necessidades de ambientes de nível empresarial. Oferece uma interface unificada para gerir servidores dedicados e VPS, tornando-o uma escolha fiável para configurações complexas.
Âmbito de monitorização
O Zabbix vai além das métricas básicas do sistema, proporcionando visibilidade sobre dispositivos de rede, aplicações, bases de dados, serviços web e plataformas de virtualização — tudo a partir de um painel centralizado. Quer prefira monitorização com ou sem agente, o Zabbix consegue monitorizar tudo, desde a utilização da CPU e da memória até métricas personalizadas de aplicações.
A plataforma simplifica a gestão em ambientes dinâmicos, detetando automaticamente novos dispositivos e serviços. Suporta a monitorização de dispositivos SNMP, a execução de consultas a bases de dados, a verificação dos tempos de resposta web e a análise de registos em busca de erros.
Uma característica de destaque é a sua capacidade de mapear dependências entre componentes da infraestrutura. Estes mapas de dependências proporcionam uma visão clara de como os servidores, as aplicações e os componentes de rede interagem, facilitando a identificação e a resolução de problemas.
Capacidades em tempo real
O Zabbix recolhe e processa dados de monitorização em intervalos que pode configurar, variando normalmente entre 30 segundos e 5 minutos, dependendo da importância das métricas. A sua interface web inclui painéis em tempo real que se atualizam automaticamente, proporcionando-lhe uma visão sempre atualizada dos seus sistemas.
Pode personalizar a frequência com que as diferentes métricas são recolhidas. Por exemplo, os dados críticos podem ser recolhidos com maior frequência, enquanto as métricas menos essenciais são registadas com menor frequência. Esta flexibilidade garante uma utilização eficiente dos recursos do sistema e do armazenamento.
Funcionalidades preditivas e automatizadas
Utilizando dados históricos, o Zabbix consegue prever tendências para detetar anomalias numa fase precoce. Também automatiza as respostas através da execução de scripts quando são atingidos limiares específicos. Por exemplo, a plataforma pode reiniciar um serviço ou executar um script de manutenção automaticamente quando ocorrem condições predefinidas.
O seu sistema de alertas foi concebido para reduzir a sobrecarga de notificações. Agrupa alertas relacionados e gere dependências, garantindo que apenas são enviadas notificações relevantes através dos canais de comunicação que escolher.
Facilidade de implementação
Embora o Zabbix possa exigir um pouco mais de esforço durante a configuração inicial, suporta vários métodos de implementação, incluindo contentores Docker, dispositivos virtuais e instalações nativas em distribuições Linux populares e sistemas Windows.
Os modelos pré-definidos para aplicações e serviços amplamente utilizados poupam tempo durante a configuração. Além disso, as funcionalidades de deteção automática e registo automático do Zabbix simplificam o processo de configuração da monitorização de novos dispositivos e serviços. É até possível automatizar a implementação de agentes em servidores utilizando ferramentas de gestão de configuração ou as opções integradas do Zabbix.
Preços
O Zabbix é totalmente gratuito e de código aberto, sem taxas de licenciamento nem limites de utilizadores. Para quem necessita de suporte adicional, estão disponíveis pacotes de subscrição comerciais, cujos preços dependem do nível de suporte necessário.
Os principais custos associados ao Zabbix incluem o hardware necessário para o servidor e a base de dados do Zabbix, bem como o tempo despendido na configuração e manutenção. Com as suas funcionalidades abrangentes e sem taxas de licenciamento, o Zabbix continua a ser um forte concorrente no setor do monitorização à medida que nos aproximamos de 2025.
Cansado de implementações lentas ou de limites de largura de banda? A FDC Servers oferece potência dedicada instantânea, alcance global e planos flexíveis concebidos para qualquer escala.
Atualize agora3. Netdata
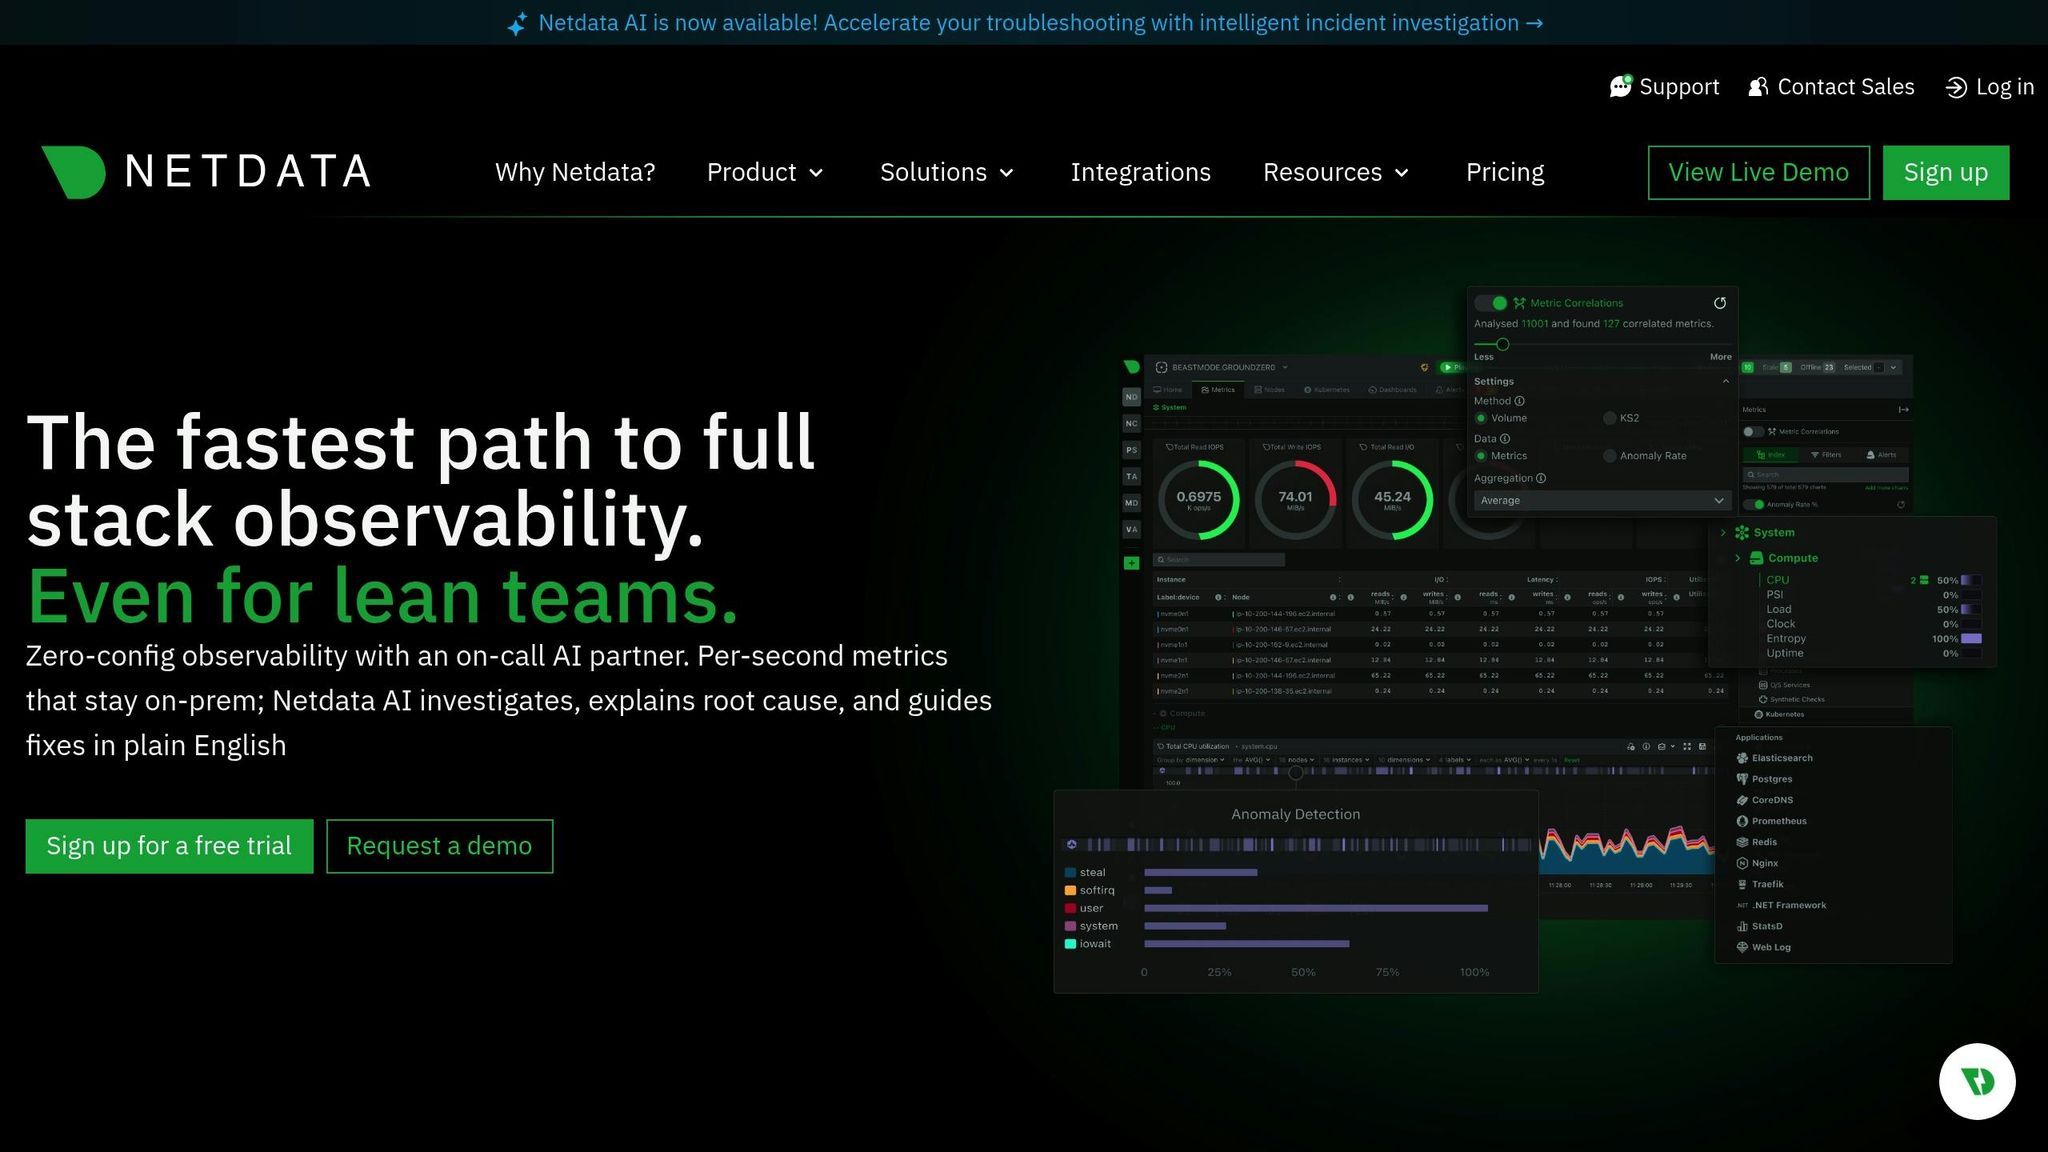
A Netdata é uma ferramenta leve concebida para a monitorização do desempenho em tempo real. A sua capacidade de fornecer informações instantâneas com um impacto mínimo nos recursos do sistema torna-a a escolha ideal para organizações que necessitam de visibilidade imediata da sua infraestrutura.
Âmbito de monitorização
O Netdata monitoriza mais de 800 métricas, abrangendo tudo, desde a utilização da CPU e da memória até à E/S do disco e ao tráfego de rede. Funciona de forma integrada em servidores dedicados e VPS, e fornece até métricas detalhadas de contentores. Ao recolher dados a cada segundo, capta picos e anomalias quase instantaneamente. Esta recolha de dados quase em tempo real complementa as análises históricas mais abrangentes oferecidas por outras ferramentas. Além disso, acompanha automaticamente novos serviços, aplicações e contentores à medida que estes ficam online. Para quem necessita de armazenamento a longo prazo ou de análises mais avançadas, o Netdata pode enviar métricas para plataformas externas, como o Prometheus ou o OpenObserve.
Capacidades em tempo real
O Netdata disponibiliza painéis em tempo real que são atualizados continuamente, proporcionando uma visão em tempo real do estado do seu sistema. Estes painéis são personalizáveis, permitindo-lhe concentrar-se nas métricas mais importantes para uma resolução rápida de problemas. Apesar das suas informações detalhadas, o design leve do Netdata garante que funciona com um consumo mínimo de recursos.
Funcionalidades de IA e automatização
O Netdata utiliza deteção de anomalias baseada em IA para aprender o comportamento normal do seu sistema e sinaliza desvios como potenciais problemas. Inclui também alertas pré-configurados que se adaptam à sua infraestrutura, reduzindo os falsos alarmes ao ter em conta tendências históricas e o contexto. No entanto, o seu sistema de alertas menos centralizado pode exigir integração com ferramentas externas para um encaminhamento de alertas mais complexo ou fluxos de trabalho de escalonamento.
Facilidade de implementação
O Netdata é fácil de configurar, com opções de instalação que vão desde scripts simples até imagens Docker. Suporta tanto ambientes locais como na nuvem, integrando-se facilmente com as pilhas de monitorização existentes. A sua natureza de código aberto permite a personalização sem estar vinculado a um fornecedor específico. Para configurações em contentores, as imagens Docker e os gráficos Helm do Kubernetes simplificam a implementação, enquanto a deteção automática garante que novos serviços e aplicações sejam monitorizados imediatamente.
Preços
O Netdata oferece um plano gratuito «Community» que inclui funcionalidades essenciais como monitorização em tempo real, alertas básicos e um painel web de fácil utilização — ideal para configurações de menor dimensão. Para organizações de maior dimensão ou que necessitem de funcionalidades avançadas, como retenção de dados alargada, alertas melhorados e suporte prioritário, os planos pagos começam nos 4,50 dólares por nó por mês (faturados anualmente). Esta combinação de um nível gratuito robusto e de opções pagas acessíveis mantém o Netdata ao alcance de um vasto leque de utilizadores. A seguir, vamos analisar mais de perto a abordagem do Checkmk ao monitorização.
4. Checkmk
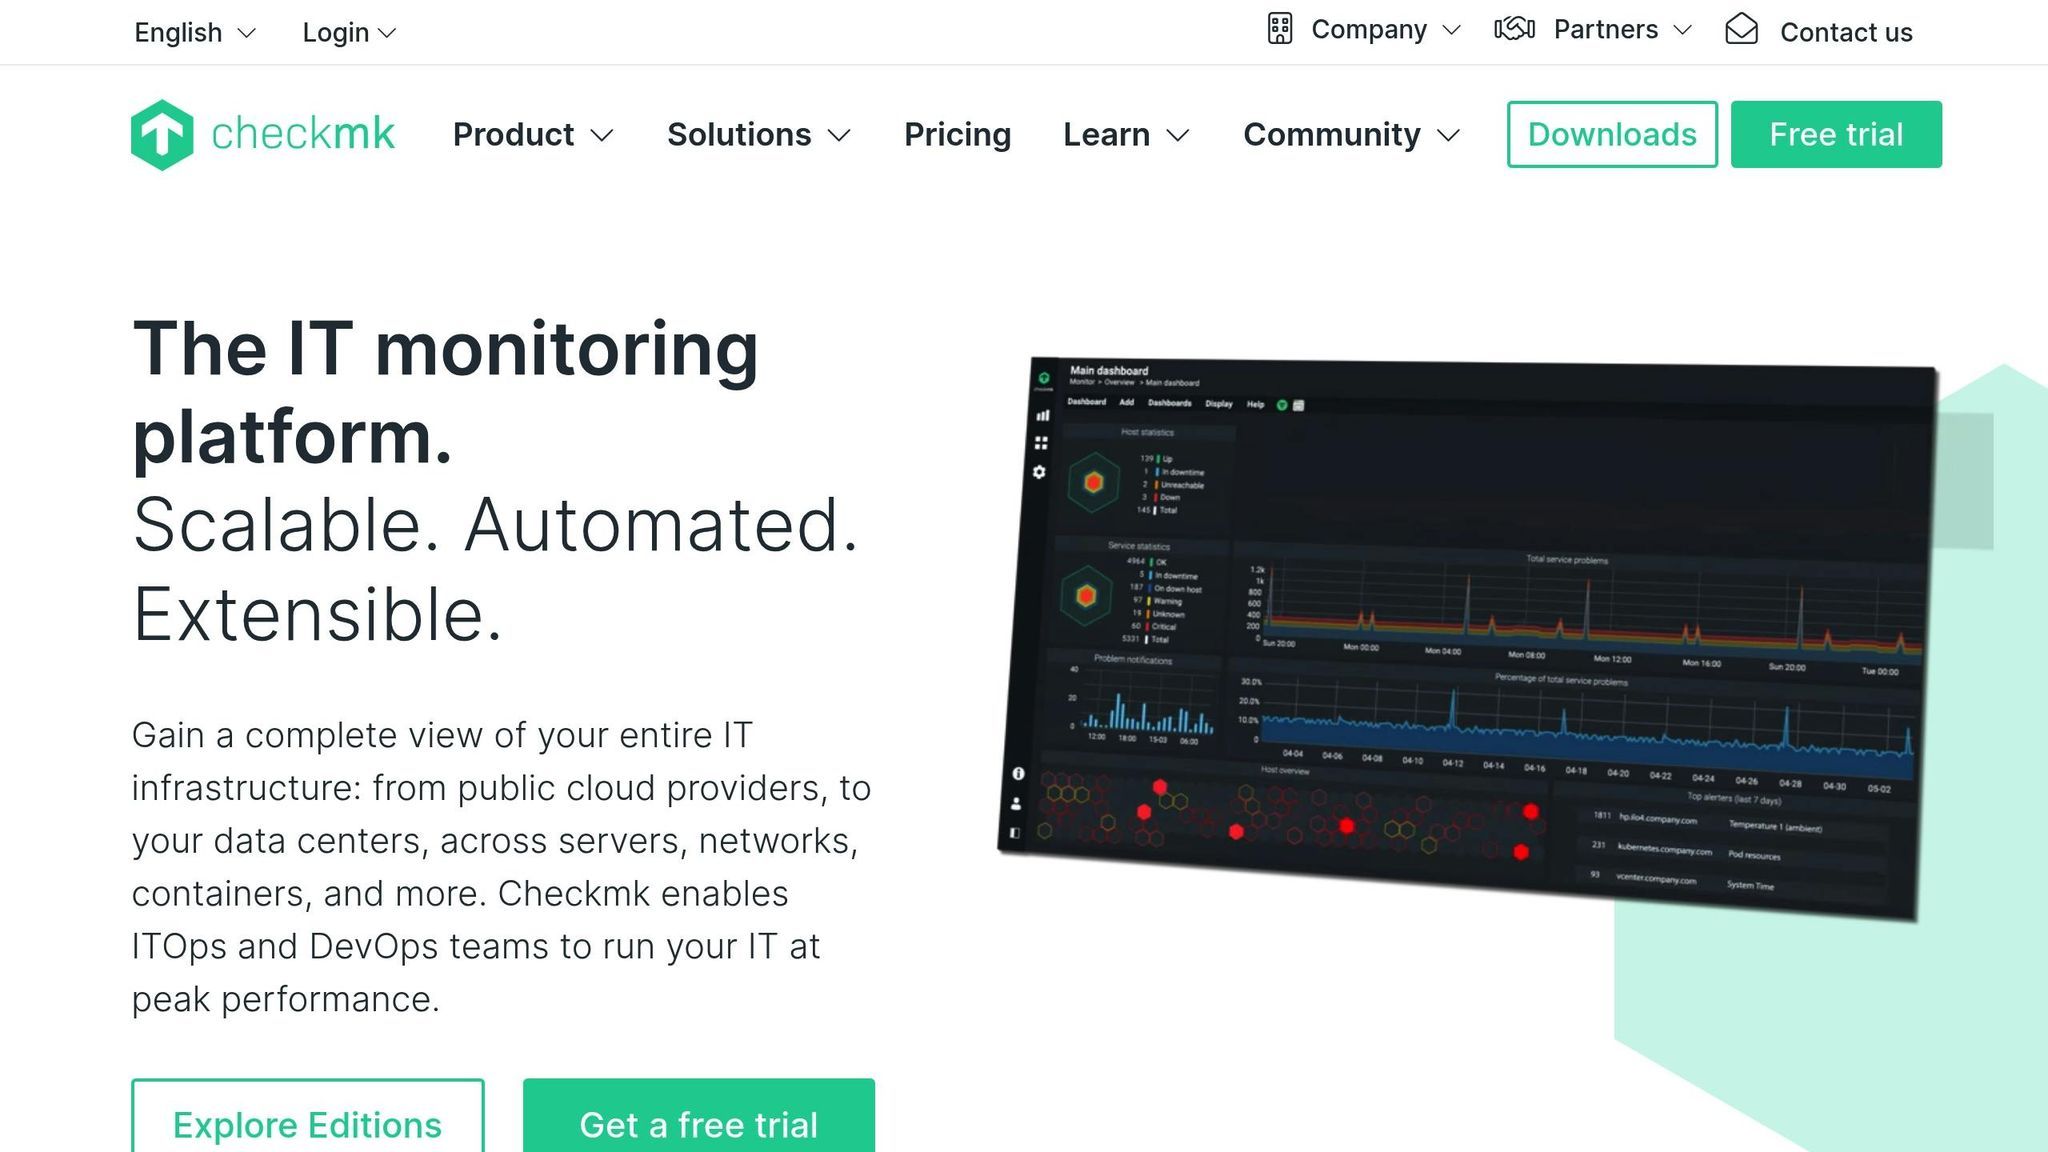
O Checkmk é uma poderosa plataforma de monitorização concebida para gerir servidores dedicados e ambientes VPS. Uma das suas características mais notáveis é a capacidade de detetar e monitorizar automaticamente dispositivos de rede, servidores e serviços à medida que estes ficam online, poupando-lhe o trabalho de ter de os configurar manualmente.
Âmbito de monitorização
O Checkmk abrange uma ampla área de monitorização, acompanhando infraestruturas, redes, aplicações, contentores e serviços na nuvem a partir de uma única plataforma. Oferece verificações aprofundadas de anfitriões e serviços através do seu vasto catálogo de plug-ins de monitorização, permitindo-lhe observar o estado do hardware, bases de dados, sistemas de armazenamento, camadas de virtualização e aplicações personalizadas. Recolhe métricas detalhadas em intervalos curtos e correlaciona alterações de estado entre sistemas para destacar problemas emergentes. O seu design híbrido suporta tanto a monitorização baseada em agente como sem agente, proporcionando flexibilidade em centros de dados, instalações locais e ambientes distribuídos.
Capacidades em tempo real
O Checkmk disponibiliza painéis em tempo real que se atualizam continuamente, apresentando os estados dos anfitriões, as verificações de serviços e as métricas de desempenho à medida que estes se alteram. Suporta sondagens rápidas para anfitriões críticos e pode apresentar gráficos em tempo real relativos à carga, à memória, à rede e ao estado dos aplicativos. Os painéis são personalizáveis, pelo que as equipas podem destacar sistemas prioritários e identificar rapidamente problemas urgentes. O seu núcleo de monitorização eficiente mantém a sobrecarga baixa, mesmo com milhares de verificações por minuto, permitindo que grandes instalações mantenham uma visibilidade responsiva em tempo real.
Funcionalidades de IA e automatização
O Checkmk inclui o ajuste automatizado de limiares e o processamento inteligente de regras que reduzem a fadiga de alertas, adaptando-se ao comportamento de referência. Consegue detetar hosts e serviços automaticamente e aplicar regras de monitorização predefinidas sem necessidade de configuração manual. As funções preditivas apoiam a análise de tendências e o planeamento de capacidade, ajudando as equipas a detetar precocemente riscos de saturação. Para ambientes complexos, o seu sistema de automatização baseado em regras simplifica as atualizações de configuração, a ativação de verificações e a lógica de notificação. Funcionalidades de IA mais avançadas requerem normalmente a integração com ferramentas de análise externas, uma vez que o Checkmk se concentra no monitorização determinística em vez da automatização total de incidentes.
Facilidade de implementação
O Checkmk é simples de implementar, com um processo de instalação rápido e guias de configuração claros. A edição «raw» utiliza componentes de código aberto, enquanto a edição empresarial inclui uma interface de utilizador aperfeiçoada e melhorias de desempenho. Os agentes podem ser instalados com um pequeno script, e a deteção automática identifica novos serviços de imediato. Integra-se bem com ambientes virtualizados e em contentores, e é facilmente escalável através de locais de monitorização distribuídos para implementações de grande dimensão ou multirregionais. Como oferece predefinições robustas logo à partida, as equipas podem colocar um sistema de monitorização completo em funcionamento rapidamente, sem necessidade de ajustes extensivos.
Preços
O Checkmk disponibiliza uma edição «raw» gratuita que inclui monitorização básica, painéis de controlo e alertas, tornando-o adequado para pequenas equipas ou ambientes de laboratório. A edição empresarial acrescenta funcionalidades avançadas, tais como melhor desempenho, automatização alargada, análise preditiva e relatórios de longo prazo. O preço da edição empresarial baseia-se normalmente no número de hosts monitorizados, começando num nível de entrada acessível e escalando para infraestruturas de maior dimensão. Isto mantém os custos globais previsíveis e atrativos para organizações que pretendem um sistema de monitorização potente sem elevadas taxas de utilização ao estilo SaaS.
5. Datadog
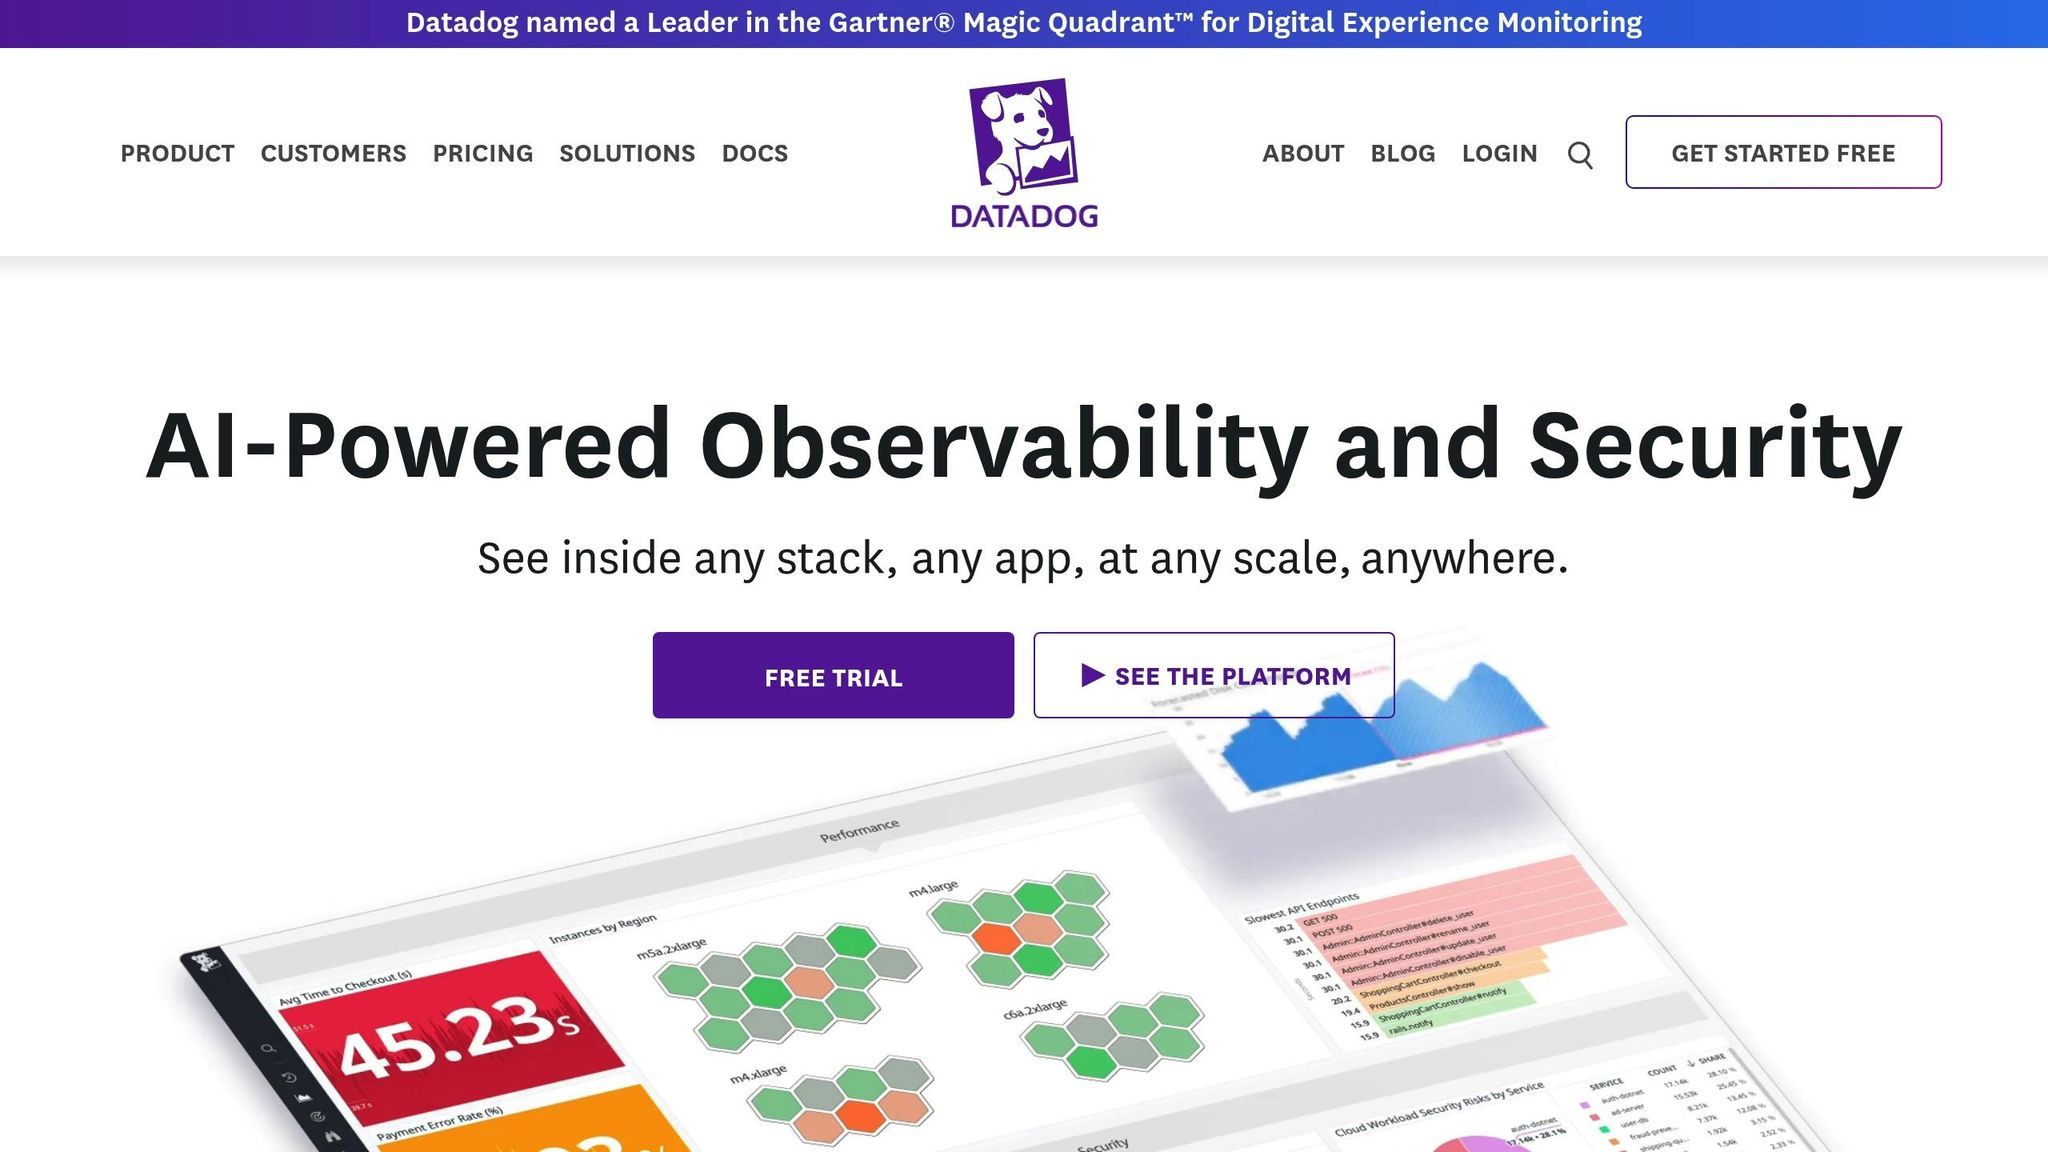
O Datadog eleva a monitorização de servidores e VPS a um novo nível, analisando em profundidade o desempenho ao nível do código. Com o seu rastreio distribuído alimentado por IA, ajuda-o a identificar pontos de estrangulamento no desempenho e a detetar anomalias à medida que estas ocorrem. Ao ligar os registos das aplicações às métricas do sistema, o Datadog facilita a identificação das causas principais dos problemas e a sua resolução rápida, mantendo a sua infraestrutura a funcionar sem problemas.
Âmbito de monitorização
O Datadog reúne métricas de infraestrutura, registos, rastreios e sinais de segurança numa única plataforma de observabilidade. É capaz de recolher telemetria de anfitriões, contentores, funções sem servidor, serviços de nuvem geridos e aplicações personalizadas. As suas integrações abrangem centenas de tecnologias, permitindo-lhe acompanhar o comportamento das bases de dados, o desempenho das APIs, os clusters do Kubernetes e as cargas de trabalho nativas da nuvem a partir de uma vista unificada. Os dados são recolhidos com elevada frequência e correlacionados entre métricas, registos e rastreios para revelar padrões de desempenho e pontos de estrangulamento. Este amplo âmbito ajuda as equipas a compreender como cada parte da sua pilha se comporta sob carga real.
Capacidades em tempo real
O Datadog fornece painéis dinâmicos que se atualizam continuamente, mostrando a utilização da CPU, a latência das solicitações, os estados dos contentores, a largura de banda da rede e muito mais, à medida que estes valores se alteram. Pode personalizar os painéis para destacar os sinais que importam, permitindo um diagnóstico rápido. Também suporta alertas em tempo real, pelo que problemas como picos de erros ou saturação de memória podem desencadear notificações assim que ocorrem. Mesmo com grandes volumes de dados, o seu agente e o backend SaaS foram concebidos para manter a sobrecarga baixa, ao mesmo tempo que proporcionam visibilidade atualizada ao segundo em sistemas distribuídos.
Funcionalidades de IA e automatização
O Datadog inclui ferramentas baseadas em IA que analisam linhas de base históricas para detetar anomalias e reduzir o ruído causado por falsos positivos. O seu conjunto de ferramentas Bits AI adiciona triagem automatizada, correlação entre sinais e resumos de incidentes para acelerar as investigações. Pode sugerir causas prováveis, propor medidas de correção ao nível do código ou da configuração e gerar documentação após os incidentes. Também é possível criar fluxos de trabalho utilizando linguagem natural, transformando tarefas operacionais de rotina em sequências automatizadas sem necessidade de escrever scripts. Isto ajuda as equipas a otimizar os processos de resposta, mantendo ao mesmo tempo o controlo sobre os percursos de escalonamento.
Facilidade de implementação
O Datadog é simples de implementar graças ao seu agente leve e ao seu design nativo da nuvem. Pode instalar o agente com um único script, utilizar imagens Docker ou implementá-lo através do Kubernetes com o Helm. As suas integrações detetam automaticamente os serviços e começam a recolher telemetria com uma configuração mínima. Como tudo é executado na plataforma hospedada do Datadog, não há backend para manter. Adapta-se facilmente a ambientes híbridos e multicloud e escala com infraestruturas em rápida mudança, tornando-o adequado para equipas que pretendem visibilidade total sem terem de gerir a sua própria pilha de monitorização.
Preços
O Datadog funciona com um modelo de preços modular, em que os planos básicos são cobrados por host monitorizado e as funcionalidades opcionais são faturadas consoante a utilização. O nível Pro começa em cerca de 15 dólares por host por mês, quando faturado anualmente, enquanto os planos Enterprise têm um custo mais elevado e incluem funcionalidades avançadas de governação e IA. Aplicam-se custos adicionais a registos, rastreios, testes sintéticos, métricas personalizadas e retenção alargada. Isto permite que as equipas adotem apenas os componentes de que necessitam, embora os custos possam aumentar rapidamente em ambientes com muitos hosts ou com uma elevada ingestão de registos. Continua a ser uma opção flexível para organizações que pretendem uma observabilidade abrangente, suportada por uma plataforma SaaS madura.
Prós e contras
Depois de explorar as funcionalidades de cada ferramenta, vamos analisar os seus pontos fortes e limitações para o ajudar a decidir qual delas se adequa melhor às suas necessidades. A escolha certa dependerá de fatores como funcionalidade, facilidade de utilização e orçamento.
O Prometheus oferece um desempenho excecional com uma recolha eficiente de dados de séries temporais e uma linguagem de consulta robusta (PromQL) adaptada a configurações nativas da nuvem. No entanto, carece de ferramentas de visualização integradas e de capacidades de armazenamento a longo prazo, exigindo soluções externas para estas funcionalidades.
O Grafana destaca-se na visualização de dados flexível e avançada, integrando-se perfeitamente com várias fontes de dados, incluindo o Prometheus, para criar painéis visualmente apelativos. A sua principal limitação é a ausência de recolha de dados nativa, o que o torna dependente de ferramentas externas para a ingestão de dados.
O Zabbix é uma solução de monitorização escalável e abrangente. Por ser de código aberto, elimina os custos de licenciamento, mas exige frequentemente uma configuração mais complexa e manutenção contínua, o que pode consumir muitos recursos.
O Netdata destaca-se pelo seu design leve e pela monitorização de desempenho em tempo real, apresentando um processo de configuração rápido — muitas vezes concluído em poucos minutos. Isto torna-o uma excelente escolha para ambientes de pequena a média dimensão. No entanto, tem capacidades limitadas para a análise de dados históricos a longo prazo e oferece um sistema de alertas mais básico em comparação com plataformas de nível empresarial.
O Checkmk proporciona monitorização escalável com métricas em tempo real e alertas personalizáveis, tornando-o ideal para implementações de servidores em grande escala. As suas funcionalidades avançadas, no entanto, implicam uma curva de aprendizagem mais acentuada e uma maior complexidade de configuração à medida que a dimensão da implementação aumenta.
O Datadog oferece uma experiência de monitorização abrangente com insights baseados em IA, cobrindo infraestrutura, aplicações e gestão de registos. Embora as suas funcionalidades sejam extensas, os custos de subscrição podem aumentar rapidamente (por exemplo, 15 dólares por anfitrião/mês para infraestrutura, com taxas adicionais para APM e gestão de registos). Além disso, dominar as suas funcionalidades avançadas requer um investimento significativo em tempo e aprendizagem.
A tabela abaixo resume as principais vantagens, desvantagens e estruturas de custos de cada ferramenta para uma comparação rápida:
| Ferramenta | Principais pontos fortes | Principais Pontos Fracos | Estrutura de custos |
|---|---|---|---|
| Prometheus | Recolha eficiente de dados de séries temporais e linguagem de consulta poderosa | Carece de funcionalidades integradas de visualização e armazenamento | Código aberto (apenas custos operacionais) |
| Grafana | Visualização flexível e avançada com suporte a múltiplas fontes | Sem recolha de dados nativa | Código aberto (apenas custos operacionais) |
| Zabbix | Monitorização escalável e abrangente para configurações tradicionais de TI | Configuração e manutenção complexas | Gratuito (com custos de alojamento e manutenção) |
| Netdata | Monitorização leve e em tempo real com configuração rápida | Análise de dados históricos e alertas limitados | A partir de 4,50 dólares por nó por mês |
| Checkmk | Monitorização escalável com métricas em tempo real e alertas personalizados | Curva de aprendizagem acentuada para funcionalidades avançadas | Cerca de 80 dólares americanos por mês para cerca de 100 hosts |
| Datadog | Monitorização abrangente à escala da nuvem com análises baseadas em IA | Custos mais elevados e curva de aprendizagem acentuada | A partir de 15 dólares por host/mês (mais taxas adicionais) |
A sua decisão depende, em última análise, da experiência e do orçamento da sua equipa. Ferramentas de código aberto como o Prometheus e o Zabbix podem ser altamente eficazes se a sua equipa tiver os conhecimentos técnicos necessários para as gerir. Por outro lado, opções comerciais como o Checkmk, o Netdata e o Datadog oferecem soluções prontas a utilizar que reduzem o esforço interno, mas que, muitas vezes, acarretam custos mais elevados.
Conclusão
A escolha da ferramenta de monitorização adequada para o seu servidor dedicado ou VPS em 2025 resume-se à compreensão do seu ambiente específico, dos seus conhecimentos técnicos e das suas restrições orçamentais.
Para configurações mais pequenas ou que necessitem de resultados rápidos, o Netdata é uma escolha sólida. As suas informações em tempo real e a configuração simples tornam-no ideal para monitorização imediata, sem exigir uma configuração complexa.
Ambientes maiores e mais complexos exigem frequentemente soluções escaláveis. Se estiver a trabalhar com sistemas nativos da nuvem ou em contentores, o Prometheus e o Grafana são excelentes opções. Combinam uma poderosa recolha de dados em séries temporais com visualizações personalizáveis, embora exijam um nível mais elevado de conhecimentos técnicos para serem geridos de forma eficaz.
Para as empresas, vale a pena considerar o Checkmk e o Datadog. O Checkmk oferece amplas capacidades de monitorização e pode ser económico para implementações em grande escala. Por outro lado, o Datadog destaca-se pelas suas análises baseadas em IA e pelas integrações abrangentes, embora o escalonamento possa exigir um planeamento de recursos mais cuidadoso.
Em ambientes de TI tradicionais com infraestruturas diversificadas, o Zabbix continua a ser um forte candidato. Embora a sua configuração possa ser mais complexa, as suas funcionalidades robustas e a ausência de taxas de licenciamento tornam-no apelativo para organizações com administradores de sistemas dedicados.
Em última análise, a melhor solução de monitorização é aquela que se alinha com a capacidade da sua equipa para a gerir de forma eficaz. Uma ferramenta repleta de funcionalidades pode rapidamente tornar-se um fardo se sobrecarregar a sua capacidade operacional. Começar com uma opção leve como o Netdata permite-lhe estabelecer uma base de referência para a monitorização, com a flexibilidade de adotar plataformas mais abrangentes à medida que a sua infraestrutura e conhecimentos especializados crescem.
O objetivo é concentrar-se num monitorização consistente e que permita agir, em vez de perseguir todas as funcionalidades avançadas. Ao adotar uma abordagem gradual e personalizada, pode garantir que a sua estratégia de monitorização evolui a par das exigências do seu ambiente de alojamento.
Perguntas frequentes
De que forma a IA e a automação irão melhorar a monitorização de servidores em 2025 e quais são as ferramentas que oferecem estas funcionalidades?
Em 2025, a IA e a automação estão a transformar a monitorização de servidores, tornando a gestão de servidores dedicados e VPS mais inteligente, eficiente e ágil. Com sistemas baseados em IA, é possível identificar padrões invulgares, antecipar potenciais falhas e resolver problemas de rotina automaticamente. Esta abordagem reduz o tempo de inatividade e aumenta a fiabilidade geral dos servidores.
Ferramentas como o Dynatrace, o Logz.io e o Datadog estão na vanguarda ao incorporarem IA e automação. Fornecem informações em tempo real, detetam anomalias e oferecem análises preditivas especificamente concebidas para ambientes de alojamento de alto desempenho. Estas capacidades garantem que os servidores funcionem de forma suave e segura, mesmo sob cargas de trabalho intensas.
O que devo ter em conta ao escolher entre ferramentas de monitorização de código aberto e pagas para o meu servidor ou VPS?
Ao ponderar as suas opções entre ferramentas de monitorização de código aberto e pagas, é essencial considerar o que melhor se adapta às suas necessidades e recursos. As ferramentas de código aberto são normalmente gratuitas e oferecem um elevado grau de personalização, o que é ideal se tiver conhecimentos técnicos e precisar de uma solução flexível. Em contrapartida, as ferramentas pagas vêm frequentemente com interfaces intuitivas, funcionalidades avançadas e suporte dedicado, ajudando-o a poupar tempo e a simplificar o processo.
Para fazer a escolha certa, tenha em conta alguns fatores-chave: o seu orçamento, o nível de suporte de que poderá necessitar, a facilidade de configuração da ferramenta e se esta é capaz de acompanhar o crescimento dos requisitos do seu servidor ou VPS. Dedicar algum tempo a avaliar estes elementos irá ajudá-lo a escolher a opção que melhor se alinha com os seus objetivos de monitorização e desempenho.
Qual é a melhor forma de garantir que a sua solução de monitorização de servidores se adapta à medida que a sua infraestrutura cresce?
Para manter a sua solução de monitorização a par da sua infraestrutura em expansão, é essencial concentrar-se em ferramentas e estratégias que privilegiem a escalabilidade e a automatização. Opte por plataformas capazes de lidar com arquiteturas distribuídas, permitindo uma monitorização fluida de vários servidores ou máquinas virtuais à medida que o seu sistema cresce. Funcionalidades como análises baseadas em IA e painéis em tempo real são particularmente úteis — conseguem lidar com volumes de dados maiores e, mesmo assim, fornecer informações significativas sem perder velocidade.
Também é sensato escolher ferramentas que incluam alertas personalizáveis e se integrem facilmente nos seus fluxos de trabalho atuais. Desta forma, poderá identificar e resolver rapidamente os problemas à medida que a sua infraestrutura evolui. Crie o hábito de avaliar e ajustar regularmente a sua configuração de monitorização para garantir que esta se mantém eficiente e fiável ao longo do seu percurso de crescimento.

Como alojar modelos de IA da Ollama em servidores dedicados
Saiba como alojar modelos de IA da Ollama em servidores dedicados para manter a segurança dos dados, garantir a escalabilidade e melhorar o desempenho.
5 min de leitura - 8 de setembro de 2025
Como instalar e utilizar o Redis num VPS
9 min de leitura - 7 de janeiro de 2026