
Monitorowanie serwera dedykowanego lub VPS – jakie są możliwości w 2025 roku?
12 min czytania - 28 listopada 2025
Zapoznaj się z najlepszymi narzędziami do monitorowania serwerów dedykowanych i VPS w 2025 r., skupiając się na sztucznej inteligencji, automatyzacji i analityce w czasie rzeczywistym.
Monitorowanie serwera dedykowanego lub VPS – jakie są możliwości w 2025 roku?
Monitorowanie serwera dedykowanego lub VPS w 2025 r. polega przede wszystkim na wyprzedzaniu potencjalnych problemów dzięki inteligentniejszym i wydajniejszym narzędziom. Nowoczesne rozwiązania wykorzystują obecnie sztuczną inteligencję, analizę w czasie rzeczywistym oraz automatyzację w celu przewidywania awarii, śledzenia wydajności i ograniczania przestojów. Oto krótkie zestawienie najlepszych opcji:
- Prometheus + Grafana: duet oprogramowania open source do gromadzenia danych szeregów czasowych i tworzenia dostosowywalnych pulpitów nawigacyjnych. Doskonałe rozwiązanie dla środowisk natywnych dla chmury.
- Zabbix: monitorowanie klasy korporacyjnej z zaawansowanymi alertami i mapowaniem zależności dla złożonych infrastruktur.
- Netdata: Lekki system monitorowania wydajności w czasie rzeczywistym, charakteryzujący się szybką konfiguracją.
- Checkmk: Skalowalne monitorowanie z automatycznym wykrywaniem urządzeń i szczegółowymi analizami.
- Datadog: monitorowanie zorientowane na chmurę z funkcjami opartymi na sztucznej inteligencji oraz dogłębnym śledzeniem aplikacji.
Każde z tych narzędzi odpowiada innym potrzebom – od małych instalacji po duże przedsiębiorstwa. Poniżej znajduje się krótkie porównanie, które pomoże Ci podjąć decyzję:
Krótkie porównanie
| Narzędzie | Najlepsze zastosowanie | Najważniejsze funkcje | Koszt |
|---|---|---|---|
| Prometheus + Grafana | Środowiska natywne dla chmury | Dane szeregów czasowych, niestandardowe pulpity nawigacyjne | Bezpłatne (własny hosting) |
| Zabbix | Złożone konfiguracje IT | Mapowanie zależności, oparte na agentach/bezagentowe | Bezpłatne (hostowane we własnym zakresie) |
| Netdata | Monitorowanie wydajności w czasie rzeczywistym | Lekkie, natychmiastowe wskaźniki | Bezpłatne/4,50 USD za węzeł |
| Checkmk | Wdrożenia na dużą skalę | Automatyczne wykrywanie, szeroki zakres monitorowania | ~80 USD/miesiąc (100 hostów) |
| Datadog | Monitorowanie w chmurze i na poziomie aplikacji | Wnioski oparte na sztucznej inteligencji, śledzenie aplikacji, integracje | 15 USD+/host/miesiąc |
Wybierz rozwiązanie w oparciu o wielkość swojej infrastruktury, wiedzę techniczną i budżet. Narzędzia open source, takie jak Prometheus i Zabbix, są opłacalne, ale wymagają więcej pracy przy konfiguracji, podczas gdy płatne opcje, takie jak Datadog, oferują łatwość użytkowania i zaawansowane funkcje. Zacznij od niewielkiej skali i rozszerzaj ją w miarę wzrostu potrzeb.
Kompleksowy przewodnik po monitorowaniu serwerów | Kurs monitorowania nr 2
1. Prometheus i Grafana
Prometheus i Grafana razem tworzą jedno z najskuteczniejszych rozwiązań do monitorowania typu open source dostępnych obecnie na rynku. Prometheus skupia się na gromadzeniu i przechowywaniu danych, podczas gdy Grafana przekształca te dane w intuicyjne wizualnie pulpity nawigacyjne. To połączenie zapewnia elastyczny i ekonomiczny sposób monitorowania serwerów dedykowanych oraz środowisk VPS.
Zakres monitorowania
Prometheus jest dobrze znany ze swojej zdolności do gromadzenia danych szeregów czasowych z różnych systemów. Śledzi kluczowe wskaźniki, takie jak wykorzystanie procesora, zużycie pamięci i operacje wejścia/wyjścia na dysku, obsługując jednocześnie bardziej specjalistyczne statystyki specyficzne dla poszczególnych aplikacji. Wykorzystując model oparty na pobieraniu danych (pull), pobiera wskaźniki ze skonfigurowanych punktów końcowych w regularnych odstępach czasu, dzięki czemu nadaje się do monitorowania zarówno środowisk kontenerowych, jak i tradycyjnych serwerów typu bare-metal.
Aby rozszerzyć swoje możliwości, Prometheus obsługuje liczne oficjalne eksportery, co pozwala mu gromadzić dane z niemal każdej usługi lub aplikacji działającej w Twojej infrastrukturze.
Grafana uzupełnia Prometheusa, prezentując te dane za pomocą konfigurowalnych pulpitów nawigacyjnych. Pulpity te mogą zawierać wykresy w czasie rzeczywistym, mapy cieplne oraz stany alertów. Ponadto Grafana integruje dane z wielu źródeł, zapewniając ujednolicony i kompleksowy obraz wydajności systemu.
Funkcje czasu rzeczywistego
Prometheus gromadzi metryki w odstępach czasu, które można ustawić nawet co kilka sekund, choć domyślnie wynoszą one zazwyczaj od 15 do 30 sekund. Z kolei pulpity nawigacyjne Grafany odświeżają się automatycznie w miarę napływania nowych danych. Można dostosować częstotliwość odświeżania do własnych potrzeb, niezależnie od tego, czy ma to być co kilka sekund, czy w dłuższych odstępach czasu. Ta szybka reakcja jest nieoceniona przy śledzeniu nagłych wzrostów ruchu lub wąskich gardeł w zasobach, zapewniając stały dostęp do aktualnych informacji o wydajności systemu i gotowość do podjęcia działań w przypadku jakichkolwiek problemów.
Funkcje AI i automatyzacji
Chociaż Prometheus i Grafana nie są oparte przede wszystkim na sztucznej inteligencji, zawierają one funkcje automatyzacji usprawniające monitorowanie. Prometheus zawiera Alertmanager, który wysyła powiadomienia na podstawie z góry zdefiniowanych warunków. System ten obsługuje złożone reguły alertów, wykorzystując zarówno metryki w czasie rzeczywistym, jak i dane historyczne w celu zapewnienia dokładności.
Grafana wprowadziła narzędzia do wykrywania anomalii, które wykorzystują uczenie maszynowe do wykrywania nietypowych wzorców w metrykach. Narzędzia te pomagają ograniczyć liczbę fałszywych alarmów poprzez uczenie się typowego zachowania systemu. Mogą one również wspierać automatyzację, uruchamiając działania takie jak skalowanie zasobów lub powiadamianie systemów koordynujących w przypadku przekroczenia progów.
Łatwość wdrożenia
Konfiguracja Prometheusa i Grafany jest prosta. Oba narzędzia mogą działać w kontenerach Docker, co zapewnia spójność instalacji na różnych systemach operacyjnych. Dzięki narzędziom takim jak docker-compose można wdrożyć pełny stos monitorujący w zaledwie kilka minut.
W przypadku użytkowników korzystających z serwerów dedykowanych obie aplikacje można również zainstalować bezpośrednio za pomocą natywnych menedżerów pakietów w większości dystrybucji systemu Linux. Nawet zaawansowane konfiguracje są stosunkowo łatwe do skonfigurowania i naprawienia, dzięki czemu ten duet jest dostępny dla użytkowników o różnym poziomie wiedzy.
Ceny
Prometheus i Grafana są całkowicie bezpłatne i oparte na otwartym kodzie źródłowym, bez opłat licencyjnych, limitów użytkowników ani ograniczeń dotyczących przechowywania danych. To sprawia, że są one opłacalnym rozwiązaniem do monitorowania infrastruktury.
Dla tych, którzy preferują opcję zarządzaną, Grafana oferuje usługę w chmurze. Bezpłatny poziom zapewnia podstawową funkcjonalność, natomiast skalowalne plany płatne obejmują dodatkowe funkcje i pojemność. Chociaż wielu użytkowników uważa, że samodzielne hostowanie spełnia ich potrzeby, usługa zarządzana stanowi wygodną alternatywę, zwłaszcza dla tych, którzy chcą uprościć zadania związane z konserwacją i wsparciem technicznym.
2. Zabbix
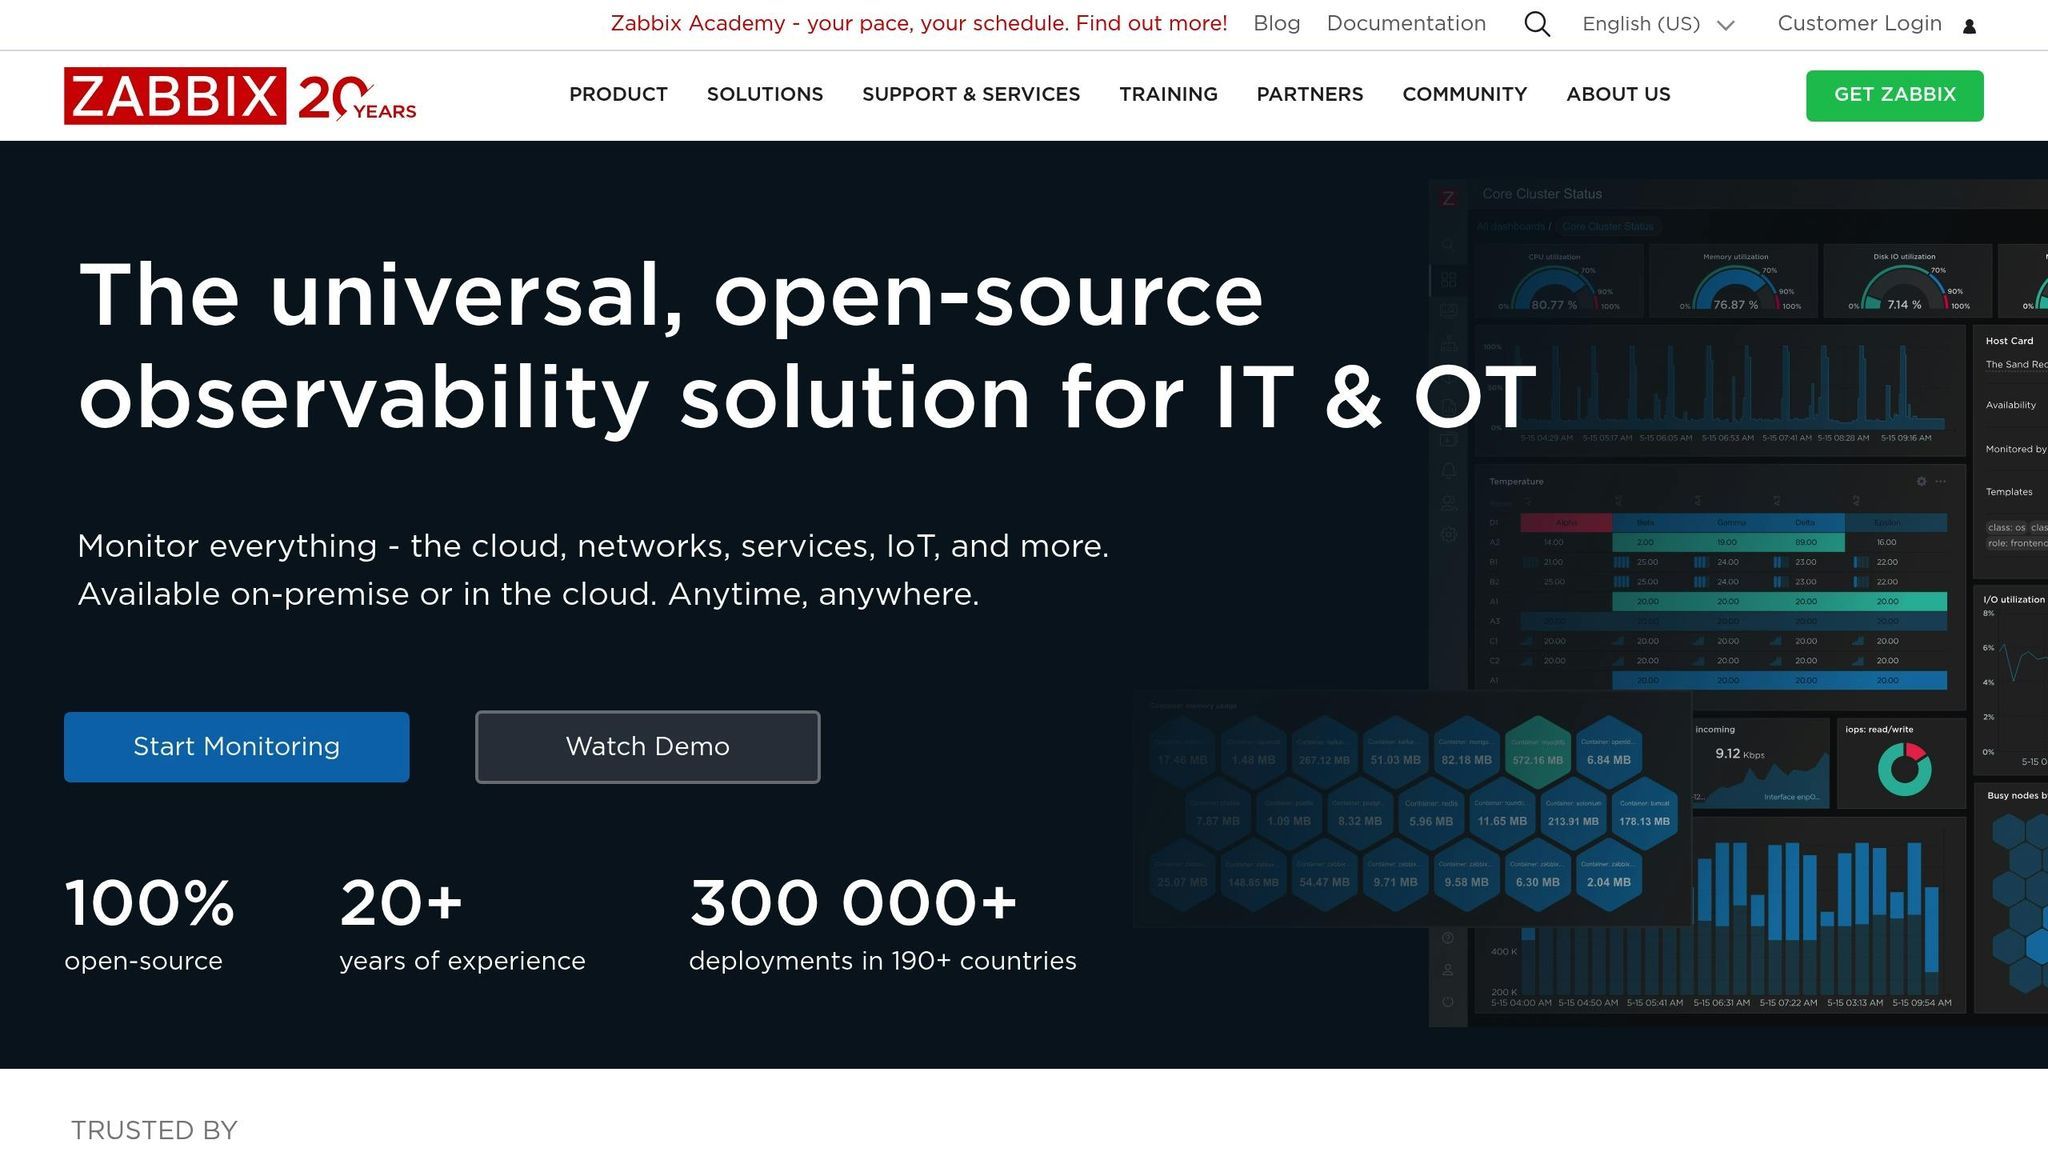
Zabbix to potężna platforma monitorująca, która przez ponad dwie dekady była udoskonalana, aby sprostać wymaganiom środowisk korporacyjnych. Oferuje ujednolicony interfejs do zarządzania serwerami dedykowanymi i VPS, co czyni ją niezawodnym wyborem w przypadku złożonych konfiguracji.
Zakres monitorowania
Zabbix wykracza poza podstawowe wskaźniki systemowe, zapewniając wgląd w urządzenia sieciowe, aplikacje, bazy danych, usługi internetowe i platformy wirtualizacyjne – a wszystko to z jednego, scentralizowanego pulpitu nawigacyjnego. Niezależnie od tego, czy preferujesz monitorowanie oparte na agentach, czy bezagentowe, Zabbix może śledzić wszystko – od wykorzystania procesora i pamięci po niestandardowe wskaźniki aplikacji.
Platforma upraszcza zarządzanie w dynamicznych środowiskach poprzez automatyczne wykrywanie nowych urządzeń i usług. Obsługuje monitorowanie urządzeń SNMP, wykonywanie zapytań do baz danych, sprawdzanie czasów odpowiedzi stron internetowych oraz skanowanie logów w poszukiwaniu błędów.
Wyróżniającą się funkcją jest możliwość mapowania zależności między komponentami infrastruktury. Te mapy zależności zapewniają przejrzysty obraz interakcji między serwerami, aplikacjami i komponentami sieciowymi, ułatwiając identyfikację i rozwiązywanie problemów.
Funkcje działające w czasie rzeczywistym
Zabbix gromadzi i przetwarza dane monitorujące w odstępach czasu, które można skonfigurować, zazwyczaj w zakresie od 30 sekund do 5 minut, w zależności od ważności wskaźników. Jego interfejs internetowy zawiera pulpity nawigacyjne na żywo, które aktualizują się automatycznie, zapewniając zawsze aktualny obraz systemów.
Można dostosować częstotliwość zbierania różnych wskaźników. Na przykład dane krytyczne mogą być gromadzone częściej, podczas gdy mniej istotne wskaźniki są rejestrowane rzadziej. Ta elastyczność zapewnia efektywne wykorzystanie zasobów systemowych i pamięci masowej.
Funkcje predykcyjne i automatyczne
Wykorzystując dane historyczne, Zabbix może prognozować trendy w celu wczesnego wykrywania anomalii. Automatyzuje również reakcje poprzez uruchamianie skryptów po osiągnięciu określonych progów. Na przykład platforma może automatycznie zrestartować usługę lub uruchomić skrypt konserwacyjny, gdy wystąpią z góry zdefiniowane warunki.
Jej system alertów został zaprojektowany tak, aby ograniczyć nadmiar powiadomień. Grupuje on powiązane alerty i zarządza zależnościami, zapewniając, że tylko istotne powiadomienia są wysyłane za pośrednictwem wybranych kanałów komunikacyjnych.
Łatwość wdrożenia
Chociaż Zabbix może wymagać nieco więcej wysiłku podczas wstępnej konfiguracji, obsługuje różne metody wdrażania, w tym kontenery Docker, urządzenia wirtualne oraz instalacje natywne na popularnych dystrybucjach systemu Linux i systemach Windows.
Gotowe szablony dla powszechnie używanych aplikacji i usług pozwalają zaoszczędzić czas podczas konfiguracji. Ponadto funkcje automatycznego wykrywania i rejestracji Zabbixa upraszczają proces konfiguracji monitorowania nowych urządzeń i usług. Można nawet zautomatyzować wdrażanie agentów na serwerach za pomocą narzędzi do zarządzania konfiguracją lub wbudowanych opcji Zabbixa.
Ceny
Zabbix jest całkowicie darmowy i oparty na otwartym kodzie źródłowym, bez opłat licencyjnych ani limitów użytkowników. Dla osób potrzebujących dodatkowego wsparcia dostępne są komercyjne pakiety subskrypcyjne, których ceny zależą od wymaganego poziomu wsparcia.
Główne koszty związane z Zabbixem obejmują sprzęt niezbędny do obsługi serwera Zabbix i bazy danych, a także czas poświęcony na konfigurację i konserwację. Dzięki bogatemu zestawowi funkcji i braku opłat licencyjnych Zabbix pozostaje silnym graczem na rynku rozwiązań monitorujących w miarę zbliżania się roku 2025.
Masz dość powolnego wdrażania rozwiązań lub ograniczeń przepustowości? FDC Servers oferuje natychmiastowy dostęp do dedykowanych zasobów, globalny zasięg oraz elastyczne plany dostosowane do każdej skali działalności.
Zaktualizuj teraz3. Netdata
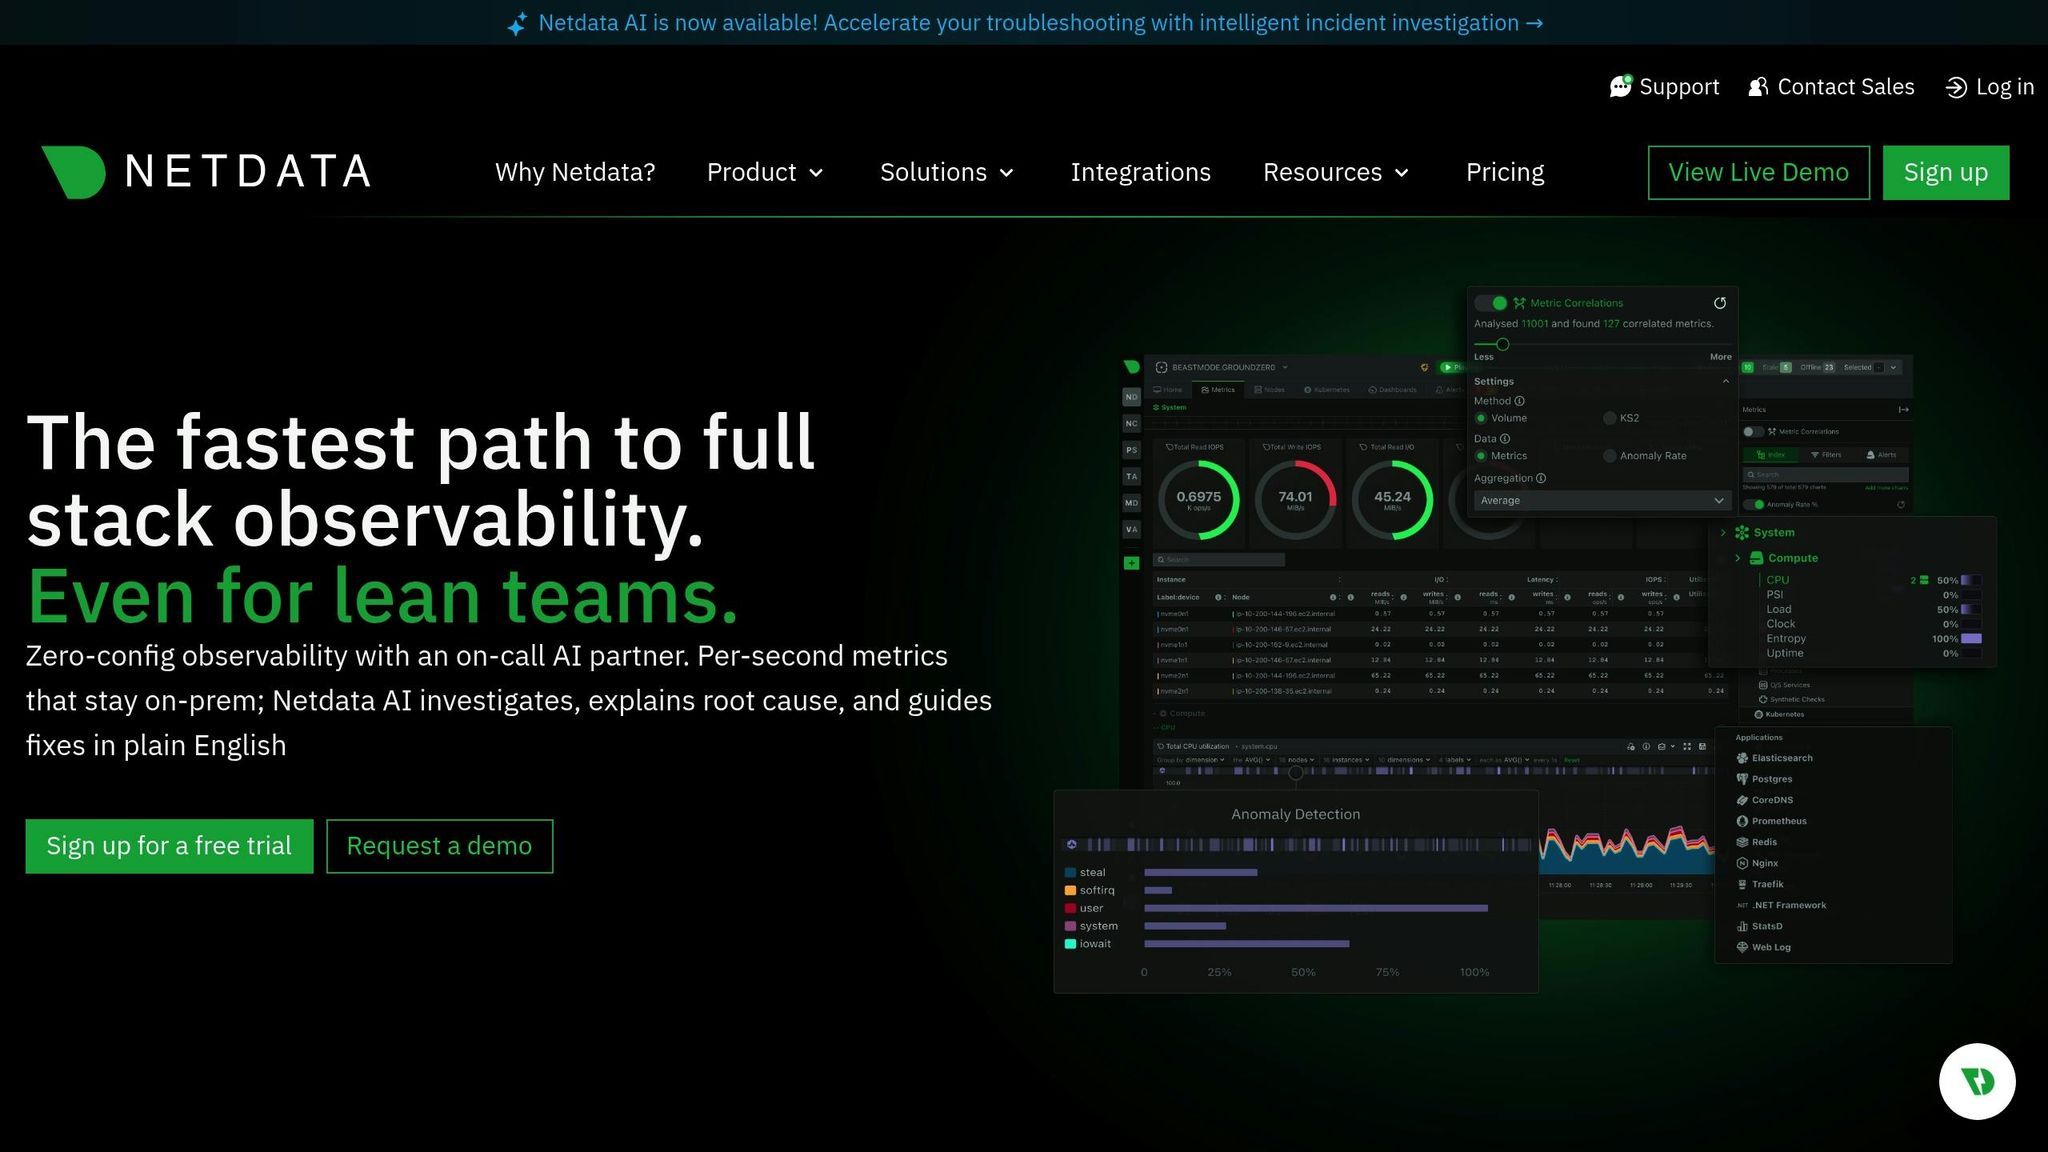
Netdata to lekkie narzędzie przeznaczone do monitorowania wydajności w czasie rzeczywistym. Jego zdolność do dostarczania natychmiastowych informacji przy minimalnym obciążeniu zasobów systemowych sprawia, że jest to najlepszy wybór dla organizacji potrzebujących natychmiastowego wglądu w swoją infrastrukturę.
Zakres monitorowania
Netdata monitoruje ponad 800 wskaźników, obejmujących wszystko — od wykorzystania procesora i pamięci po operacje wejścia/wyjścia na dysku oraz ruch sieciowy. Działa płynnie na serwerach dedykowanych i VPS, a nawet zapewnia szczegółowe wskaźniki dotyczące kontenerów. Gromadząc dane co sekundę, niemal natychmiast rejestruje skoki i anomalie. To gromadzenie danych niemal w czasie rzeczywistym stanowi uzupełnienie bardziej rozbudowanych analiz historycznych oferowanych przez inne narzędzia. Automatycznie śledzi również nowe usługi, aplikacje i kontenery w miarę ich uruchamiania. Dla tych, którzy potrzebują długoterminowego przechowywania danych lub bardziej zaawansowanej analizy, Netdata może przesyłać wskaźniki do zewnętrznych platform, takich jak Prometheus czy OpenObserve.
Funkcje w czasie rzeczywistym
Netdata udostępnia pulpity nawigacyjne działające w czasie rzeczywistym, które są stale odświeżane, zapewniając podgląd stanu systemu na żywo. Pulpity te można dostosowywać, co pozwala skupić się na wskaźnikach, które mają największe znaczenie dla szybkiego rozwiązywania problemów. Pomimo szczegółowych informacji, lekka konstrukcja Netdata zapewnia działanie przy minimalnym zużyciu zasobów.
Funkcje sztucznej inteligencji i automatyzacji
Netdata wykorzystuje oparte na sztucznej inteligencji wykrywanie anomalii, aby nauczyć się normalnego zachowania systemu i oznaczać odchylenia jako potencjalne problemy. Zawiera również wstępnie skonfigurowane alerty, które dostosowują się do infrastruktury użytkownika, ograniczając liczbę fałszywych alarmów poprzez uwzględnienie trendów historycznych i kontekstu. Jednak mniej scentralizowany system alertów może wymagać integracji z narzędziami zewnętrznymi w celu zapewnienia bardziej złożonego routingu alertów lub procesów eskalacji.
Łatwość wdrożenia
Netdata jest łatwa w konfiguracji, a opcje instalacji obejmują zarówno proste skrypty, jak i obrazy Docker. Obsługuje zarówno środowiska lokalne, jak i chmurowe, płynnie integrując się z istniejącymi stosami monitorującymi. Jej charakter open source pozwala na dostosowanie do własnych potrzeb bez uzależnienia od konkretnego dostawcy. W przypadku konfiguracji kontenerowych obrazy Docker i wykresy Helm dla Kubernetes upraszczają wdrożenie, a funkcja automatycznego wykrywania zapewnia natychmiastowe monitorowanie nowych usług i aplikacji.
Ceny
Netdata oferuje bezpłatny plan Community, który obejmuje podstawowe funkcje, takie jak monitorowanie w czasie rzeczywistym, podstawowe powiadomienia oraz łatwy w obsłudze panel internetowy – idealny dla mniejszych instalacji. Dla większych organizacji lub tych, które potrzebują zaawansowanych funkcji, takich jak przedłużone przechowywanie danych, ulepszone powiadomienia i priorytetowe wsparcie techniczne, płatne plany zaczynają się od 4,50 USD za węzeł miesięcznie (rozliczane rocznie). To połączenie solidnego bezpłatnego poziomu i przystępnych cenowo opcji płatnych sprawia, że Netdata jest dostępna dla szerokiego grona użytkowników. W dalszej części przyjrzymy się bliżej podejściu Checkmk do monitorowania.
4. Checkmk
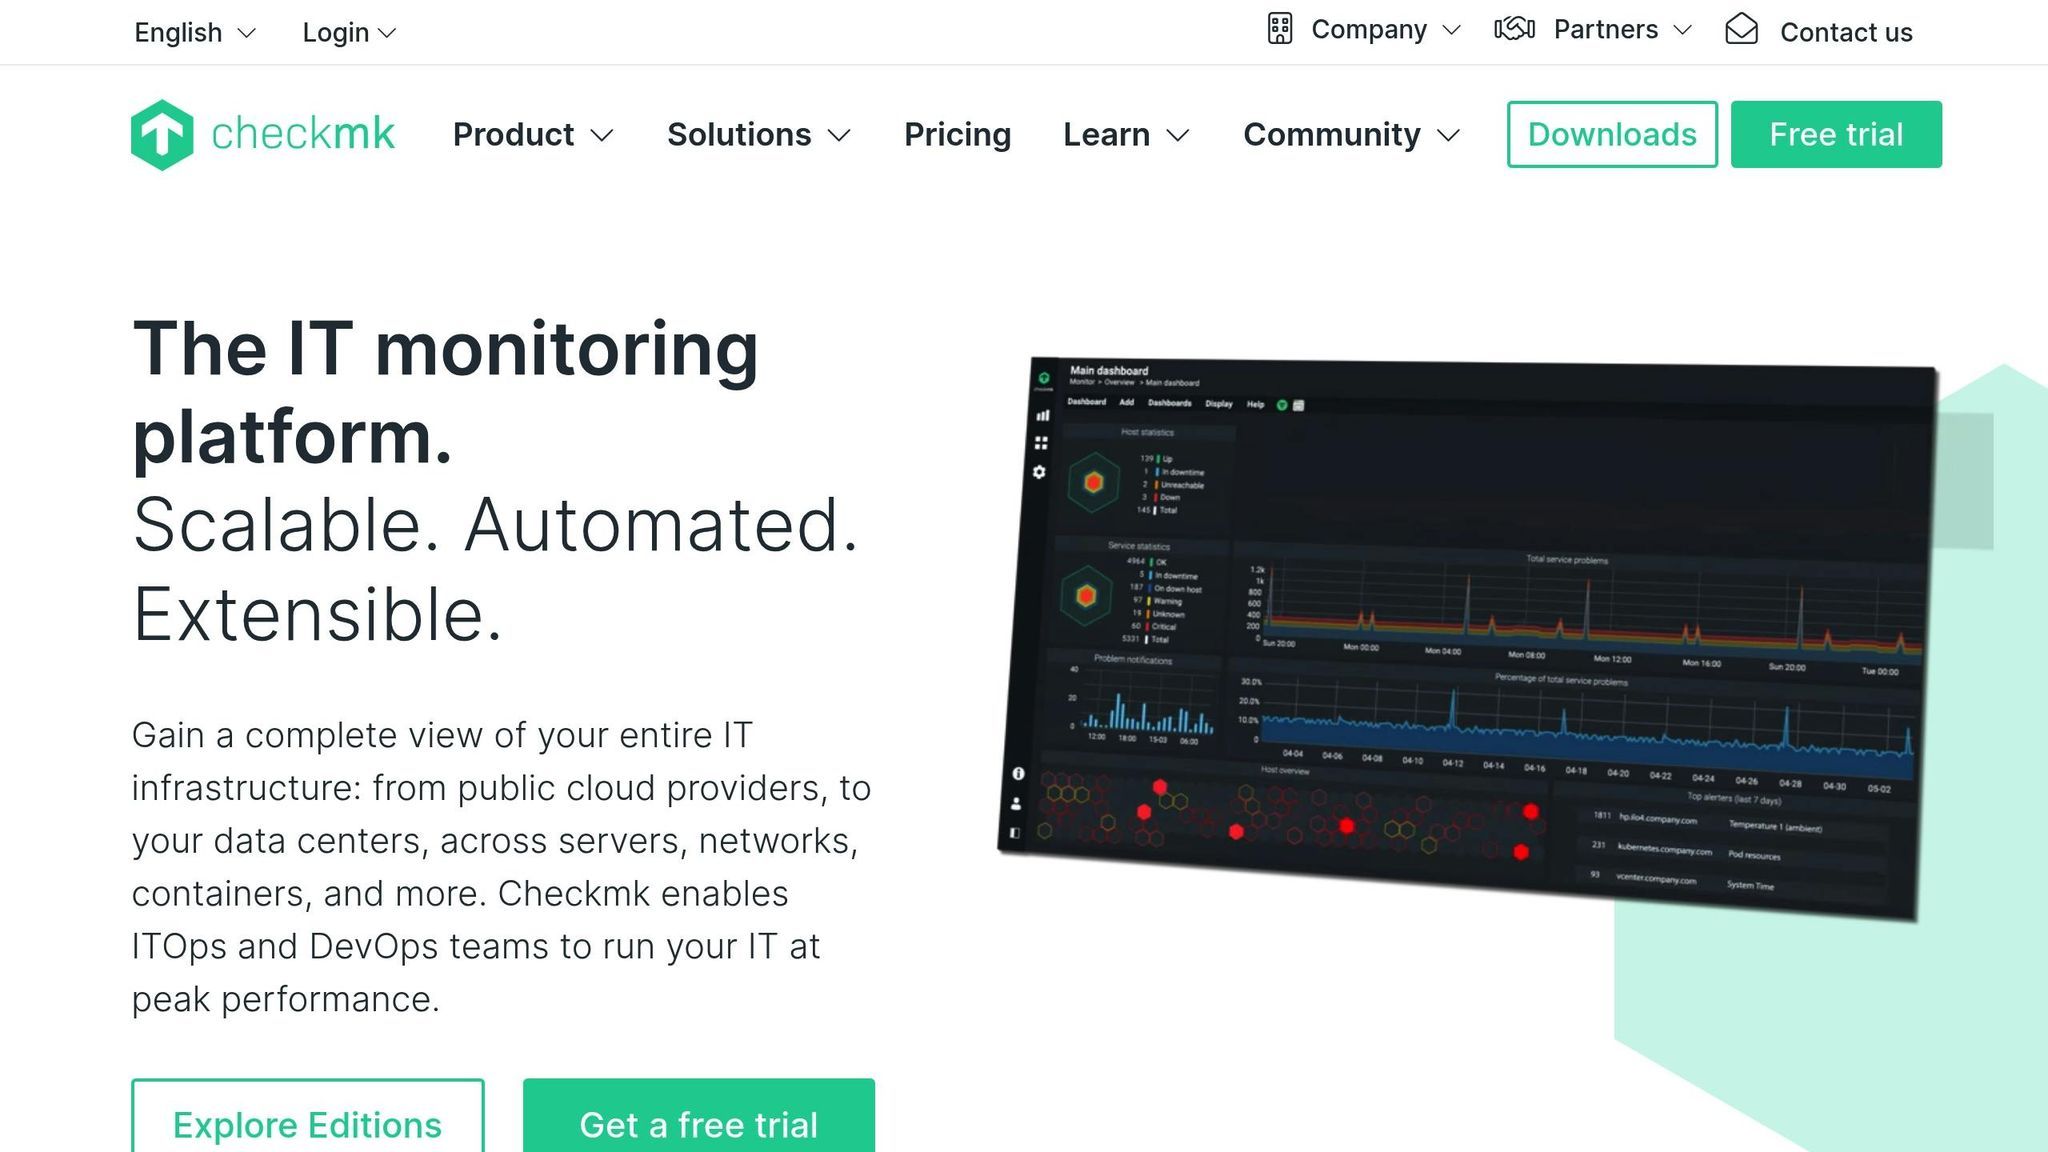
Checkmk to potężna platforma monitorująca przeznaczona do zarządzania serwerami dedykowanymi i środowiskami VPS. Jedną z jej wyróżniających się cech jest możliwość automatycznego wykrywania i monitorowania urządzeń sieciowych, serwerów oraz usług w momencie ich podłączenia do sieci, co pozwala uniknąć kłopotów związanych z ręczną konfiguracją.
Zakres monitorowania
Checkmk zapewnia szeroki zakres monitorowania, śledząc infrastrukturę, sieci, aplikacje, kontenery i usługi w chmurze z poziomu jednej platformy. Oferuje dogłębne kontrole hostów i usług dzięki obszernemu katalogowi wtyczek monitorujących, umożliwiając obserwację stanu sprzętu, baz danych, systemów pamięci masowej, warstw wirtualizacji oraz aplikacji niestandardowych. Gromadzi szczegółowe metryki w krótkich odstępach czasu i koreluje zmiany stanu w różnych systemach, aby wskazać pojawiające się problemy. Jego hybrydowa konstrukcja obsługuje zarówno monitorowanie oparte na agentach, jak i bezagentowe, zapewniając elastyczność w centrach danych, instalacjach lokalnych i środowiskach rozproszonych.
Funkcje czasu rzeczywistego
Checkmk udostępnia pulpity nawigacyjne na żywo, które są stale aktualizowane, pokazując stany hostów, wyniki kontroli usług i wskaźniki wydajności w miarę ich zmian. Obsługuje szybkie odpytywanie krytycznych hostów i może wyświetlać wykresy w czasie rzeczywistym dotyczące obciążenia, pamięci, sieci oraz stanu aplikacji. Panele kontrolne można dostosowywać, dzięki czemu zespoły mogą wyróżniać systemy priorytetowe i szybko wykrywać pilne problemy. Wydajny rdzeń monitorujący zapewnia niskie obciążenie nawet przy tysiącach sprawdzeń na minutę, umożliwiając dużym instalacjom utrzymanie responsywnej widoczności w czasie rzeczywistym.
Funkcje sztucznej inteligencji i automatyzacji
Checkmk oferuje automatyczne dostosowywanie progów i inteligentne przetwarzanie reguł, które ograniczają nadmiar alertów poprzez dostosowanie się do podstawowego zachowania systemu. Rozwiązanie potrafi automatycznie wykrywać hosty i usługi oraz stosować predefiniowane reguły monitorowania bez konieczności ręcznej konfiguracji. Funkcje predykcyjne wspierają analizę trendów i planowanie wydajności, pomagając zespołom wcześnie wykrywać ryzyko przeciążenia. W złożonych środowiskach oparty na regułach system automatyzacji usprawnia aktualizacje konfiguracji, aktywację kontroli oraz logikę powiadomień. Bardziej zaawansowane funkcje sztucznej inteligencji zazwyczaj wymagają połączenia z zewnętrznymi narzędziami analitycznymi, ponieważ Checkmk koncentruje się na monitorowaniu deterministycznym, a nie na pełnej automatyzacji incydentów.
Łatwość wdrożenia
Checkmk jest prosty we wdrożeniu dzięki szybkiemu procesowi instalacji i przejrzystym instrukcjom konfiguracji. Wersja „raw” wykorzystuje komponenty open source, natomiast wersja „enterprise” zawiera udoskonalony interfejs użytkownika oraz ulepszenia wydajności. Agentów można zainstalować za pomocą niewielkiego skryptu, a funkcja automatycznego wykrywania natychmiast rozpoznaje nowe usługi. Rozwiązanie dobrze integruje się ze środowiskami wirtualnymi i kontenerowymi oraz łatwo się skaluje dzięki rozproszonym lokalizacjom monitorowania w przypadku wdrożeń na dużą skalę lub obejmujących wiele regionów. Ponieważ oferuje solidne ustawienia domyślne od razu po uruchomieniu, zespoły mogą szybko uruchomić pełny system monitorowania bez konieczności przeprowadzania rozbudowanego dostrajania.
Ceny
Checkmk oferuje bezpłatną wersję „raw”, która obejmuje podstawowe funkcje monitorowania, pulpity nawigacyjne i powiadomienia, dzięki czemu nadaje się dla małych zespołów lub środowisk laboratoryjnych. Wersja „enterprise” oferuje dodatkowe zaawansowane funkcje, takie jak lepsza wydajność, rozszerzona automatyzacja, analityka predykcyjna oraz raportowanie długoterminowe. Ceny wersji Enterprise są zazwyczaj uzależnione od liczby monitorowanych hostów, zaczynając od przystępnego poziomu podstawowego i skalując się w miarę powiększania się infrastruktury. Dzięki temu całkowite koszty są przewidywalne i atrakcyjne dla organizacji, które chcą mieć wydajny system monitorowania bez wysokich opłat za użytkowanie w stylu SaaS.
5. Datadog
Datadog przenosi monitorowanie serwerów i VPS na wyższy poziom, dogłębnie analizując wydajność na poziomie kodu. Dzięki opartemu na sztucznej inteligencji rozproszonemu śledzeniu pomaga zidentyfikować wąskie gardła wydajności i wykrywać anomalie w momencie ich wystąpienia. Łącząc logi aplikacji z metrykami systemowymi, Datadog ułatwia odkrywanie pierwotnych przyczyn problemów i ich szybkie rozwiązywanie, zapewniając płynne działanie infrastruktury.
Zakres monitorowania
Datadog łączy metryki infrastruktury, logi, ślady i sygnały bezpieczeństwa w jedną platformę obserwowalności. Może pobierać dane telemetryczne z hostów, kontenerów, funkcji bezserwerowych, zarządzanych usług w chmurze i aplikacji niestandardowych. Jego integracje obejmują setki technologii, dzięki czemu można śledzić zachowanie baz danych, wydajność API, klastry Kubernetes oraz obciążenia natywne dla chmury z jednego, ujednoliconego widoku. Dane są gromadzone z dużą częstotliwością i korelowane między wskaźnikami, logami i śladami w celu ujawnienia wzorców wydajności i wąskich gardeł. Ten szeroki zakres pomaga zespołom zrozumieć, jak każda część ich stosu zachowuje się pod rzeczywistym obciążeniem.
Funkcje czasu rzeczywistego
Datadog udostępnia pulpity nawigacyjne na żywo, które są stale aktualizowane, pokazując wykorzystanie procesora, opóźnienia żądań, stany kontenerów, przepustowość sieci i inne parametry w miarę ich zmian. Można dostosować pulpity nawigacyjne tak, aby podkreślały sygnały istotne dla szybkiej diagnozy. Obsługuje również alerty w czasie rzeczywistym, dzięki czemu problemy, takie jak skoki błędów lub nasycenie pamięci, mogą wyzwalać powiadomienia natychmiast po ich wystąpieniu. Nawet przy dużych ilościach danych agent i zaplecze SaaS są zaprojektowane tak, aby utrzymać niskie obciążenie systemowe, zapewniając jednocześnie aktualną co do sekundy widoczność w systemach rozproszonych.
Funkcje sztucznej inteligencji i automatyzacji
Datadog zawiera narzędzia oparte na sztucznej inteligencji, które analizują historyczne wartości bazowe w celu wykrywania anomalii i redukcji szumu wynikającego z fałszywych alarmów. Pakiet Bits AI dodaje automatyczną klasyfikację, korelację między sygnałami oraz podsumowania incydentów, co przyspiesza dochodzenia. Może on sugerować prawdopodobne przyczyny źródłowe, proponować działania naprawcze na poziomie kodu lub konfiguracji oraz generować dokumentację po incydentach. Można również tworzyć przepływy pracy przy użyciu języka naturalnego, przekształcając rutynowe zadania operacyjne w zautomatyzowane sekwencje bez konieczności pisania skryptów. Pomaga to zespołom usprawnić procesy reagowania, zachowując jednocześnie kontrolę nad ścieżkami eskalacji.
Łatwość wdrożenia
Wdrożenie Datadog jest proste dzięki lekkiemu agentowi i architekturze natywnej dla chmury. Agenta można zainstalować za pomocą jednego skryptu, skorzystać z obrazów Docker lub wdrożyć go za pośrednictwem Kubernetes przy użyciu Helm. Jego integracje automatycznie wykrywają usługi i rozpoczynają gromadzenie danych telemetrycznych przy minimalnej konfiguracji. Ponieważ wszystko działa na platformie hostowanej przez Datadog, nie ma potrzeby utrzymywania zaplecza. Rozwiązanie to z łatwością wpisuje się zarówno w środowiska hybrydowe, jak i wielochmurowe, a także skaluje się wraz z szybko zmieniającą się infrastrukturą, dzięki czemu jest odpowiednie dla zespołów, które chcą uzyskać pełną widoczność bez konieczności zarządzania własnym stosem monitorującym.
Ceny
Datadog działa w oparciu o modułowy model cenowy, w którym podstawowe plany są rozliczane za każdy monitorowany host, a opcjonalne funkcje są rozliczane według rzeczywistego wykorzystania. Poziom Pro zaczyna się od około 15 USD za host miesięcznie przy rozliczeniu rocznym, natomiast plany Enterprise są droższe i obejmują zaawansowane funkcje zarządzania oraz funkcje oparte na sztucznej inteligencji. Dodatkowe opłaty dotyczą logów, śladów, testów syntetycznych, niestandardowych metryk oraz przedłużonego okresu przechowywania danych. Pozwala to zespołom na wdrażanie wyłącznie tych komponentów, których potrzebują, choć koszty mogą szybko wzrosnąć w środowiskach z dużą liczbą hostów lub intensywnym pozyskiwaniem logów. Pozostaje to elastyczną opcją dla organizacji, które chcą uzyskać kompleksową obserwowalność wspieraną przez dojrzałą platformę SaaS.
Zalety i wady
Po zapoznaniu się z funkcjami każdego z narzędzi przeanalizujmy ich mocne strony i ograniczenia, aby pomóc Ci zdecydować, które z nich najlepiej odpowiada Twoim potrzebom. Właściwy wybór będzie zależał od takich czynników, jak funkcjonalność, łatwość obsługi i budżet.
Prometheus zapewnia wyjątkową wydajność dzięki efektywnemu gromadzeniu danych szeregów czasowych oraz solidnemu językowi zapytań (PromQL) dostosowanemu do środowisk natywnych dla chmury. Brakuje mu jednak wbudowanych narzędzi do wizualizacji oraz możliwości długoterminowego przechowywania danych, co wymaga zastosowania zewnętrznych rozwiązań w tym zakresie.
Grafana wyróżnia się elastyczną i zaawansowaną wizualizacją danych, płynnie integrując się z różnymi źródłami danych, w tym z Prometheusem, w celu tworzenia atrakcyjnych wizualnie pulpitów nawigacyjnych. Jej głównym ograniczeniem jest brak natywnego gromadzenia danych, co sprawia, że w zakresie pozyskiwania danych jest uzależniona od narzędzi zewnętrznych.
Zabbix to skalowalne i kompleksowe rozwiązanie do monitorowania. Jako oprogramowanie typu open source eliminuje koszty licencji, ale często wymaga bardziej złożonej konfiguracji i bieżącej konserwacji, co może być zasobochłonne.
Netdata wyróżnia się lekką konstrukcją i monitorowaniem wydajności w czasie rzeczywistym, oferując szybki proces konfiguracji – często zakończony w ciągu kilku minut. To sprawia, że jest doskonałym wyborem dla małych i średnich środowisk. Ma jednak ograniczone możliwości długoterminowej analizy danych historycznych i oferuje bardziej podstawowe alerty w porównaniu z platformami klasy korporacyjnej.
Checkmk zapewnia skalowalne monitorowanie z wskaźnikami w czasie rzeczywistym i konfigurowalnymi alertami, co czyni go idealnym rozwiązaniem dla wdrożeń serwerowych na dużą skalę. Jego zaawansowane funkcje wiążą się jednak z większym nakładem czasu na naukę obsługi oraz zwiększoną złożonością konfiguracji wraz ze wzrostem skali wdrożenia.
Datadog oferuje kompleksowe monitorowanie oparte na analizach generowanych przez sztuczną inteligencję, obejmujące infrastrukturę, aplikacje i zarządzanie logami. Chociaż jego funkcje są rozbudowane, koszty subskrypcji mogą szybko się sumować (np. 15 USD miesięcznie za host w przypadku infrastruktury, z dodatkowymi opłatami za APM i zarządzanie logami). Ponadto opanowanie jego zaawansowanych funkcji wymaga znacznej inwestycji czasu i wysiłku związanego z nauką.
Poniższa tabela podsumowuje kluczowe zalety, wady i struktury kosztów każdego narzędzia, umożliwiając szybkie porównanie:
| Narzędzie | Główne zalety | Główne słabe strony | Struktura kosztów |
|---|---|---|---|
| Prometheus | Wydajne gromadzenie danych szeregów czasowych i zaawansowany język zapytań | Brak wbudowanych funkcji wizualizacji i przechowywania danych | Oprogramowanie open source (tylko koszty operacyjne) |
| Grafana | Elastyczna, zaawansowana wizualizacja z obsługą wielu źródeł | Brak natywnego gromadzenia danych | Oprogramowanie open source (tylko koszty operacyjne) |
| Zabbix | Skalowalne, kompleksowe monitorowanie tradycyjnych środowisk IT | Złożona konfiguracja i konserwacja | Bezpłatny (z kosztami hostingu i konserwacji) |
| Netdata | Lekki system monitorowania w czasie rzeczywistym z szybką konfiguracją | Ograniczona analiza danych historycznych i powiadomień | Ceny zaczynają się od 4,50 USD za węzeł miesięcznie |
| Checkmk | Skalowalne monitorowanie z wskaźnikami w czasie rzeczywistym i niestandardowymi alertami | Trudne opanowanie zaawansowanych funkcji | Około 80 USD miesięcznie za ~100 hostów |
| Datadog | Kompleksowy monitoring w skali chmury z analizami opartymi na sztucznej inteligencji | Wyższe koszty i stroma krzywa nauki | Ceny zaczynają się od 15 USD za host miesięcznie (plus dodatkowe opłaty) |
Twoja decyzja zależy ostatecznie od wiedzy specjalistycznej i budżetu Twojego zespołu. Narzędzia open source, takie jak Prometheus i Zabbix, mogą być bardzo skuteczne, jeśli Twój zespół posiada wiedzę techniczną niezbędną do zarządzania nimi. Z drugiej strony komercyjne rozwiązania, takie jak Checkmk, Netdata i Datadog, zapewniają gotowe do użycia rozwiązania, które zmniejszają nakład pracy wewnątrz firmy, ale często wiążą się z wyższymi kosztami.
Wnioski
Wybór odpowiedniego narzędzia do monitorowania serwera dedykowanego lub VPS w 2025 r. sprowadza się do zrozumienia konkretnego środowiska, wiedzy technicznej oraz ograniczeń budżetowych.
W przypadku mniejszych instalacji lub tych, które wymagają szybkich wyników, Netdata jest solidnym wyborem. Dzięki analizom w czasie rzeczywistym i prostej konfiguracji idealnie nadaje się do natychmiastowego monitorowania bez konieczności skomplikowanej konfiguracji.
Większe, bardziej złożone środowiska często wymagają skalowalnych rozwiązań. Jeśli pracujesz z systemami natywnymi dla chmury lub kontenerowymi, Prometheus i Grafana to doskonałe opcje. Łączą one potężne możliwości gromadzenia danych szeregów czasowych z konfigurowalnymi wizualizacjami, choć skuteczne zarządzanie nimi wymaga wyższego poziomu wiedzy technicznej.
W przypadku przedsiębiorstw warto rozważyć Checkmk i Datadog. Checkmk zapewnia szerokie możliwości monitorowania i może być opłacalny w przypadku wdrożeń na dużą skalę. Z drugiej strony Datadog wyróżnia się analizami opartymi na sztucznej inteligencji oraz rozbudowanymi integracjami, choć skalowanie może wymagać bardziej starannego planowania zasobów.
W tradycyjnych środowiskach IT o zróżnicowanej infrastrukturze Zabbix pozostaje silnym konkurentem. Chociaż jego konfiguracja może być bardziej skomplikowana, solidne funkcje i brak opłat licencyjnych sprawiają, że jest on atrakcyjny dla organizacji posiadających dedykowanych administratorów systemów.
Ostatecznie najlepszym rozwiązaniem do monitorowania jest takie, które jest dostosowane do możliwości Twojego zespołu w zakresie skutecznego zarządzania nim. Narzędzie przepełnione funkcjami może szybko stać się obciążeniem, jeśli przerasta Twoje możliwości operacyjne. Rozpoczęcie od lekkiej opcji, takiej jak Netdata, pozwala ustanowić podstawę monitorowania, zapewniając jednocześnie elastyczność w zakresie wdrażania bardziej kompleksowych platform w miarę rozwoju infrastruktury i wiedzy specjalistycznej.
Celem jest skupienie się na spójnym, praktycznym monitorowaniu, a nie na pogoni za każdą zaawansowaną funkcją. Dzięki stopniowemu, dostosowanemu do potrzeb podejściu możesz zapewnić, że Twoja strategia monitorowania będzie ewoluować wraz z wymaganiami Twojego środowiska hostingowego.
Często zadawane pytania
W jaki sposób sztuczna inteligencja i automatyzacja usprawnią monitorowanie serwerów w 2025 roku i jakie narzędzia oferują te funkcje?
W 2025 r. sztuczna inteligencja i automatyzacja zmieniają oblicze monitorowania serwerów, sprawiając, że zarządzanie serwerami dedykowanymi i VPS staje się bardziej inteligentne, wydajne i elastyczne. Dzięki systemom opartym na sztucznej inteligencji można identyfikować nietypowe wzorce, przewidywać potencjalne awarie oraz automatycznie rozwiązywać rutynowe problemy. Takie podejście skraca przestoje i zwiększa ogólną niezawodność serwerów.
Narzędzia takie jak Dynatrace, Logz.io i Datadog przodują w tej dziedzinie dzięki wykorzystaniu sztucznej inteligencji i automatyzacji. Zapewniają one wgląd w dane w czasie rzeczywistym, wykrywają anomalie i oferują analizy predykcyjne zaprojektowane specjalnie z myślą o wysokowydajnych środowiskach hostingowych. Te możliwości gwarantują płynne i bezpieczne działanie serwerów, nawet przy intensywnym obciążeniu.
Co należy wziąć pod uwagę przy wyborze między narzędziami do monitorowania typu open source a płatnymi narzędziami do monitorowania serwera lub VPS?
Rozważając wybór między narzędziami do monitorowania typu open source a płatnymi, należy przede wszystkim wziąć pod uwagę to, co najlepiej odpowiada Twoim potrzebom i zasobom. Narzędzia typu open source są zazwyczaj bezpłatne i oferują wysoki stopień dostosowania, co jest idealnym rozwiązaniem, jeśli dysponujesz wiedzą techniczną i potrzebujesz elastycznego rozwiązania. Z kolei narzędzia płatne często oferują intuicyjne interfejsy, zaawansowane funkcje i dedykowane wsparcie techniczne, co pozwala zaoszczędzić czas i uprościć proces.
Aby dokonać właściwego wyboru, weź pod uwagę kilka kluczowych czynników: budżet, poziom wsparcia, jakiego możesz potrzebować, łatwość konfiguracji narzędzia oraz to, czy będzie ono w stanie rozwijać się wraz z rosnącymi wymaganiami Twojego serwera lub VPS. Poświęcenie czasu na ocenę tych elementów pomoże Ci wybrać opcję, która będzie zgodna z Twoimi celami w zakresie monitorowania i wydajności.
Jaki jest najlepszy sposób na zapewnienie, że rozwiązanie do monitorowania serwerów będzie skalowalne wraz z rozwojem infrastruktury?
Aby rozwiązanie do monitorowania nadążało za rozbudowującą się infrastrukturą, należy skupić się na narzędziach i strategiach kładących nacisk na skalowalność i automatyzację. Wybieraj platformy obsługujące architektury rozproszone, umożliwiające płynne monitorowanie wielu serwerów lub maszyn wirtualnych w miarę rozwoju systemu. Szczególnie przydatne są funkcje takie jak analityka oparta na sztucznej inteligencji oraz pulpity nawigacyjne działające w czasie rzeczywistym – pozwalają one przetwarzać większe ilości danych, dostarczając jednocześnie wartościowe informacje bez spowolnienia działania.
Warto również wybierać narzędzia, które oferują konfigurowalne alerty i łatwo integrują się z obecnymi procesami pracy. W ten sposób można szybko wykrywać i rozwiązywać problemy w miarę ewolucji infrastruktury. Należy wyrobić sobie nawyk regularnej oceny i dostosowywania konfiguracji monitorowania, aby zapewnić jej wydajność i niezawodność na każdym etapie rozwoju firmy.

Jak hostować modele Ollama AI na serwerach dedykowanych
Dowiedz się, jak hostować modele Ollama AI na serwerach dedykowanych, aby zapewnić bezpieczeństwo danych, skalowalność i zwiększyć wydajność.
5 min czytania - 8 września 2025
Jak zainstalować i korzystać z Redis na serwerze VPS
9 min czytania - 7 stycznia 2026

Masz pytania lub potrzebujesz niestandardowego rozwiązania?

Elastyczne opcje

Globalny zasięg

Natychmiastowe wdrożenie
Elastyczne opcje
Globalny zasięg
Natychmiastowe wdrożenie