
Monitoraggio del proprio server dedicato o VPS: quali sono le opzioni disponibili nel 2025?
12 min di lettura - 28 novembre 2025
Scopri i migliori strumenti di monitoraggio per server dedicati e VPS nel 2025, con particolare attenzione all’intelligenza artificiale, all’automazione e all’analisi in tempo reale.
Monitoraggio del server dedicato o del VPS: quali saranno le opzioni nel 2025?
Il monitoraggio del proprio server dedicato o VPS nel 2025 consiste nell’anticipare potenziali problemi grazie a strumenti più intelligenti ed efficienti. Le soluzioni moderne sfruttano ormai l’intelligenza artificiale, l’analisi in tempo reale e l’automazione per prevedere i guasti, monitorare le prestazioni e ridurre i tempi di inattività. Ecco una breve panoramica delle principali opzioni:
- Prometheus + Grafana: coppia open source per la raccolta di dati in serie temporali e dashboard personalizzabili. Ottima per configurazioni cloud-native.
- Zabbix: monitoraggio di livello aziendale con potenti funzionalità di allerta e mappatura delle dipendenze per infrastrutture complesse.
- Netdata: monitoraggio delle prestazioni leggero e in tempo reale con configurazione rapida.
- Checkmk: monitoraggio scalabile con individuazione automatica dei dispositivi e approfondimenti dettagliati.
- Datadog: monitoraggio incentrato sul cloud con funzionalità basate sull’intelligenza artificiale e tracciamento approfondito delle applicazioni.
Ogni strumento risponde a esigenze diverse, dalle piccole configurazioni alle grandi imprese. Di seguito è riportato un rapido confronto per aiutarti a decidere:
Confronto rapido
| Strumento | Ideale per | Caratteristiche principali | Costo |
|---|---|---|---|
| Prometheus + Grafana | Ambienti cloud-native | Dati di serie temporali, dashboard personalizzate | Gratuito (self-hosted) |
| Zabbix | Configurazioni IT complesse | Mappatura delle dipendenze, con o senza agenti | Gratuito (autogestito) |
| Netdata | Monitoraggio delle prestazioni in tempo reale | Metriche leggere e immediate | Gratuito/$4,50 per nodo |
| Checkmk | Implementazioni su larga scala | Rilevamento automatico, ampio ambito di monitoraggio | circa 80 $ al mese (100 host) |
| Datadog | Monitoraggio a livello di cloud e di applicazione | Analisi basate sull’intelligenza artificiale, tracciamento delle applicazioni, integrazioni | 15 $+/host/mese |
Scegli in base alle dimensioni della tua infrastruttura, alle competenze tecniche e al budget. Gli strumenti open source come Prometheus e Zabbix sono convenienti ma richiedono una configurazione più complessa, mentre le opzioni a pagamento come Datadog offrono facilità d’uso e funzionalità avanzate. Inizia in piccolo e scala man mano che le tue esigenze crescono.
Guida completa al monitoraggio dei server | Corso di monitoraggio n. 2
1. Prometheus e Grafana
Prometheus e Grafana insieme costituiscono una delle soluzioni di monitoraggio open source più efficaci attualmente disponibili. Prometheus si concentra sulla raccolta e l’archiviazione dei dati, mentre Grafana trasforma tali dati in dashboard visivamente intuitive. Questa combinazione offre un modo flessibile ed economico per monitorare server dedicati e ambienti VPS.
Ambito di monitoraggio
Prometheus è ben noto per la sua capacità di raccogliere dati di serie temporali su sistemi diversi. Tiene traccia di metriche chiave come l’utilizzo della CPU, il consumo di memoria e l’I/O del disco, gestendo al contempo statistiche più specializzate e specifiche per le applicazioni. Utilizzando un modello pull, recupera le metriche dagli endpoint configurati a intervalli regolari, rendendolo adatto al monitoraggio sia di configurazioni containerizzate che di server bare-metal tradizionali.
Per ampliare le proprie funzionalità, Prometheus supporta numerosi esportatori ufficiali, consentendogli di raccogliere dati da quasi tutti i servizi o le applicazioni in esecuzione nella vostra infrastruttura.
Grafana integra Prometheus presentando questi dati attraverso dashboard personalizzabili. Queste dashboard possono includere grafici in tempo reale, mappe di calore e stati di allerta. Inoltre, Grafana integra dati provenienti da più fonti, offrendo una visione unificata e completa delle prestazioni del sistema.
Funzionalità in tempo reale
Prometheus raccoglie le metriche a intervalli che possono essere impostati con una frequenza di pochi secondi, sebbene l’impostazione predefinita sia solitamente compresa tra 15 e 30 secondi. D’altra parte, le dashboard di Grafana si aggiornano automaticamente man mano che arrivano nuovi dati. È possibile regolare gli intervalli di aggiornamento in base alle proprie esigenze, sia che si tratti di pochi secondi o di periodi più lunghi. Questa rapida reattività è preziosa per monitorare improvvisi picchi di traffico o colli di bottiglia delle risorse, garantendo di essere sempre aggiornati sulle prestazioni del sistema e pronti ad agire in caso di eventuali problemi.
Funzionalità di IA/automazione
Sebbene Prometheus e Grafana non siano principalmente basati sull’intelligenza artificiale, includono comunque funzionalità di automazione per migliorare il monitoraggio. Prometheus include Alertmanager, che invia notifiche in base a condizioni predefinite. Questo sistema supporta regole di allerta complesse, sfruttando sia le metriche in tempo reale che i dati storici per garantire la precisione.
Grafana ha introdotto strumenti di rilevamento delle anomalie che utilizzano l’apprendimento automatico per individuare modelli insoliti nelle metriche. Questi strumenti aiutano a ridurre i falsi allarmi imparando il comportamento tipico del sistema. Possono inoltre supportare l’automazione attivando azioni quali il ridimensionamento delle risorse o l’invio di avvisi ai sistemi di orchestrazione quando vengono superate le soglie.
Facilità di implementazione
La configurazione di Prometheus e Grafana è semplice. Entrambi gli strumenti possono essere eseguiti in container Docker, garantendo installazioni coerenti su diversi sistemi operativi. Con strumenti come docker-compose, è possibile implementare uno stack di monitoraggio completo in pochi minuti.
Per chi utilizza server dedicati, entrambe le applicazioni possono essere installate direttamente tramite i gestori di pacchetti nativi presenti nella maggior parte delle distribuzioni Linux. Anche le configurazioni avanzate sono relativamente semplici da impostare e da risolvere, rendendo questa coppia accessibile a utenti con diversi livelli di competenza.
Prezzi
Prometheus e Grafana sono completamente gratuiti e open source, senza costi di licenza, limiti di utenti o restrizioni sulla conservazione dei dati. Ciò li rende una soluzione conveniente per il monitoraggio della propria infrastruttura.
Per chi preferisce un’opzione gestita, Grafana offre un servizio basato su cloud. Il piano gratuito fornisce funzionalità di base, mentre i piani a pagamento scalabili includono funzionalità e capacità aggiuntive. Sebbene molti utenti ritengano che l’hosting autonomo soddisfi le loro esigenze, il servizio gestito rappresenta una comoda alternativa, specialmente per chi desidera semplificare le attività di manutenzione e assistenza.
2. Zabbix
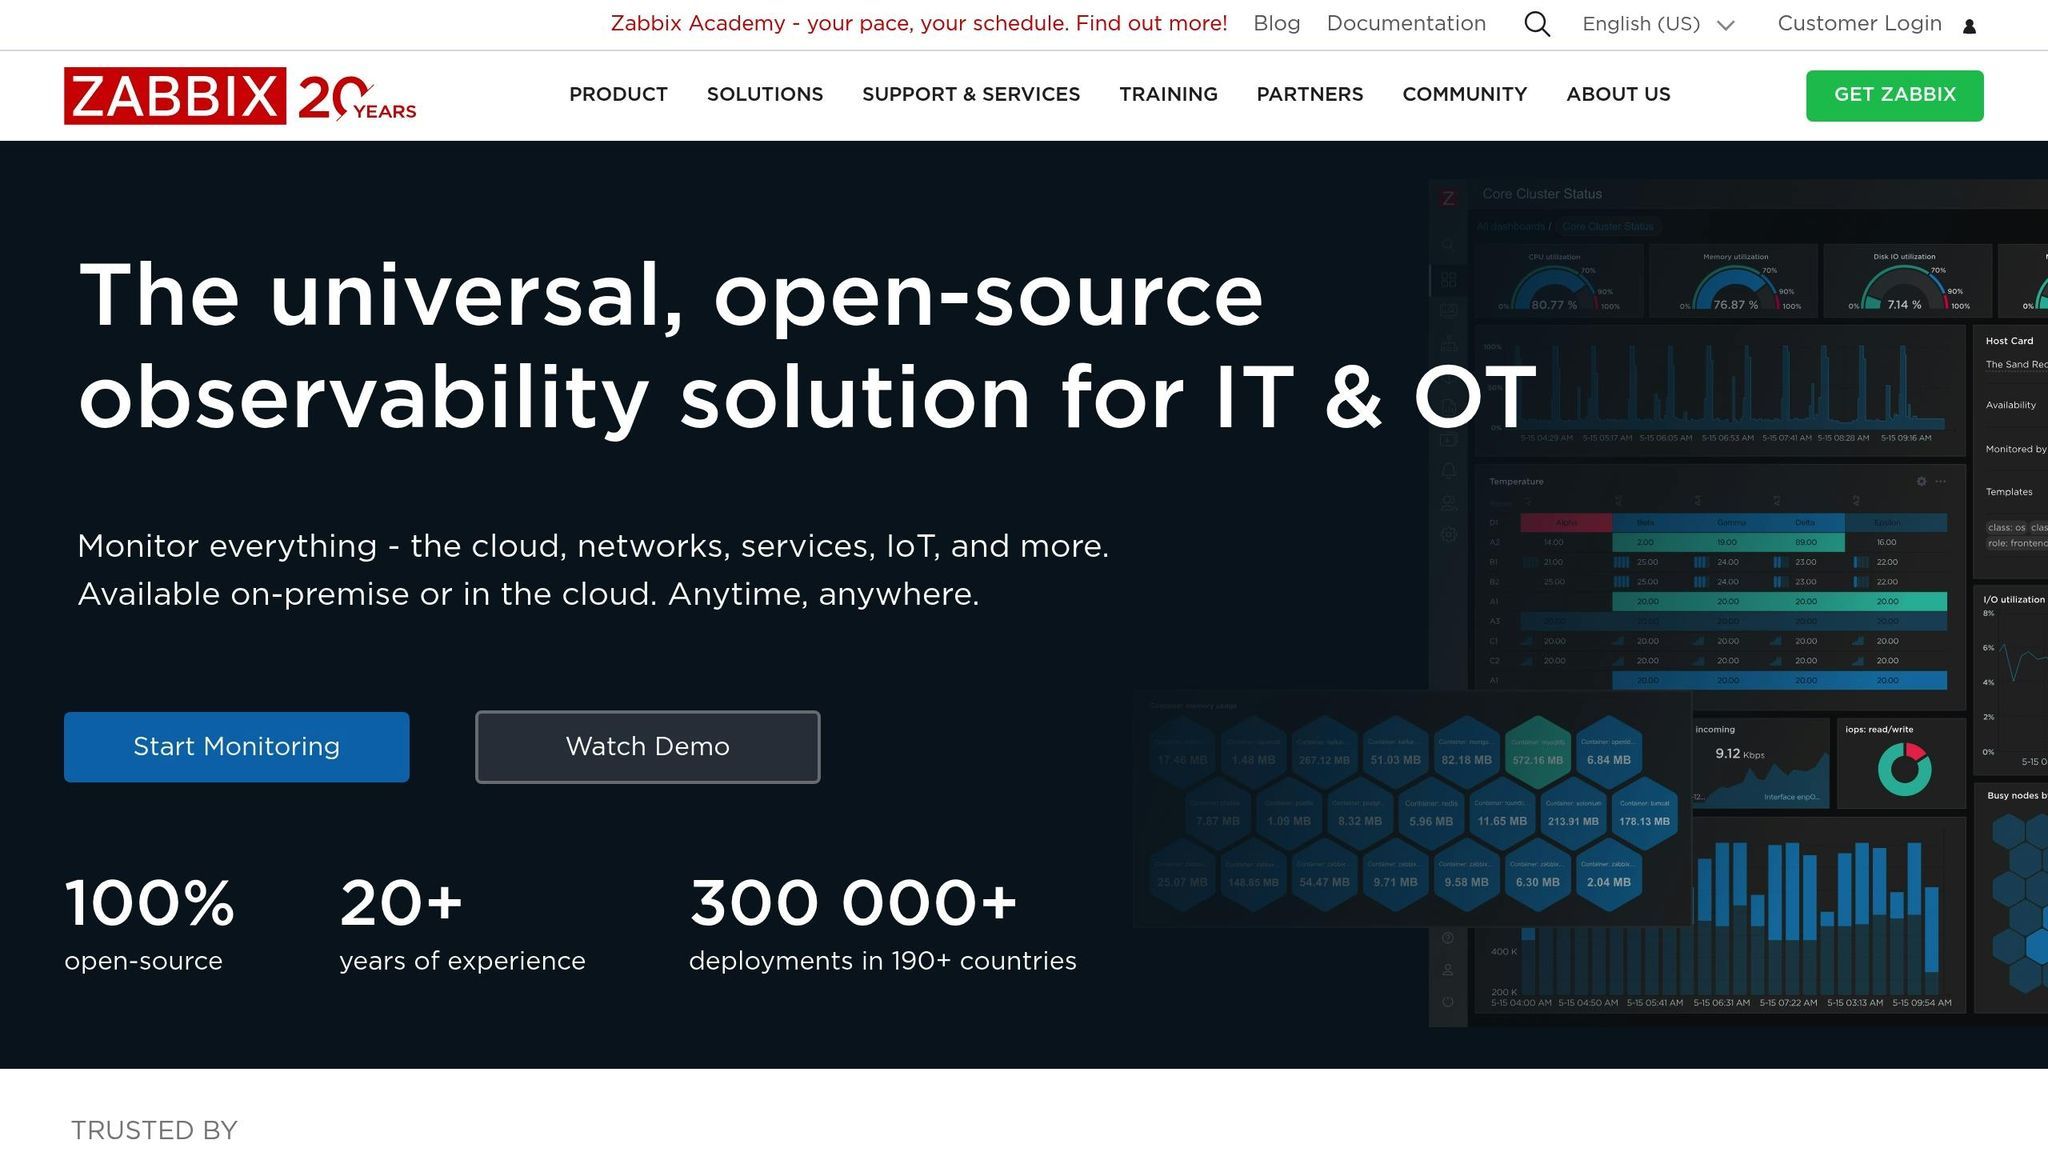
Zabbix è una potente piattaforma di monitoraggio che è stata perfezionata nel corso di due decenni per soddisfare le esigenze degli ambienti di livello aziendale. Offre un'interfaccia unificata per la gestione di server dedicati e VPS, rendendola una scelta affidabile per configurazioni complesse.
Ambito di monitoraggio
Zabbix va oltre le metriche di sistema di base, fornendo visibilità su dispositivi di rete, applicazioni, database, servizi web e piattaforme di virtualizzazione, il tutto da una dashboard centralizzata. Sia che si preferisca il monitoraggio basato su agente o senza agente, Zabbix è in grado di monitorare ogni aspetto, dall’utilizzo della CPU e della memoria alle metriche personalizzate delle applicazioni.
La piattaforma semplifica la gestione in ambienti dinamici individuando automaticamente nuovi dispositivi e servizi. Supporta il monitoraggio dei dispositivi SNMP, l’esecuzione di query sui database, il controllo dei tempi di risposta web e l’analisi dei log alla ricerca di errori.
Una caratteristica distintiva è la sua capacità di mappare le dipendenze tra i componenti dell’infrastruttura. Queste mappe di dipendenza offrono una visione chiara di come server, applicazioni e componenti di rete interagiscono tra loro, rendendo più facile identificare e risolvere i problemi.
Funzionalità in tempo reale
Zabbix raccoglie ed elabora i dati di monitoraggio a intervalli configurabili dall’utente, che in genere vanno da 30 secondi a 5 minuti, a seconda dell’importanza delle metriche. La sua interfaccia web include dashboard in tempo reale che si aggiornano automaticamente, offrendo una visione sempre aggiornata dei sistemi.
È possibile personalizzare la frequenza con cui vengono raccolte le diverse metriche. Ad esempio, i dati critici possono essere raccolti più frequentemente, mentre le metriche meno essenziali vengono registrate meno spesso. Questa flessibilità garantisce un uso efficiente delle risorse di sistema e dello spazio di archiviazione.
Funzionalità predittive e automatizzate
Utilizzando i dati storici, Zabbix è in grado di prevedere le tendenze per individuare tempestivamente le anomalie. Inoltre, automatizza le risposte eseguendo script quando vengono raggiunte soglie specifiche. Ad esempio, la piattaforma può riavviare un servizio o eseguire automaticamente uno script di manutenzione quando si verificano condizioni predefinite.
Il suo sistema di allerta è progettato per ridurre il sovraccarico di notifiche. Raggruppa gli avvisi correlati e gestisce le dipendenze, assicurando che vengano inviate solo notifiche significative attraverso i canali di comunicazione scelti.
Facilità di implementazione
Sebbene Zabbix possa richiedere un po’ più di impegno durante la configurazione iniziale, supporta vari metodi di implementazione, tra cui container Docker, appliance virtuali e installazioni native sulle principali distribuzioni Linux e sui sistemi Windows.
I modelli predefiniti per applicazioni e servizi di uso comune consentono di risparmiare tempo durante la configurazione. Inoltre, le funzionalità di rilevamento automatico e registrazione automatica di Zabbix semplificano il processo di configurazione del monitoraggio per nuovi dispositivi e servizi. È persino possibile automatizzare l’implementazione degli agenti sui server utilizzando strumenti di gestione della configurazione o le opzioni integrate di Zabbix.
Prezzi
Zabbix è completamente gratuito e open source, senza costi di licenza né limiti di utenti. Per chi necessita di ulteriore supporto, sono disponibili pacchetti di abbonamento commerciali, con prezzi che dipendono dal livello di assistenza richiesto.
I principali costi associati a Zabbix includono l’hardware necessario per il server e il database di Zabbix, nonché il tempo dedicato alla configurazione e alla manutenzione. Grazie alle sue funzionalità complete e all’assenza di costi di licenza, Zabbix rimane un forte concorrente nel settore del monitoraggio mentre ci avviciniamo al 2025.
Stanco di implementazioni lente o limiti di larghezza di banda? FDC Servers offre potenza dedicata immediata, copertura globale e piani flessibili pensati per qualsiasi scala.
Esegui l'aggiornamento ora3. Netdata
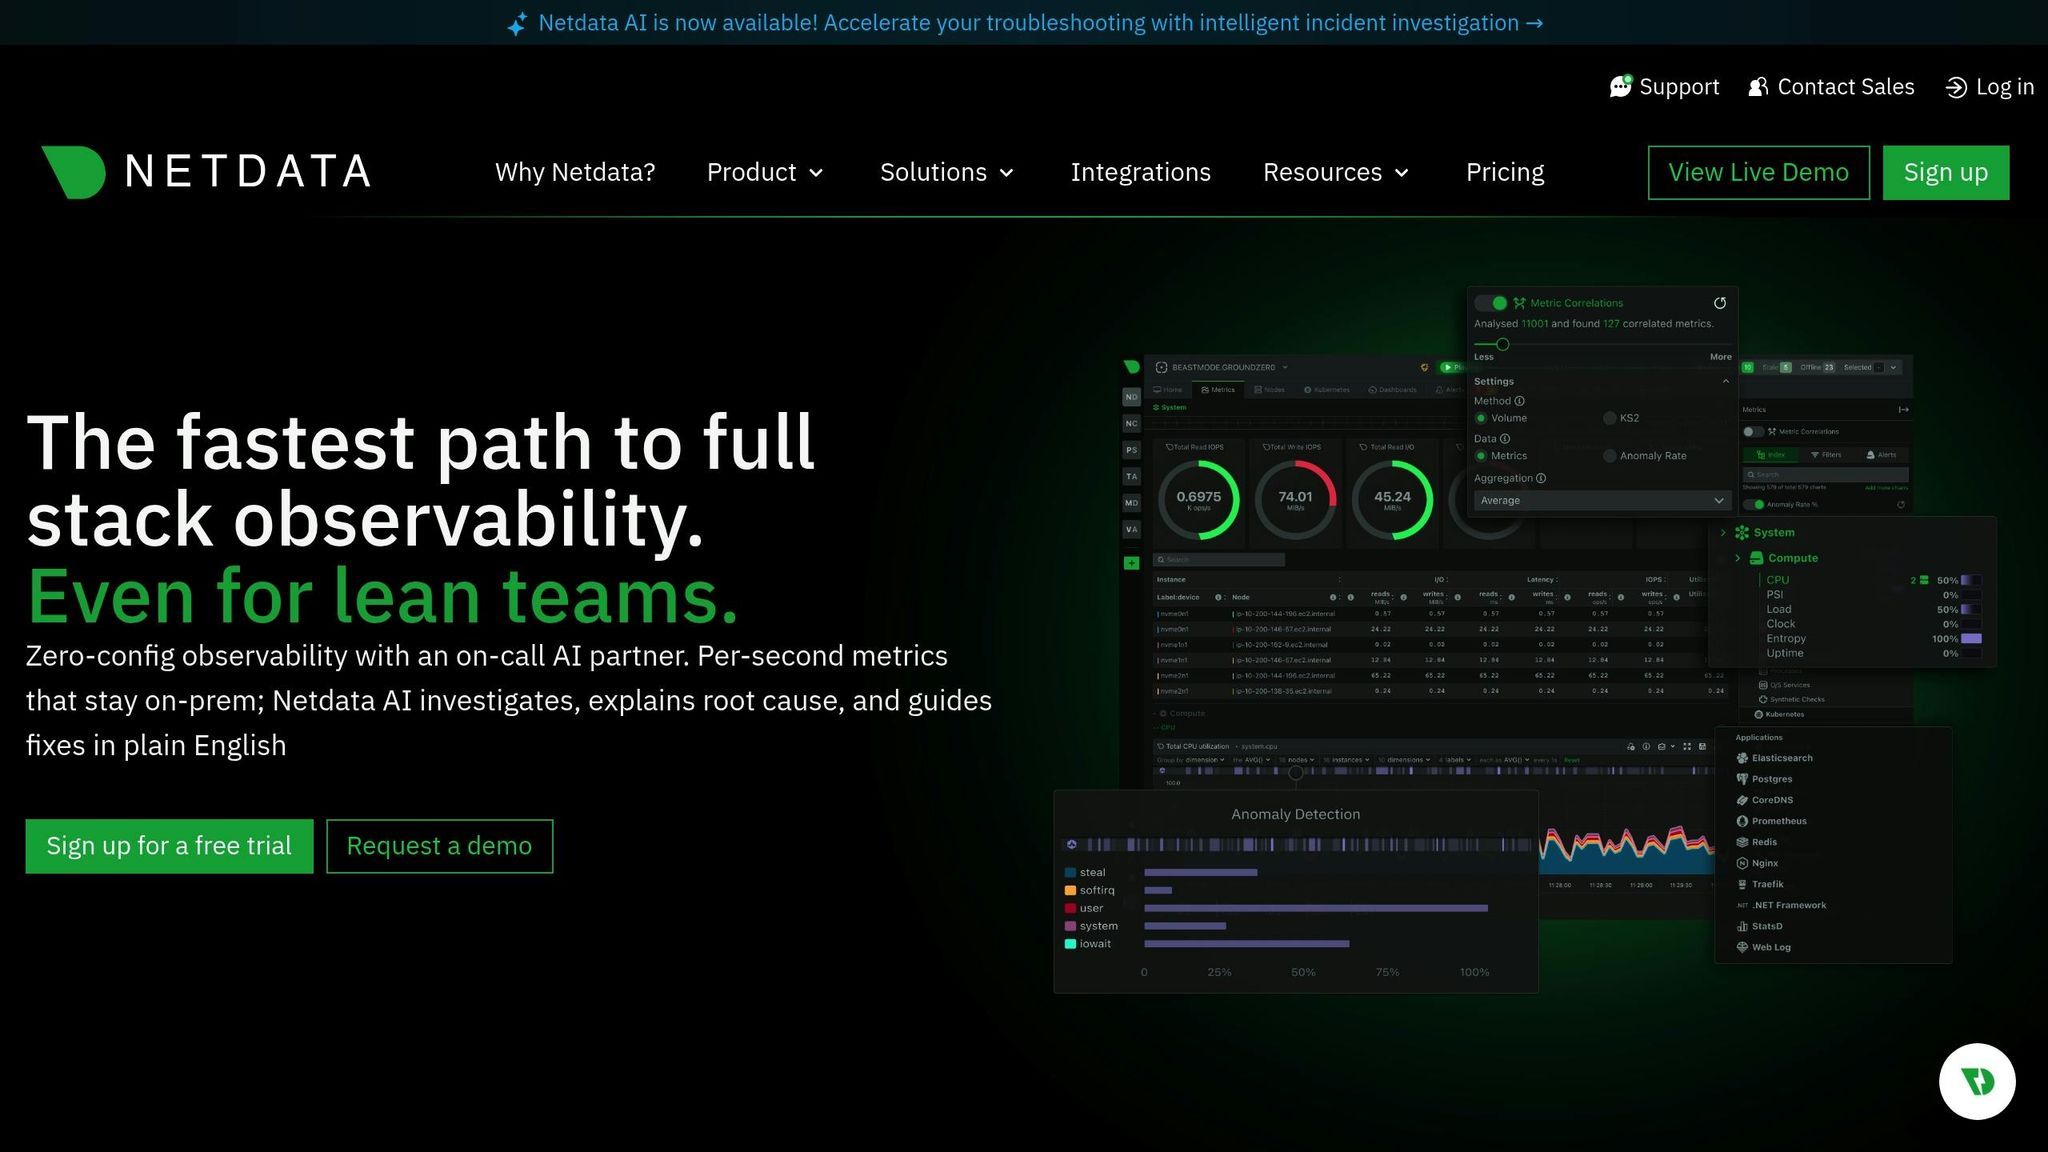
Netdata è uno strumento leggero progettato per il monitoraggio delle prestazioni in tempo reale. La sua capacità di fornire informazioni immediate con un impatto minimo sulle risorse di sistema lo rende la scelta ideale per le organizzazioni che necessitano di una visibilità immediata sulla propria infrastruttura.
Ambito di monitoraggio
Netdata monitora oltre 800 metriche, che coprono ogni aspetto, dall’utilizzo della CPU e della memoria all’I/O del disco e al traffico di rete. Funziona senza soluzione di continuità su server dedicati e VPS e fornisce persino metriche dettagliate sui container. Raccogliendo dati ogni secondo, rileva picchi e anomalie quasi istantaneamente. Questa raccolta di dati quasi in tempo reale integra le analisi storiche più approfondite offerte da altri strumenti. Inoltre, tiene traccia automaticamente di nuovi servizi, applicazioni e container non appena questi diventano operativi. Per chi necessita di archiviazione a lungo termine o di analisi più avanzate, Netdata può inviare le metriche a piattaforme esterne come Prometheus o OpenObserve.
Funzionalità in tempo reale
Netdata offre dashboard in tempo reale che si aggiornano continuamente, fornendo una visione in tempo reale dello stato di salute del sistema. Queste dashboard sono personalizzabili, consentendo di concentrarsi sulle metriche più rilevanti per una rapida risoluzione dei problemi. Nonostante le sue informazioni dettagliate, il design leggero di Netdata garantisce un funzionamento con un consumo minimo di risorse.
Funzionalità di IA e automazione
Netdata utilizza il rilevamento delle anomalie basato sull’intelligenza artificiale per apprendere il comportamento normale del sistema e segnalare le deviazioni come potenziali problemi. Include inoltre avvisi preconfigurati che si adattano alla vostra infrastruttura, riducendo i falsi allarmi grazie all’analisi delle tendenze storiche e del contesto. Tuttavia, il suo sistema di avvisi meno centralizzato potrebbe richiedere l’integrazione con strumenti esterni per flussi di lavoro più complessi di instradamento o escalation degli avvisi.
Facilità di implementazione
Netdata è facile da configurare, con opzioni di installazione che vanno dai semplici script alle immagini Docker. Supporta sia gli ambienti on-premise che quelli cloud, integrandosi senza problemi con gli stack di monitoraggio esistenti. La sua natura open source consente la personalizzazione senza essere vincolati a un fornitore specifico. Per le configurazioni containerizzate, le immagini Docker e i chart Helm di Kubernetes semplificano l’implementazione, mentre il rilevamento automatico garantisce che i nuovi servizi e le nuove applicazioni vengano monitorati immediatamente.
Prezzi
Netdata offre un piano gratuito "Community" che include funzionalità essenziali come il monitoraggio in tempo reale, gli avvisi di base e una dashboard web di facile utilizzo: l’ideale per configurazioni di piccole dimensioni. Per le organizzazioni più grandi o per chi necessita di funzionalità avanzate come la conservazione estesa dei dati, un sistema di avvisi potenziato e un'assistenza prioritaria, i piani a pagamento partono da 4,50 dollari al mese per nodo (fatturati annualmente). Questa combinazione di un solido livello gratuito e di opzioni a pagamento convenienti rende Netdata accessibile a un'ampia gamma di utenti. Di seguito, esamineremo più da vicino l’approccio di Checkmk al monitoraggio.
4. Checkmk
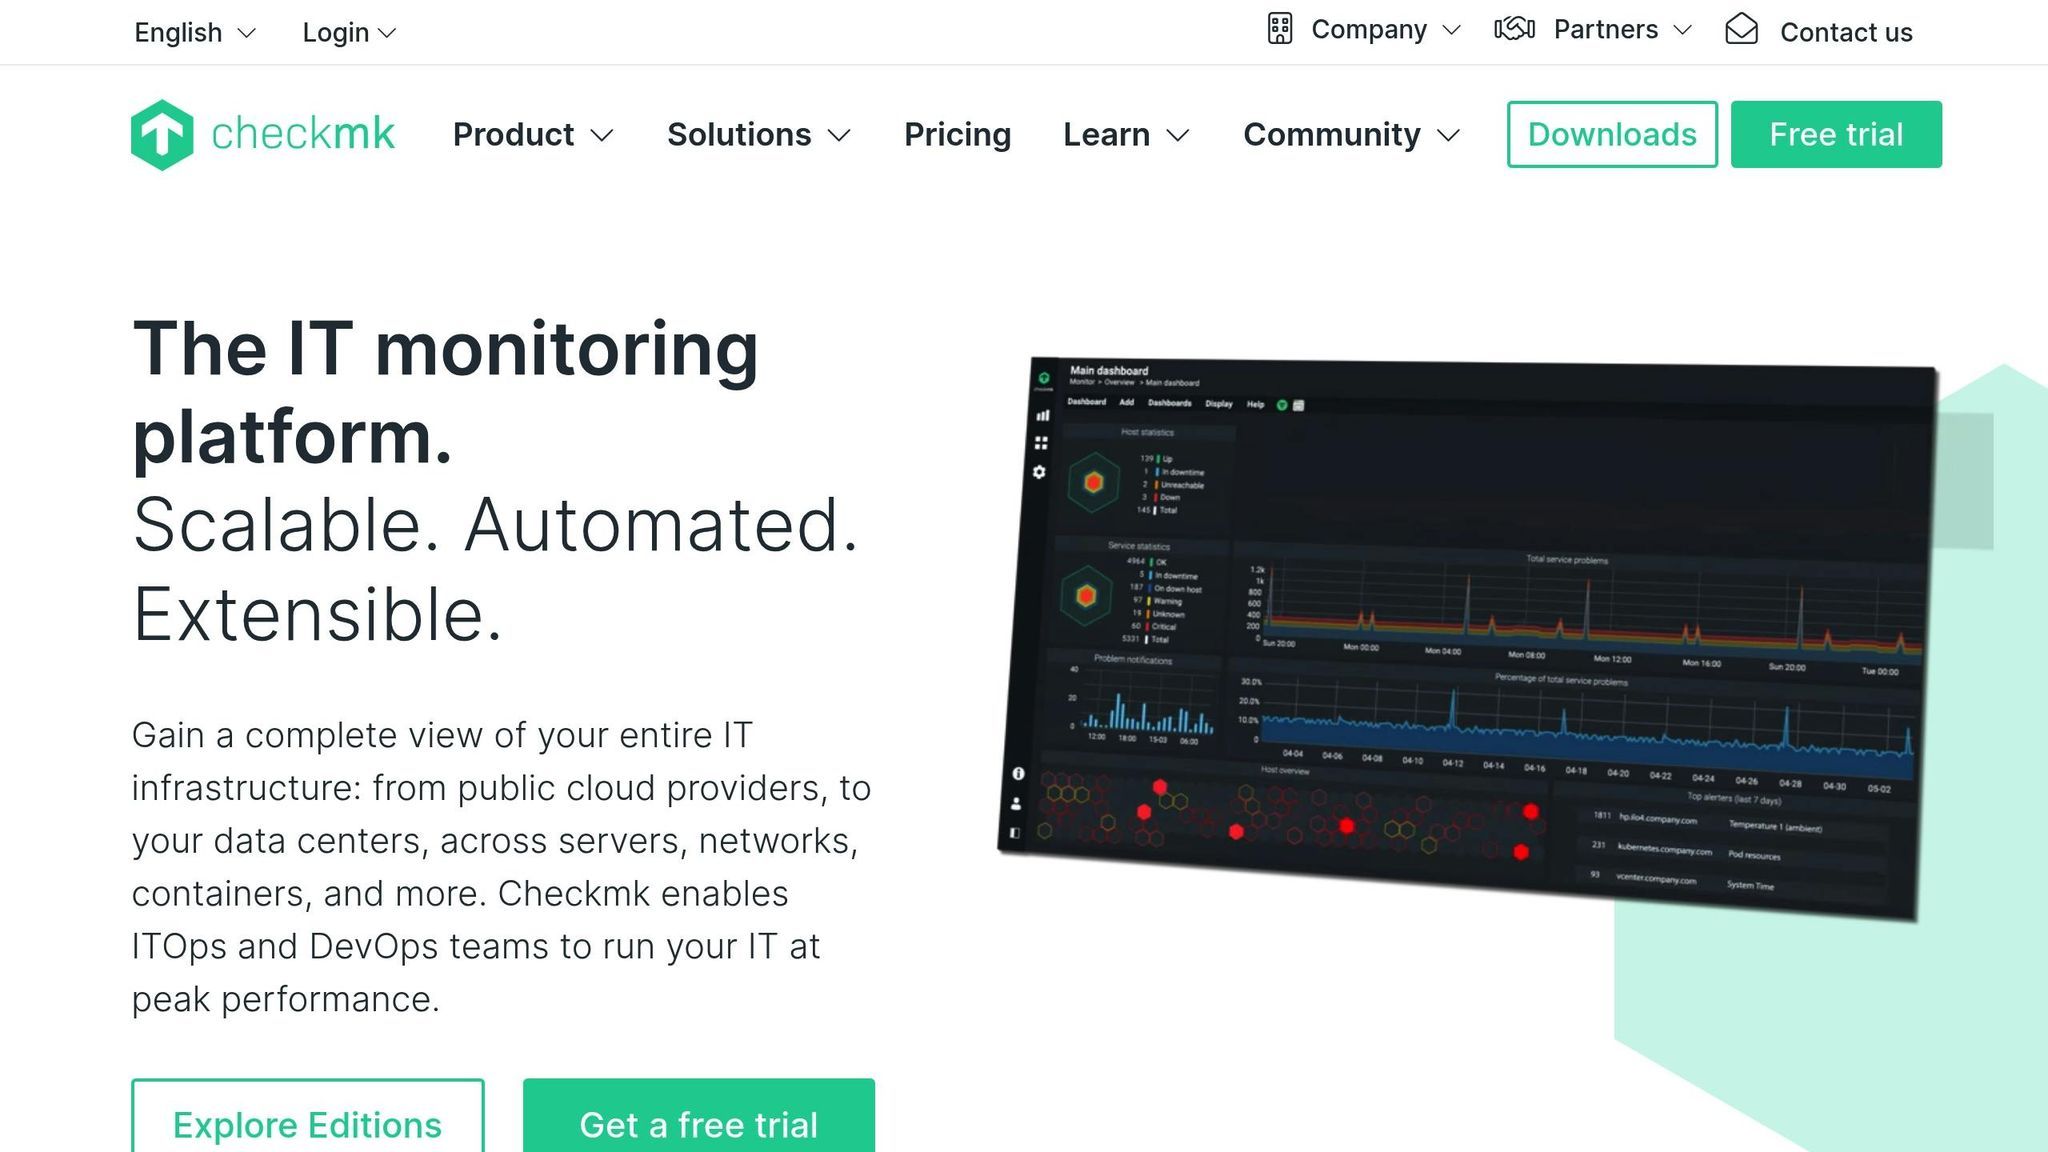
Checkmk è una potente piattaforma di monitoraggio progettata per la gestione di server dedicati e ambienti VPS. Una delle sue caratteristiche distintive è la capacità di individuare e monitorare automaticamente dispositivi di rete, server e servizi non appena si connettono, risparmiandovi la seccatura della configurazione manuale.
Ambito di monitoraggio
Checkmk copre un ampio ambito di monitoraggio, tenendo traccia di infrastrutture, reti, applicazioni, container e servizi cloud da un'unica piattaforma. Offre controlli approfonditi su host e servizi attraverso il suo ampio catalogo di plugin di monitoraggio, consentendo di monitorare lo stato di salute dell’hardware, i database, i sistemi di archiviazione, i livelli di virtualizzazione e le applicazioni personalizzate. Raccoglie metriche dettagliate a intervalli brevi e mette in correlazione i cambiamenti di stato tra i sistemi per evidenziare i problemi emergenti. Il suo design ibrido supporta sia il monitoraggio basato su agent che quello senza agent, garantendo flessibilità tra data center, configurazioni on-premise e ambienti distribuiti.
Funzionalità in tempo reale
Checkmk fornisce dashboard in tempo reale che si aggiornano continuamente, mostrando lo stato degli host, i controlli dei servizi e le metriche delle prestazioni man mano che cambiano. Supporta il polling veloce per gli host critici ed è in grado di visualizzare grafici in tempo reale relativi al carico, alla memoria, alla rete e allo stato di salute delle applicazioni. I dashboard sono personalizzabili, consentendo ai team di evidenziare i sistemi prioritari e individuare rapidamente i problemi urgenti. Il suo efficiente nucleo di monitoraggio mantiene basso il sovraccarico anche con migliaia di controlli al minuto, consentendo alle grandi configurazioni di mantenere una visibilità reattiva in tempo reale.
Funzionalità di IA e automazione
Checkmk include la regolazione automatica delle soglie e l’elaborazione intelligente delle regole che riducono l’affaticamento da avvisi adattandosi al comportamento di base. È in grado di individuare automaticamente host e servizi e di applicare regole di monitoraggio predefinite senza necessità di configurazione manuale. Le funzioni predittive supportano l’analisi delle tendenze e la pianificazione della capacità, aiutando i team a individuare tempestivamente i rischi di saturazione. Per gli ambienti complessi, il suo sistema di automazione basato su regole semplifica gli aggiornamenti di configurazione, l’attivazione dei controlli e la logica di notifica. Le funzionalità di IA più avanzate richiedono solitamente l’integrazione con strumenti di analisi esterni, poiché Checkmk si concentra sul monitoraggio deterministico piuttosto che sulla completa automazione degli incidenti.
Facilità di implementazione
Checkmk è semplice da implementare grazie a un processo di installazione rapido e a guide di configurazione chiare. L’edizione «raw» utilizza componenti open source, mentre l’edizione «enterprise» include un’interfaccia utente ottimizzata e miglioramenti delle prestazioni. Gli agenti possono essere installati con un piccolo script e il rilevamento automatico individua immediatamente i nuovi servizi. Si integra bene con ambienti virtualizzati e containerizzati e si adatta facilmente tramite siti di monitoraggio distribuiti per implementazioni di grandi dimensioni o multiregionali. Poiché offre solide impostazioni predefinite pronte all’uso, i team possono rendere operativo rapidamente un sistema di monitoraggio completo senza necessità di una messa a punto approfondita.
Prezzi
Checkmk offre un’edizione "raw" gratuita che include il monitoraggio di base, i dashboard e gli avvisi, rendendola adatta a piccoli team o ambienti di laboratorio. L’edizione "enterprise" aggiunge funzionalità avanzate quali prestazioni migliori, automazione estesa, analisi predittiva e reportistica a lungo termine. Il prezzo dell’edizione Enterprise si basa in genere sul numero di host monitorati, a partire da un livello base accessibile e scalabile per infrastrutture più grandi. Ciò mantiene i costi complessivi prevedibili e vantaggiosi per le organizzazioni che desiderano un potente sistema di monitoraggio senza elevati costi di utilizzo in stile SaaS.
5. Datadog
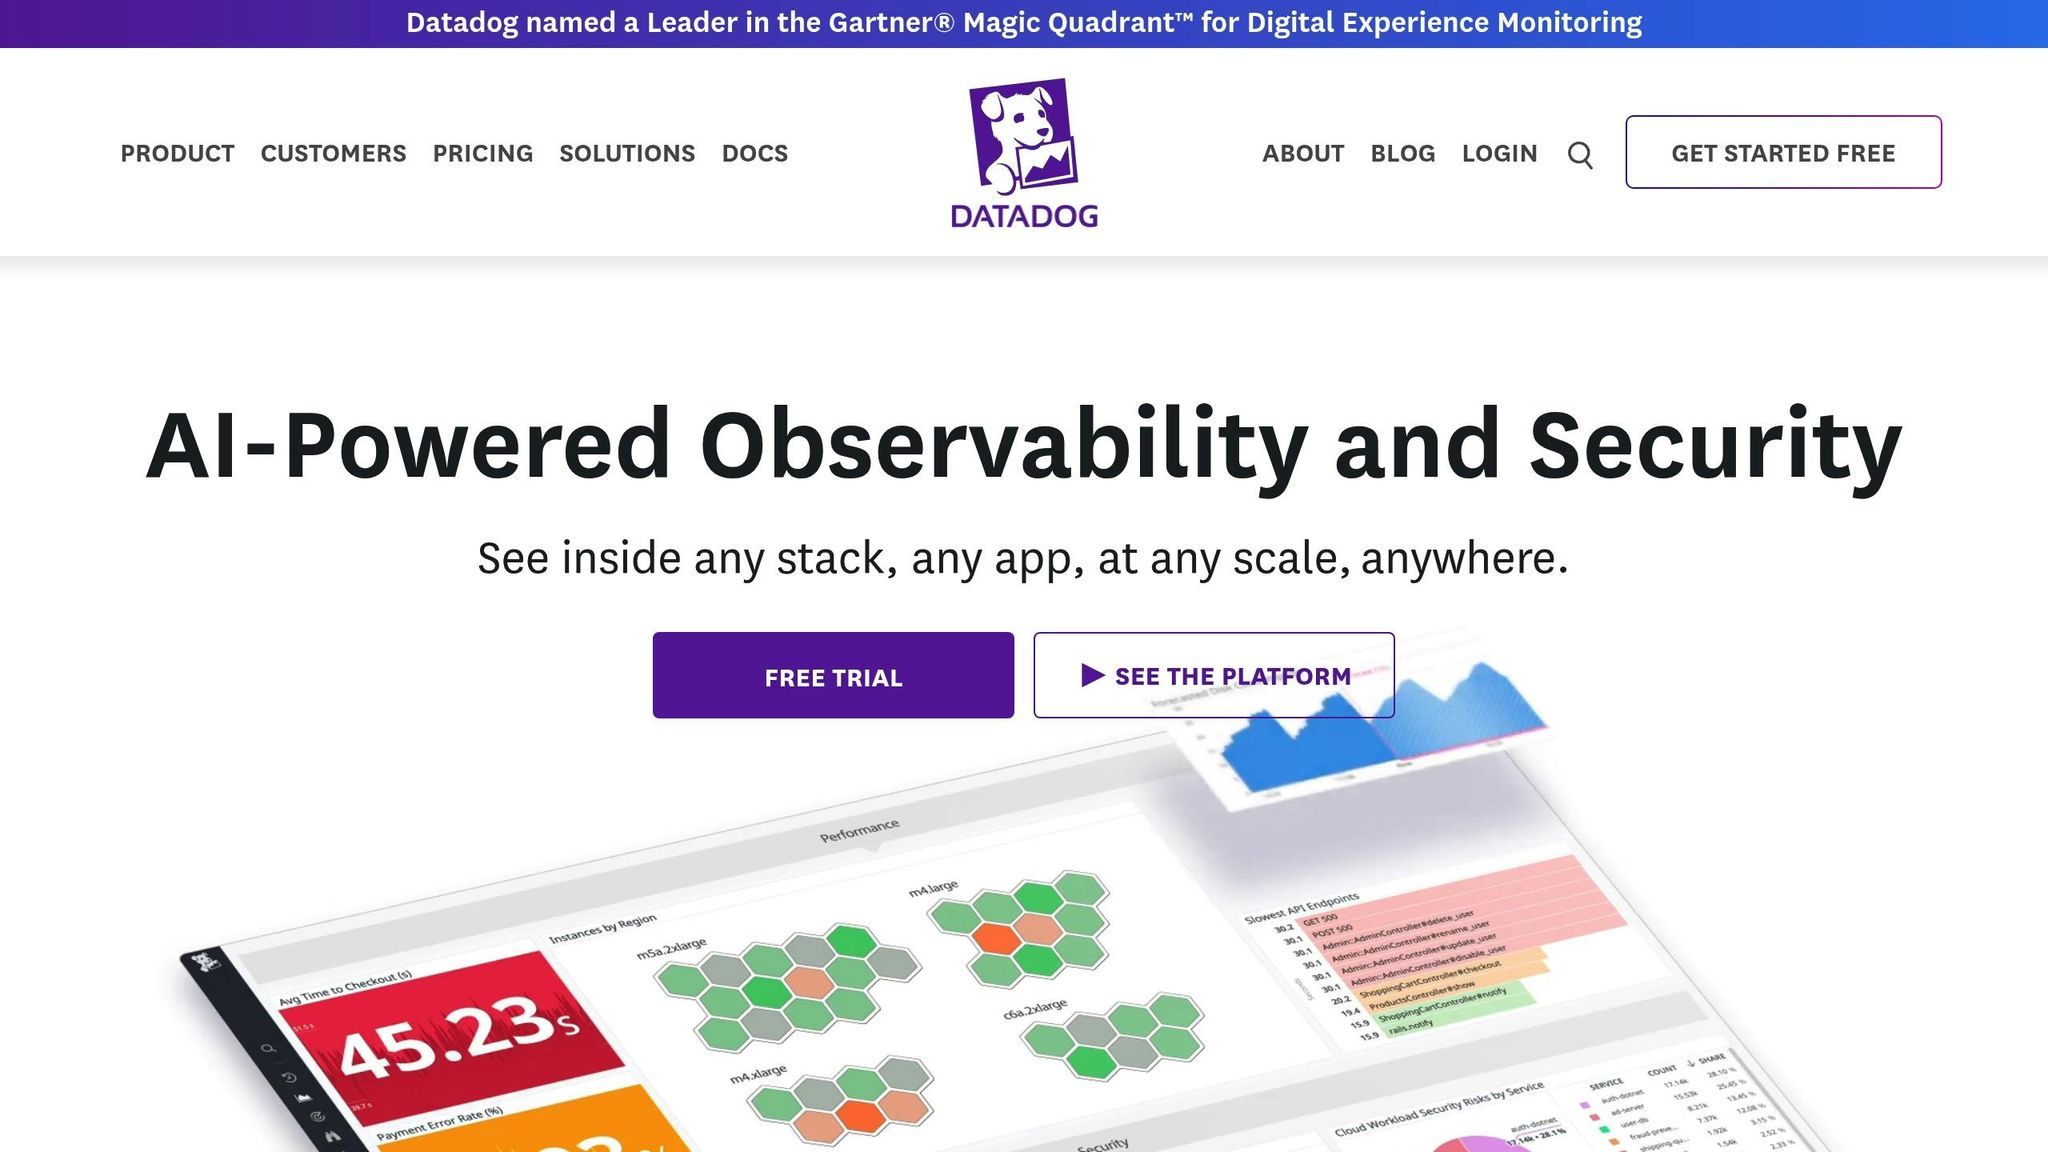
Datadog porta il monitoraggio di server e VPS a un livello superiore, analizzando in profondità le prestazioni a livello di codice. Grazie al tracciamento distribuito basato sull’intelligenza artificiale, ti aiuta a individuare con precisione i colli di bottiglia nelle prestazioni e a rilevare le anomalie non appena si verificano. Collegando i log delle applicazioni alle metriche di sistema, Datadog semplifica l’individuazione delle cause alla radice dei problemi e la loro rapida risoluzione, garantendo il funzionamento regolare della tua infrastruttura.
Ambito di monitoraggio
Datadog riunisce metriche dell’infrastruttura, log, tracciati e segnali di sicurezza in un’unica piattaforma di osservabilità. È in grado di acquisire dati telemetrici da host, container, funzioni serverless, servizi cloud gestiti e applicazioni personalizzate. Le sue integrazioni coprono centinaia di tecnologie, consentendoti di monitorare il comportamento dei database, le prestazioni delle API, i cluster Kubernetes e i carichi di lavoro cloud-native da un'unica vista unificata. I dati vengono raccolti ad alta frequenza e correlati tra metriche, log e tracce per rivelare modelli di prestazioni e colli di bottiglia. Questo ampio ambito aiuta i team a comprendere come ogni parte del proprio stack si comporti sotto carico reale.
Funzionalità in tempo reale
Datadog offre dashboard in tempo reale che si aggiornano continuamente, mostrando l’utilizzo della CPU, la latenza delle richieste, lo stato dei container, la larghezza di banda di rete e altro ancora man mano che cambiano. È possibile personalizzare le dashboard per evidenziare i segnali rilevanti ai fini di una diagnosi rapida. Supporta inoltre gli avvisi in tempo reale, in modo che problemi quali picchi di errori o saturazione della memoria possano attivare notifiche non appena si verificano. Anche in presenza di grandi volumi di dati, il suo agente e il backend SaaS sono progettati per mantenere basso il sovraccarico, garantendo al contempo una visibilità aggiornata al secondo su tutti i sistemi distribuiti.
Funzionalità di IA e automazione
Datadog include strumenti basati sull’intelligenza artificiale che analizzano le linee di base storiche per rilevare anomalie e ridurre il rumore causato dai falsi positivi. La sua suite Bits AI aggiunge il triage automatizzato, la correlazione tra segnali e i riepiloghi degli incidenti per accelerare le indagini. È in grado di suggerire le probabili cause alla radice, proporre misure correttive a livello di codice o di configurazione e generare documentazione dopo gli incidenti. È inoltre possibile creare flussi di lavoro utilizzando il linguaggio naturale, trasformando le attività operative di routine in sequenze automatizzate senza dover scrivere script. Ciò aiuta i team a semplificare i processi di risposta, mantenendo al contempo il controllo sui percorsi di escalation.
Facilità di implementazione
Datadog è semplice da implementare grazie al suo agente leggero e al design cloud-native. È possibile installare l’agente con un unico script, utilizzare immagini Docker o distribuirlo tramite Kubernetes con Helm. Le sue integrazioni rilevano automaticamente i servizi e iniziano a raccogliere dati di telemetria con una configurazione minima. Poiché tutto viene eseguito sulla piattaforma ospitata da Datadog, non è necessario gestire alcun backend. Si adatta facilmente sia agli ambienti ibridi che a quelli multi-cloud e si adatta alle infrastrutture in rapida evoluzione, rendendolo adatto ai team che desiderano una visibilità completa senza dover gestire il proprio stack di monitoraggio.
Prezzi
Datadog opera con un modello di prezzi modulare, in cui i piani base vengono addebitati per host monitorato e le funzionalità opzionali vengono fatturate in base all’utilizzo. Il livello Pro parte da circa 15 dollari al mese per host con fatturazione annuale, mentre i piani Enterprise hanno un costo maggiore e includono funzionalità avanzate di governance e intelligenza artificiale. Si applicano costi aggiuntivi per log, tracce, test sintetici, metriche personalizzate e conservazione estesa. Ciò consente ai team di adottare solo i componenti di cui hanno bisogno, anche se i costi possono aumentare rapidamente in ambienti con molti host o con un'elevata acquisizione di log. Rimane un'opzione flessibile per le organizzazioni che desiderano un'osservabilità completa supportata da una piattaforma SaaS matura.
Pro e contro
Dopo aver esaminato le caratteristiche di ciascuno strumento, analizziamo i loro punti di forza e i loro limiti per aiutarti a decidere quale si adatti meglio alle tue esigenze. La scelta giusta dipenderà da fattori quali funzionalità, facilità d’uso e budget.
Prometheus offre prestazioni eccezionali grazie a un’efficiente raccolta di dati in serie temporali e a un solido linguaggio di query (PromQL) su misura per le configurazioni cloud-native. Tuttavia, manca di strumenti di visualizzazione integrati e di capacità di archiviazione a lungo termine, rendendo necessarie soluzioni esterne per queste funzionalità.
Grafana eccelle nella visualizzazione dei dati flessibile e avanzata, integrandosi perfettamente con varie fonti di dati, tra cui Prometheus, per creare dashboard visivamente accattivanti. Il suo principale limite è l’assenza di una raccolta dati nativa, il che lo rende dipendente da strumenti esterni per l’acquisizione dei dati.
Zabbix è una soluzione di monitoraggio scalabile e completa. Essendo open-source, elimina i costi di licenza ma spesso richiede una configurazione più complessa e una manutenzione continua, che può richiedere molte risorse.
Netdata si distingue per il suo design leggero e il monitoraggio delle prestazioni in tempo reale, vantando un processo di configurazione rapido, spesso completato in pochi minuti. Ciò lo rende un’ottima scelta per ambienti di piccole e medie dimensioni. Tuttavia, presenta funzionalità limitate per l’analisi dei dati storici a lungo termine e offre un sistema di avvisi più basilare rispetto alle piattaforme di livello enterprise.
Checkmk offre un monitoraggio scalabile con metriche in tempo reale e avvisi personalizzabili, rendendolo ideale per implementazioni di server su larga scala. Le sue funzionalità avanzate, tuttavia, comportano una curva di apprendimento più ripida e una maggiore complessità di configurazione man mano che le dimensioni dell’implementazione aumentano.
Datadog offre un’esperienza di monitoraggio onnicomprensiva con approfondimenti basati sull’intelligenza artificiale, che copre l’infrastruttura, le applicazioni e la gestione dei log. Sebbene le sue funzionalità siano ampie, i costi di abbonamento possono aumentare rapidamente (ad esempio, 15 dollari USA al mese per host per l’infrastruttura, con costi aggiuntivi per l’APM e la gestione dei log). Inoltre, padroneggiare le sue funzionalità avanzate richiede un investimento significativo in termini di tempo e formazione.
La tabella seguente riassume i principali vantaggi, svantaggi e strutture dei costi di ciascuno strumento per un rapido confronto:
| Strumento | Punti di forza principali | Punti deboli principali | Struttura dei costi |
|---|---|---|---|
| Prometheus | Raccolta efficiente dei dati delle serie temporali e potente linguaggio di query | Manca di funzionalità integrate di visualizzazione e archiviazione | Open source (solo costi operativi) |
| Grafana | Visualizzazione flessibile e avanzata con supporto multi-sorgente | Nessuna raccolta dati nativa | Open source (solo costi operativi) |
| Zabbix | Monitoraggio scalabile e completo per configurazioni IT tradizionali | Configurazione e manutenzione complesse | Gratuito (con costi di hosting e manutenzione) |
| Netdata | Monitoraggio leggero e in tempo reale con configurazione rapida | Analisi dei dati storici e avvisi limitati | A partire da 4,50 USD al mese per nodo |
| Checkmk | Monitoraggio scalabile con metriche in tempo reale e avvisi personalizzati | Curva di apprendimento ripida per le funzionalità avanzate | Circa 80 dollari al mese per circa 100 host |
| Datadog | Monitoraggio esteso su scala cloud con analisi basate sull’intelligenza artificiale | Costi più elevati e curva di apprendimento ripida | A partire da 15 dollari al mese per host (più costi aggiuntivi) |
La vostra decisione dipende in ultima analisi dalle competenze del vostro team e dal budget a disposizione. Strumenti open source come Prometheus e Zabbix possono rivelarsi molto efficaci se il vostro team possiede le competenze tecniche necessarie per gestirli. D'altra parte, le opzioni commerciali come Checkmk, Netdata e Datadog offrono soluzioni pronte all'uso che riducono lo sforzo interno, ma spesso comportano costi più elevati.
Conclusione
La scelta dello strumento di monitoraggio più adatto per il proprio server dedicato o VPS nel 2025 dipende dalla comprensione del proprio ambiente specifico, dalle competenze tecniche e dai vincoli di budget.
Per configurazioni più piccole o per chi necessita di risultati rapidi, Netdata rappresenta una scelta valida. Le sue analisi in tempo reale e la configurazione semplice lo rendono ideale per un monitoraggio immediato senza richiedere una configurazione complessa.
Gli ambienti più grandi e complessi richiedono spesso soluzioni scalabili. Se si lavora con sistemi cloud-native o containerizzati, Prometheus e Grafana sono ottime opzioni. Combinano una potente raccolta di dati in serie temporali con visualizzazioni personalizzabili, sebbene richiedano un livello più elevato di competenza tecnica per una gestione efficace.
Per le grandi aziende, vale la pena prendere in considerazione Checkmk e Datadog. Checkmk offre ampie funzionalità di monitoraggio e può risultare conveniente in termini di costi per implementazioni su larga scala. D’altra parte, Datadog eccelle grazie alle sue analisi basate sull’intelligenza artificiale e alle integrazioni estese, sebbene la scalabilità possa richiedere una pianificazione delle risorse più accurata.
Negli ambienti IT tradizionali con infrastrutture eterogenee, Zabbix rimane un valido concorrente. Sebbene la sua configurazione possa risultare più complessa, le sue solide funzionalità e l’assenza di costi di licenza lo rendono interessante per le organizzazioni che dispongono di amministratori di sistema dedicati.
In definitiva, la migliore soluzione di monitoraggio è quella che si allinea alla capacità del vostro team di gestirla in modo efficace. Uno strumento ricco di funzionalità può diventare rapidamente un peso se sovraccarica la vostra capacità operativa. Iniziare con un’opzione leggera come Netdata vi permette di stabilire una linea di base per il monitoraggio, con la flessibilità di adottare piattaforme più complete man mano che la vostra infrastruttura e le vostre competenze crescono.
L’obiettivo è concentrarsi su un monitoraggio coerente e utilizzabile, piuttosto che rincorrere ogni funzionalità avanzata. Adottando un approccio graduale e su misura, potrete garantire che la vostra strategia di monitoraggio si evolva di pari passo con le esigenze del vostro ambiente di hosting.
Domande frequenti
In che modo l’intelligenza artificiale e l’automazione miglioreranno il monitoraggio dei server nel 2025 e quali strumenti offrono queste funzionalità?
Nel 2025, l’IA e l’automazione stanno trasformando il monitoraggio dei server, rendendo la gestione dei server dedicati e dei VPS più intelligente, efficiente e reattiva. Grazie ai sistemi basati sull’IA, è possibile identificare modelli anomali, anticipare potenziali guasti e risolvere automaticamente i problemi di routine. Questo approccio riduce i tempi di inattività e aumenta l’affidabilità complessiva dei server.
Strumenti come Dynatrace, Logz.io e Datadog sono all’avanguardia nell’integrazione dell’IA e dell’automazione. Forniscono approfondimenti in tempo reale, rilevano anomalie e offrono analisi predittive progettate specificamente per ambienti di hosting ad alte prestazioni. Queste funzionalità garantiscono che i server funzionino in modo fluido e sicuro, anche in presenza di carichi di lavoro intensi.
Cosa devo considerare quando devo scegliere tra strumenti di monitoraggio open source e a pagamento per il mio server o VPS?
Nel valutare le opzioni tra strumenti di monitoraggio open source e a pagamento, è essenziale considerare quale si adatti meglio alle proprie esigenze e risorse. Gli strumenti open source sono in genere gratuiti e offrono un elevato grado di personalizzazione, il che è l’ideale se si dispone delle competenze tecniche necessarie e si ha bisogno di una soluzione flessibile. Al contrario, gli strumenti a pagamento sono spesso dotati di interfacce intuitive, funzionalità avanzate e assistenza dedicata, aiutandovi a risparmiare tempo e a semplificare il processo.
Per fare la scelta giusta, considera alcuni fattori chiave: il tuo budget, il livello di assistenza di cui potresti aver bisogno, la facilità di configurazione dello strumento e la sua capacità di adattarsi all’evoluzione delle esigenze del tuo server o VPS. Prenderti il tempo necessario per valutare questi elementi ti aiuterà a scegliere l’opzione più in linea con i tuoi obiettivi di monitoraggio e prestazioni.
Qual è il modo migliore per garantire che la soluzione di monitoraggio del server si adatti alla crescita della tua infrastruttura?
Per mantenere la tua soluzione di monitoraggio al passo con la tua infrastruttura in espansione, è essenziale concentrarsi su strumenti e strategie che privilegino la scalabilità e l’automazione. Opta per piattaforme in grado di gestire architetture distribuite, consentendo un monitoraggio fluido di più server o macchine virtuali man mano che il tuo sistema cresce. Funzionalità come l’analisi basata sull’intelligenza artificiale e i dashboard in tempo reale sono particolarmente utili: possono gestire volumi di dati più grandi e fornire comunque informazioni significative senza rallentamenti.
È inoltre consigliabile scegliere strumenti che includano avvisi personalizzabili e si integrino facilmente con i flussi di lavoro esistenti. In questo modo, è possibile individuare e risolvere rapidamente i problemi man mano che l’infrastruttura si evolve. Prendete l’abitudine di valutare e ottimizzare regolarmente la vostra configurazione di monitoraggio per garantire che rimanga efficiente e affidabile durante tutto il percorso di crescita.

Come ospitare i modelli di intelligenza artificiale di Ollama su server dedicati
Scopri come ospitare i modelli di Ollama AI su server dedicati per garantire la sicurezza dei dati, assicurare la scalabilità e migliorare le prestazioni.
5 min di lettura - 8 settembre 2025
Come installare e utilizzare Redis su un VPS
9 min di lettura - 7 gennaio 2026

Avete domande o avete bisogno di una soluzione personalizzata?

Opzioni flessibili

Portata globale

Distribuzione immediata
Opzioni flessibili
Portata globale
Distribuzione immediata