
Моніторинг вашого виділеного сервера або VPS: які варіанти будуть доступні у 2025 році?
12 хв читання - 28 листопада 2025 р.
Ознайомтеся з найкращими інструментами моніторингу для виділених серверів та VPS у 2025 році, зосередивши увагу на штучному інтелекті, автоматизації та аналітиці в режимі реального часу.
Моніторинг вашого виділеного сервера або VPS: які варіанти будуть доступні у 2025 році?
Моніторинг вашого виділеного сервера або VPS у 2025 році полягає в тому, щоб випереджати потенційні проблеми за допомогою розумніших та ефективніших інструментів. Сучасні рішення використовують штучний інтелект, аналітику в режимі реального часу та автоматизацію для прогнозування збоїв, відстеження продуктивності та скорочення часу простою. Ось короткий огляд найкращих варіантів:
- Prometheus + Grafana: дует з відкритим кодом для збору часових рядів даних та налаштовуваних інформаційних панелей. Чудово підходить для хмарних середовищ.
- Zabbix: моніторинг корпоративного рівня з потужними функціями оповіщення та відображення взаємозалежностей для складних інфраструктур.
- Netdata: легкий моніторинг продуктивності в режимі реального часу з швидким налаштуванням.
- Checkmk: масштабований моніторинг з автоматичним виявленням пристроїв та детальною аналітикою.
- Datadog: моніторинг, орієнтований на хмарні середовища, з функціями на основі штучного інтелекту та глибоким трасуванням додатків.
Кожен інструмент відповідає різним потребам — від невеликих систем до великих підприємств. Нижче наведено коротке порівняння, яке допоможе вам визначитися:
Коротке порівняння
| Інструмент | Найкраще підходить для | Ключові функції | Вартість |
|---|---|---|---|
| Prometheus + Grafana | Хмарні середовища | Дані часових рядів, настроювані інформаційні панелі | Безкоштовно (самостійне розміщення) |
| Zabbix | Складні ІТ-конфігурації | Картування залежностей, з агентами/без агентів | Безкоштовно (самостійне розміщення) |
| Netdata | Моніторинг продуктивності в режимі реального часу | Легкі, миттєві метрики | Безкоштовно/$4,50 за вузол |
| Checkmk | Масштабні розгортання | Автоматичне виявлення, широкий обсяг моніторингу | ~80 доларів на місяць (100 хостів) |
| Datadog | Моніторинг на рівні хмари та додатків | Аналітика на основі штучного інтелекту, трасування додатків, інтеграції | 15+ доларів за хост на місяць |
Обирайте, виходячи з розміру вашої інфраструктури, технічних знань та бюджету. Інструменти з відкритим кодом, такі як Prometheus та Zabbix, є економічно вигідними, але вимагають більше налаштувань, тоді як платні варіанти, такі як Datadog, пропонують простоту використання та розширені функції. Почніть з малого та масштабуйте систему у міру зростання ваших потреб.
Повний посібник з моніторингу серверів | Курс з моніторингу № 2
1. Prometheus та Grafana
Prometheus та Grafana разом утворюють одне з найефективніших рішень для моніторингу з відкритим кодом, доступних на сьогодні. Prometheus зосереджується на зборі та зберіганні даних, тоді як Grafana перетворює ці дані на візуально інтуїтивні інформаційні панелі. Таке поєднання забезпечує гнучкий та економічно вигідний спосіб моніторингу виділених серверів та VPS-середовищ.
Сфера моніторингу
Prometheus добре відомий своєю здатністю збирати дані часових рядів у різних системах. Він відстежує ключові показники, такі як завантаження процесора, споживання пам’яті та дискові операції вводу-виводу, а також обробляє більш спеціалізовані статистичні дані, пов’язані з конкретними додатками. Використовуючи модель на основі витягування даних (pull), він отримує показники з налаштованих кінцевих точок через регулярні проміжки часу, що робить його придатним для моніторингу як контейнеризованих середовищ, так і традиційних серверів «bare-metal».
Щоб розширити свої можливості, Prometheus підтримує численні офіційні експортери, що дозволяє йому збирати дані практично з будь-якої служби чи програми, що працює у вашій інфраструктурі.
Grafana доповнює Prometheus, відображаючи ці дані на настроюваних інформаційних панелях. Ці інформаційні панелі можуть містити графіки в режимі реального часу, теплові карти та статуси сповіщень. Крім того, Grafana інтегрує дані з різних джерел, надаючи вам єдиний та всебічний огляд продуктивності вашої системи.
Можливості роботи в режимі реального часу
Prometheus збирає метрики з інтервалами, які можна налаштувати з частотою навіть кожні кілька секунд, хоча за замовчуванням вони зазвичай становлять від 15 до 30 секунд. З іншого боку, інформаційні панелі Grafana автоматично оновлюються при надходженні нових даних. Ви можете налаштувати інтервали оновлення відповідно до своїх потреб — чи то кожні кілька секунд, чи то через довший проміжок часу. Така швидка реакція є надзвичайно цінною для відстеження раптових сплесків трафіку або вузьких місць у ресурсах, що гарантує, що ви завжди будете в курсі продуктивності системи та готові вжити заходів у разі виникнення будь-яких проблем.
Функції штучного інтелекту та автоматизації
Хоча Prometheus і Grafana не є в першу чергу системами на основі штучного інтелекту, вони все ж містять функції автоматизації для покращення моніторингу. Prometheus включає Alertmanager, який надсилає сповіщення на основі заздалегідь визначених умов. Ця система підтримує складні правила сповіщень, використовуючи для точності як показники в режимі реального часу, так і історичні дані.
Grafana запровадила інструменти виявлення аномалій, які використовують машинне навчання для виявлення нетипових закономірностей у ваших метриках. Ці інструменти допомагають зменшити кількість помилкових тривог, вивчаючи типову поведінку вашої системи. Вони також можуть підтримувати автоматизацію, запускаючи такі дії, як масштабування ресурсів або сповіщення систем оркестрування у разі перевищення порогових значень.
Простота розгортання
Налаштування Prometheus та Grafana є простим. Обидва інструменти можуть працювати в контейнерах Docker, що забезпечує узгоджене встановлення на різних операційних системах. За допомогою таких інструментів, як docker-compose, ви можете розгорнути повний стек моніторингу всього за кілька хвилин.
Для тих, хто використовує виділені сервери, обидві програми також можна встановити безпосередньо за допомогою вбудованих менеджерів пакетів у більшості дистрибутивів Linux. Навіть складні конфігурації відносно прості в налаштуванні та усуненні несправностей, що робить цей дует доступним для користувачів із різним рівнем знань.
Ціни
Prometheus і Grafana є повністю безкоштовними та мають відкритий вихідний код, без ліцензійних зборів, обмежень кількості користувачів або обмежень щодо зберігання даних. Це робить їх економічно вигідним рішенням для моніторингу вашої інфраструктури.
Для тих, хто віддає перевагу керованому варіанту, Grafana пропонує хмарний сервіс. Безкоштовний тариф забезпечує базову функціональність, тоді як масштабовані платні тарифи включають додаткові функції та потужність. Хоча багато користувачів вважають, що самостійне розміщення відповідає їхнім потребам, керований сервіс є зручною альтернативою, особливо для тих, хто прагне спростити завдання з технічного обслуговування та підтримки.
2. Zabbix
Zabbix — це потужна платформа моніторингу, яка протягом двох десятиліть вдосконалювалася для задоволення потреб корпоративних середовищ. Вона пропонує уніфікований інтерфейс для управління виділеними серверами та VPS, що робить її надійним вибором для складних конфігурацій.
Сфера моніторингу
Zabbix виходить за межі базових системних показників, забезпечуючи огляд мережевих пристроїв, додатків, баз даних, веб-сервісів та платформ віртуалізації — і все це з централізованої панелі управління. Незалежно від того, чи віддаєте ви перевагу моніторингу на основі агентів чи без них, Zabbix може відстежувати все: від використання процесора та пам’яті до користувацьких показників додатків.
Платформа спрощує управління в динамічних середовищах завдяки автоматичному виявленню нових пристроїв та сервісів. Вона підтримує моніторинг SNMP-пристроїв, виконання запитів до баз даних, перевірку часу відгуку веб-серверів та сканування журналів на наявність помилок.
Однією з видатних особливостей є здатність відображати залежності між компонентами інфраструктури. Ці карти залежностей дають чітке уявлення про те, як взаємодіють сервери, додатки та мережеві компоненти, що полегшує виявлення та усунення проблем.
Можливості роботи в режимі реального часу
Zabbix збирає та обробляє дані моніторингу з інтервалами, які ви можете налаштувати, зазвичай від 30 секунд до 5 хвилин, залежно від важливості показників. Його веб-інтерфейс містить інформаційні панелі, що оновлюються в режимі реального часу, надаючи вам завжди актуальний огляд ваших систем.
Ви можете налаштувати частоту збору різних показників. Наприклад, критично важливі дані можна збирати частіше, тоді як менш важливі показники реєструються рідше. Така гнучкість забезпечує ефективне використання системних ресурсів та місця для зберігання даних.
Функції прогнозування та автоматизації
Використовуючи історичні дані, Zabbix може прогнозувати тенденції для раннього виявлення аномалій. Він також автоматизує реакції, виконуючи скрипти при досягненні певних порогових значень. Наприклад, платформа може автоматично перезапустити службу або запустити скрипт технічного обслуговування при настанні заздалегідь визначених умов.
Система сповіщень розроблена для зменшення надмірної кількості повідомлень. Вона групує пов’язані сповіщення та керує залежностями, гарантуючи, що через обрані вами канали зв’язку надсилаються лише важливі повідомлення.
Простота розгортання
Хоча Zabbix може вимагати трохи більше зусиль під час початкового налаштування, він підтримує різні методи розгортання, зокрема контейнери Docker, віртуальні пристрої та нативні інсталяції на популярних дистрибутивах Linux та системах Windows.
Готові шаблони для широко використовуваних додатків та служб економлять час під час налаштування. Крім того, функції автоматичного виявлення та автоматичної реєстрації Zabbix спрощують процес налаштування моніторингу для нових пристроїв та служб. Ви навіть можете автоматизувати розгортання агентів на серверах за допомогою інструментів управління конфігурацією або вбудованих опцій Zabbix.
Ціни
Zabbix є повністю безкоштовним програмним забезпеченням з відкритим кодом, без ліцензійних зборів та обмежень кількості користувачів. Для тих, хто потребує додаткової підтримки, доступні комерційні пакети підписки, вартість яких залежить від необхідного рівня підтримки.
Основні витрати, пов’язані з використанням Zabbix, включають вартість обладнання, необхідного для сервера та бази даних Zabbix, а також час, витрачений на налаштування та обслуговування. Завдяки широкому набору функцій та відсутності ліцензійних зборів Zabbix залишається сильним конкурентом у сфері моніторингу напередодні 2025 року.
Набридли повільні розгортання або обмеження пропускної здатності? FDC Servers пропонує миттєвий виділений ресурс, глобальне покриття та гнучкі тарифні плани, розроблені для будь-якого масштабу.
Оновити зараз3. Netdata
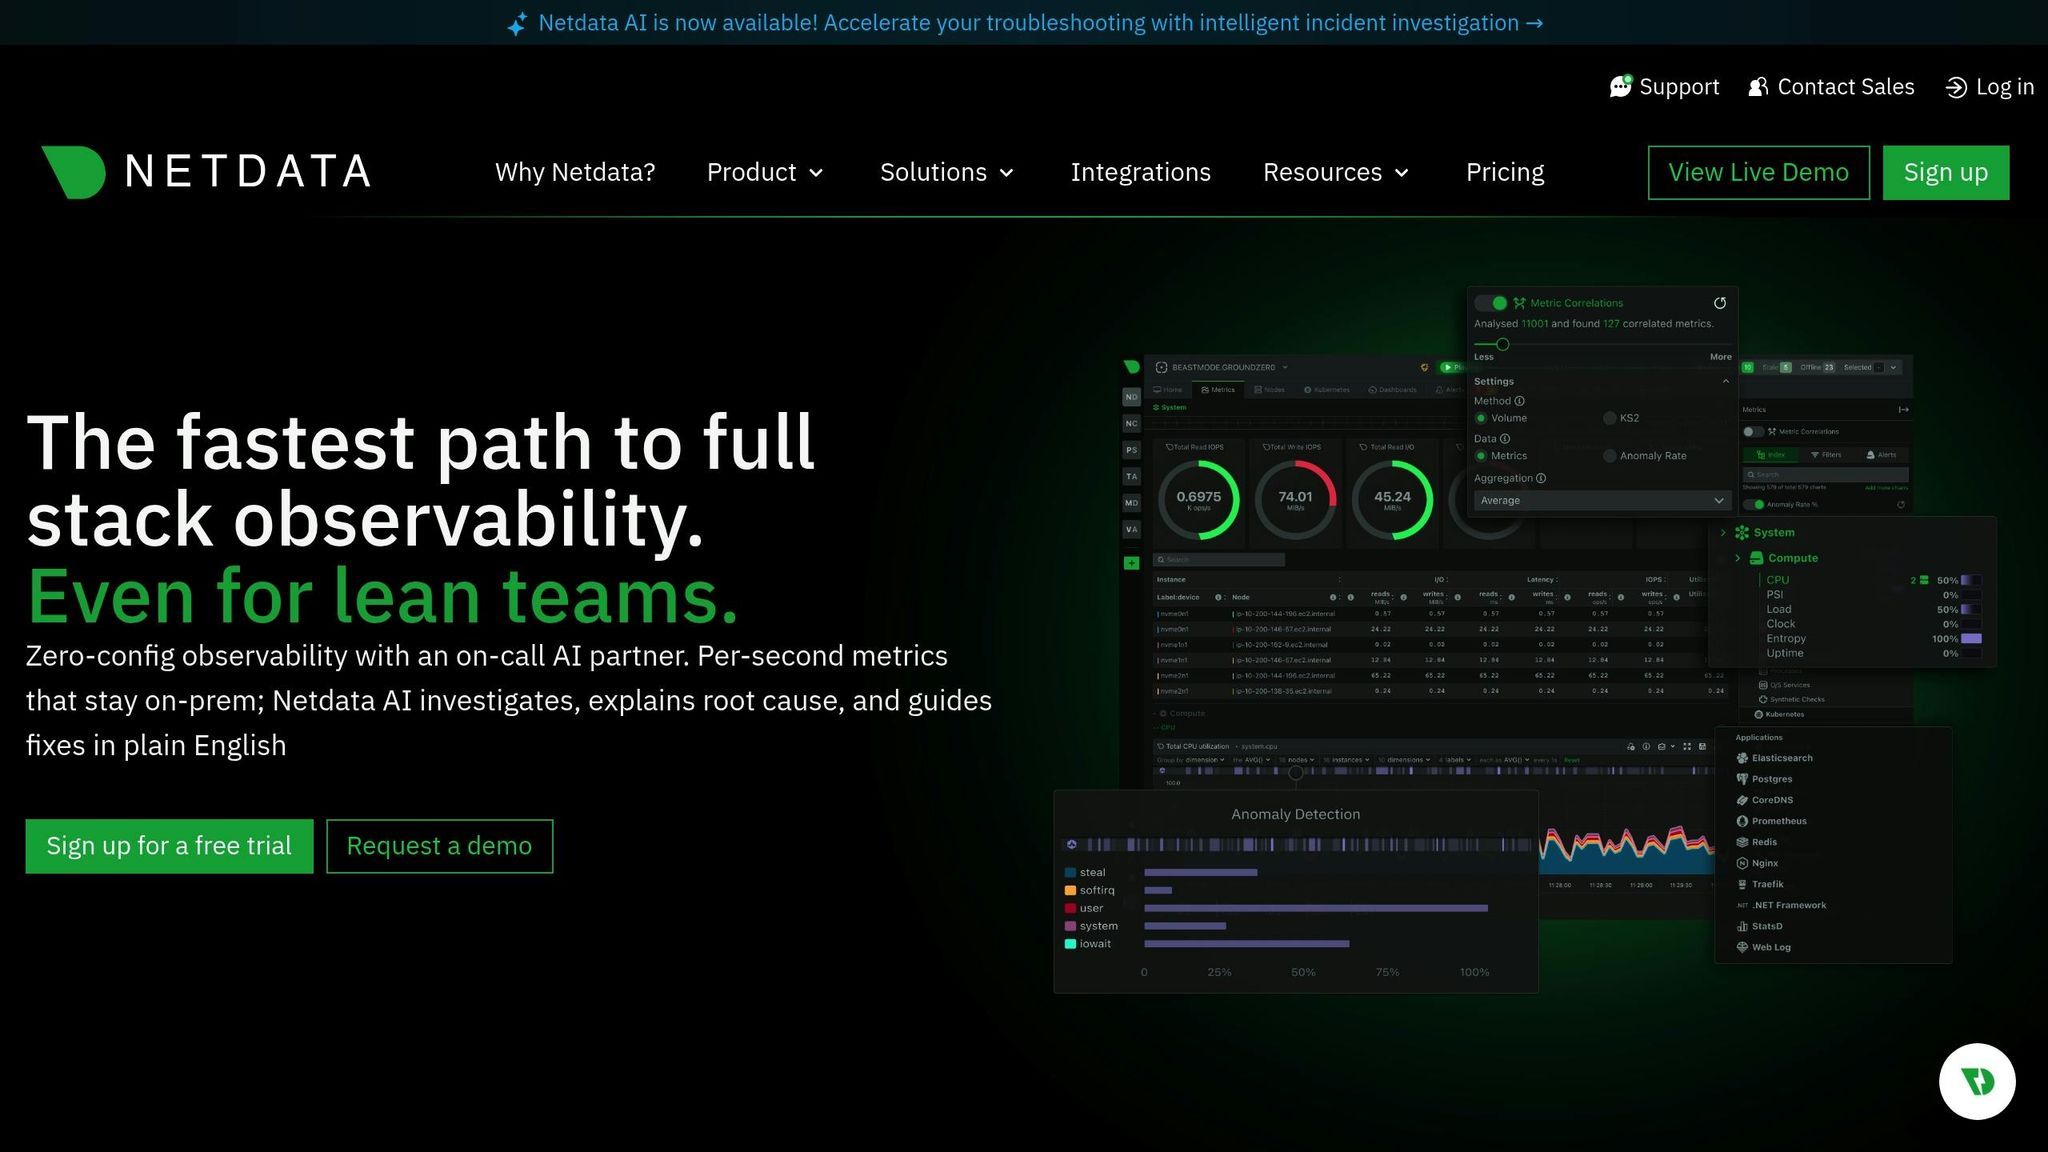
Netdata — це компактний інструмент, призначений для моніторингу продуктивності в режимі реального часу. Його здатність надавати миттєві аналітичні дані з мінімальним навантаженням на системні ресурси робить його ідеальним вибором для організацій, яким потрібна негайна видимість їхньої інфраструктури.
Обсяг моніторингу
Netdata моніторить понад 800 показників, охоплюючи все — від використання процесора та пам’яті до дискових операцій вводу-виводу та мережевого трафіку. Інструмент безперебійно працює на виділених серверах, VPS і навіть надає детальні показники щодо контейнерів. Збираючи дані щосекунди, він майже миттєво фіксує піки навантаження та аномалії. Такий збір даних майже в режимі реального часу доповнює більш ґрунтовний аналіз історичних даних, який пропонують інші інструменти. Він також автоматично відстежує нові служби, додатки та контейнери, щойно вони з’являються в мережі. Для тих, кому потрібне довгострокове зберігання даних або більш розширений аналіз, Netdata може передавати показники на зовнішні платформи, такі як Prometheus або OpenObserve.
Можливості роботи в режимі реального часу
Netdata надає інформаційні панелі в режимі реального часу, які постійно оновлюються, забезпечуючи оперативний огляд стану вашої системи. Ці інформаційні панелі можна налаштовувати, що дозволяє зосередитися на показниках, які мають найбільше значення для швидкого усунення несправностей. Незважаючи на детальність аналітики, компактна архітектура Netdata гарантує роботу з мінімальним споживанням ресурсів.
Функції штучного інтелекту та автоматизації
Netdata використовує виявлення аномалій на основі штучного інтелекту, щоб вивчити нормальну поведінку вашої системи та позначати відхилення як потенційні проблеми. Вона також включає попередньо налаштовані сповіщення, які адаптуються до вашої інфраструктури, зменшуючи кількість помилкових тривог завдяки врахуванню історичних тенденцій та контексту. Однак її менш централізована система сповіщень може вимагати інтеграції із зовнішніми інструментами для більш складних процесів маршрутизації сповіщень або ескалації.
Простота розгортання
Netdata легко налаштовувати, а варіанти встановлення варіюються від простих скриптів до образів Docker. Система підтримує як локальні, так і хмарні середовища, плавно інтегруючись з існуючими стеками моніторингу. Її відкритий код дозволяє налаштовувати систему без прив’язки до конкретного постачальника. Для контейнеризованих конфігурацій образи Docker та діаграми Helm для Kubernetes спрощують розгортання, а функція автоматичного виявлення гарантує, що нові служби та додатки будуть негайно включені до моніторингу.
Ціни
Netdata пропонує безкоштовний план «Community», що включає основні функції, такі як моніторинг у реальному часі, базові сповіщення та зручну веб-панель управління — ідеальний варіант для невеликих систем. Для більших організацій або тих, кому потрібні розширені функції, такі як подовжене зберігання даних, вдосконалене оповіщення та пріоритетна підтримка, вартість платних тарифів починається від 4,50 доларів за вузол на місяць (оплата щорічно). Таке поєднання надійного безкоштовного рівня та доступних платних варіантів робить Netdata доступною для широкого кола користувачів. Далі ми детальніше розглянемо підхід Checkmk до моніторингу.
4. Checkmk
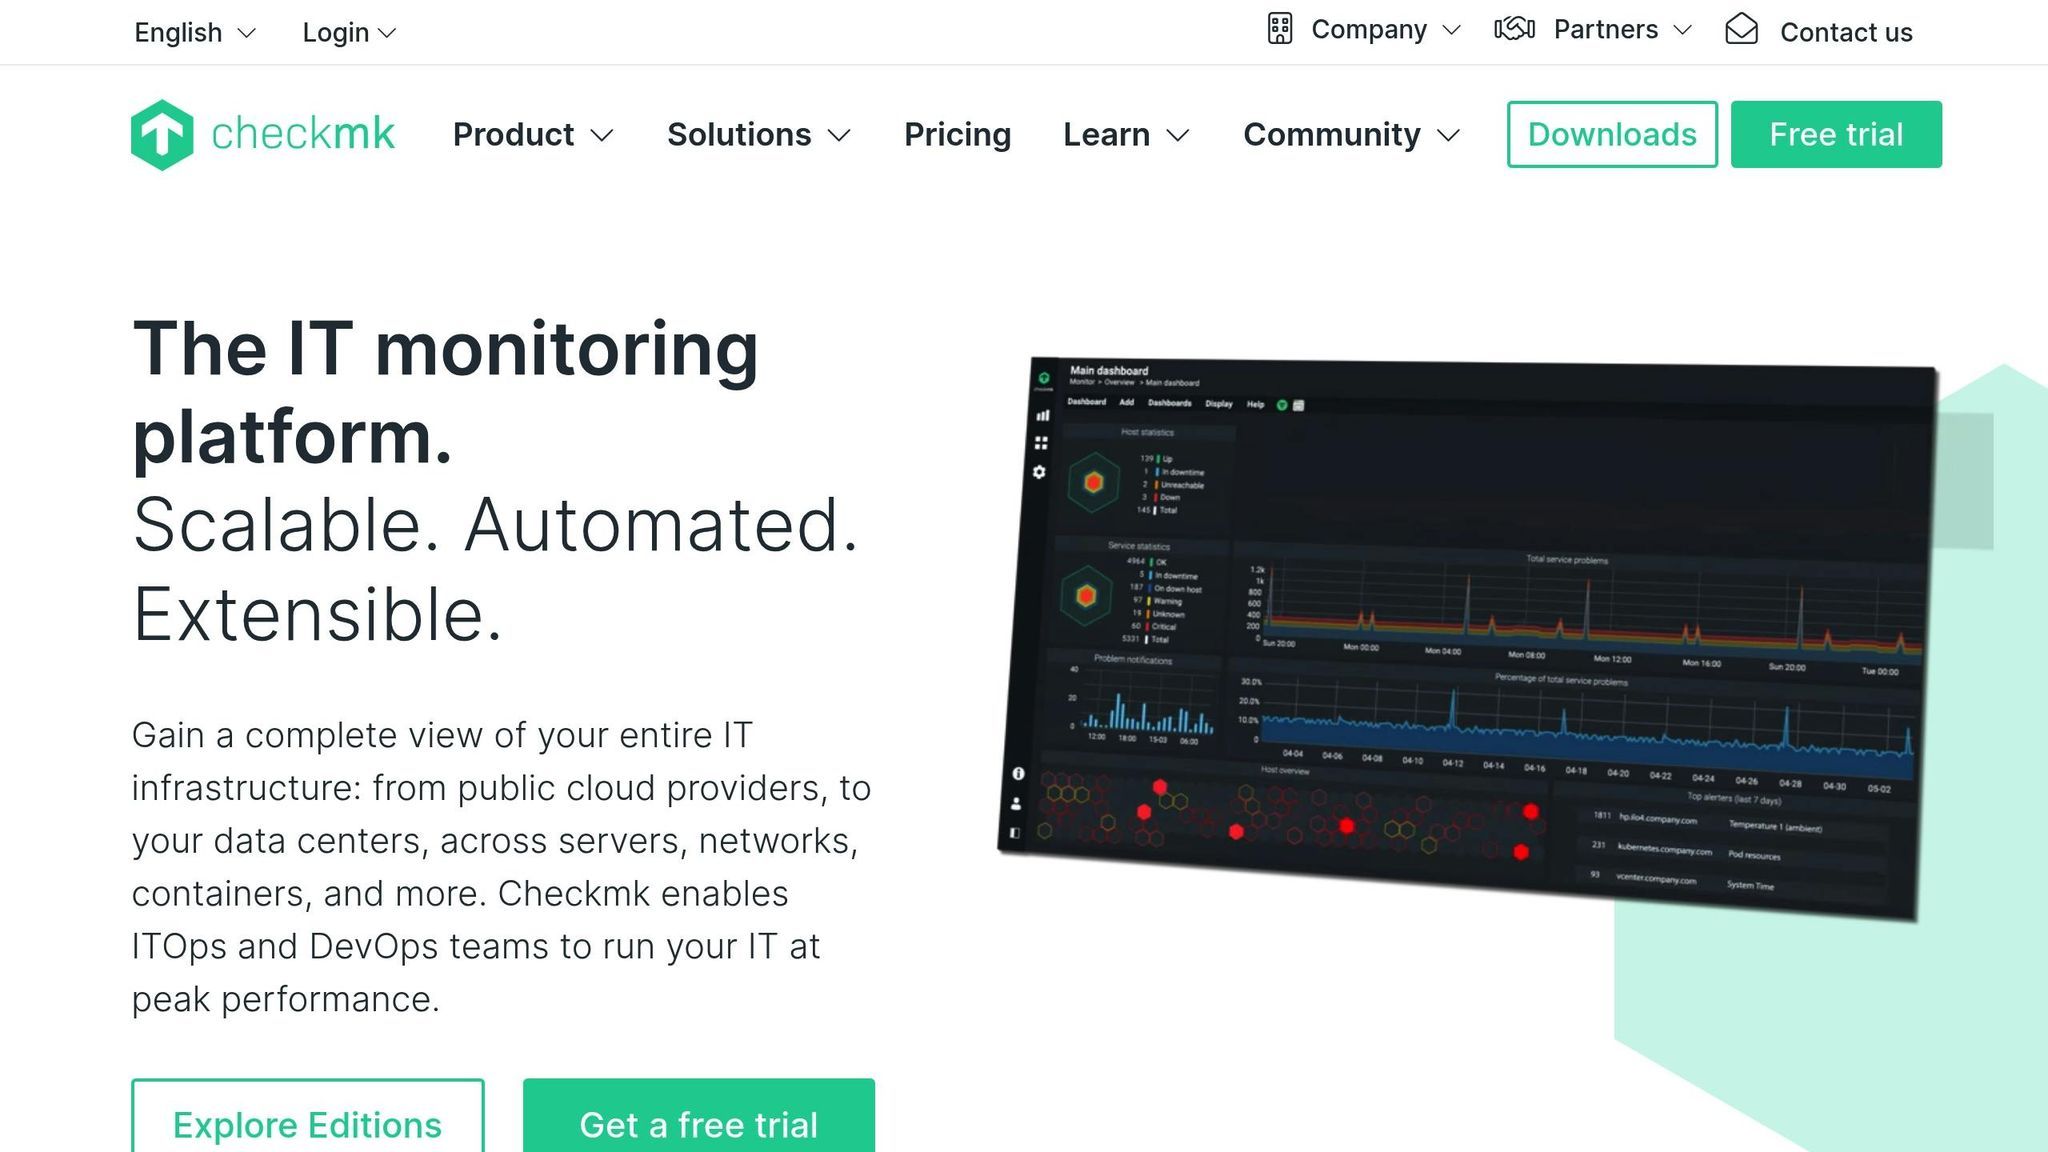
Checkmk — це потужна платформа моніторингу, призначена для управління виділеними серверами та середовищами VPS. Однією з її видатних особливостей є здатність автоматично виявляти та моніторити мережеві пристрої, сервери та служби, щойно вони підключаються до мережі, що позбавляє вас від необхідності ручного налаштування.
Сфера моніторингу
Checkmk охоплює широкий спектр моніторингу, відстежуючи інфраструктуру, мережі, додатки, контейнери та хмарні сервіси з єдиної платформи. Завдяки великому каталогу плагінів для моніторингу система забезпечує глибоку перевірку хостів та сервісів, дозволяючи відстежувати стан апаратного забезпечення, баз даних, систем зберігання, рівнів віртуалізації та користувацьких додатків. Він збирає детальні метрики з короткими інтервалами та корелює зміни стану між системами, щоб виявляти проблеми, що виникають. Його гібридна архітектура підтримує як моніторинг на основі агентів, так і без агентів, забезпечуючи гнучкість у центрі обробки даних, локальних установках та розподілених середовищах.
Можливості роботи в режимі реального часу
Checkmk надає інформаційні панелі, що оновлюються в режимі реального часу, відображаючи стан хостів, результати перевірок служб та показники продуктивності по мірі їх зміни. Система підтримує швидке опитування критично важливих хостів і може відображати графіки в режимі реального часу щодо навантаження, пам’яті, стану мережі та додатків. Панелі моніторингу можна налаштовувати, тому команди можуть виділяти пріоритетні системи та швидко виявляти нагальні проблеми. Ефективне ядро моніторингу забезпечує низькі накладні витрати навіть при тисячах перевірок на хвилину, що дозволяє великим системам підтримувати оперативну видимість у режимі реального часу.
Функції штучного інтелекту та автоматизації
Checkmk включає автоматичне налаштування порогових значень та інтелектуальну обробку правил, що зменшують «втому від сповіщень» завдяки адаптації до базової поведінки. Система може автоматично виявляти хости та сервіси й застосовувати заздалегідь визначені правила моніторингу без ручного налаштування. Функції прогнозування підтримують аналіз тенденцій та планування потужностей, допомагаючи командам завчасно виявляти ризики перевантаження. У складних середовищах система автоматизації на основі правил оптимізує оновлення конфігурації, активацію перевірок та логіку сповіщень. Більш глибокі функції штучного інтелекту зазвичай вимагають інтеграції із зовнішніми аналітичними інструментами, оскільки Checkmk зосереджується на детермінованому моніторингу, а не на повній автоматизації інцидентів.
Простота розгортання
Checkmk простий у розгортанні завдяки швидкому процесу інсталяції та чітким інструкціям з налаштування. Версія «raw» використовує компоненти з відкритим кодом, тоді як версія «enterprise» включає вдосконалений інтерфейс користувача та покращену продуктивність. Агенти можна встановити за допомогою невеликого скрипта, а функція автоматичного виявлення миттєво розпізнає нові служби. Система добре інтегрується з віртуалізованими та контейнеризованими середовищами і легко масштабується через розподілені моніторингові вузли для великих або багаторегіональних розгортань. Оскільки вона пропонує потужні стандартні налаштування «з коробки», команди можуть швидко запустити повноцінну систему моніторингу без значного налаштування.
Ціни
Checkmk пропонує безкоштовну базову версію, яка включає основні функції моніторингу, інформаційні панелі та оповіщення, що робить її придатною для невеликих команд або лабораторних середовищ. Версія «Enterprise» додає розширені функції, такі як покращена продуктивність, розширена автоматизація, прогнозна аналітика та довгострокова звітність. Ціноутворення для корпоративної версії зазвичай базується на кількості хостів, що моніторяться, починаючи з доступного початкового рівня та масштабуючись для більших інфраструктур. Це забезпечує передбачуваність загальних витрат та робить рішення привабливим для організацій, які потребують потужної системи моніторингу без високих абонентських платежів у стилі SaaS.
5. Datadog
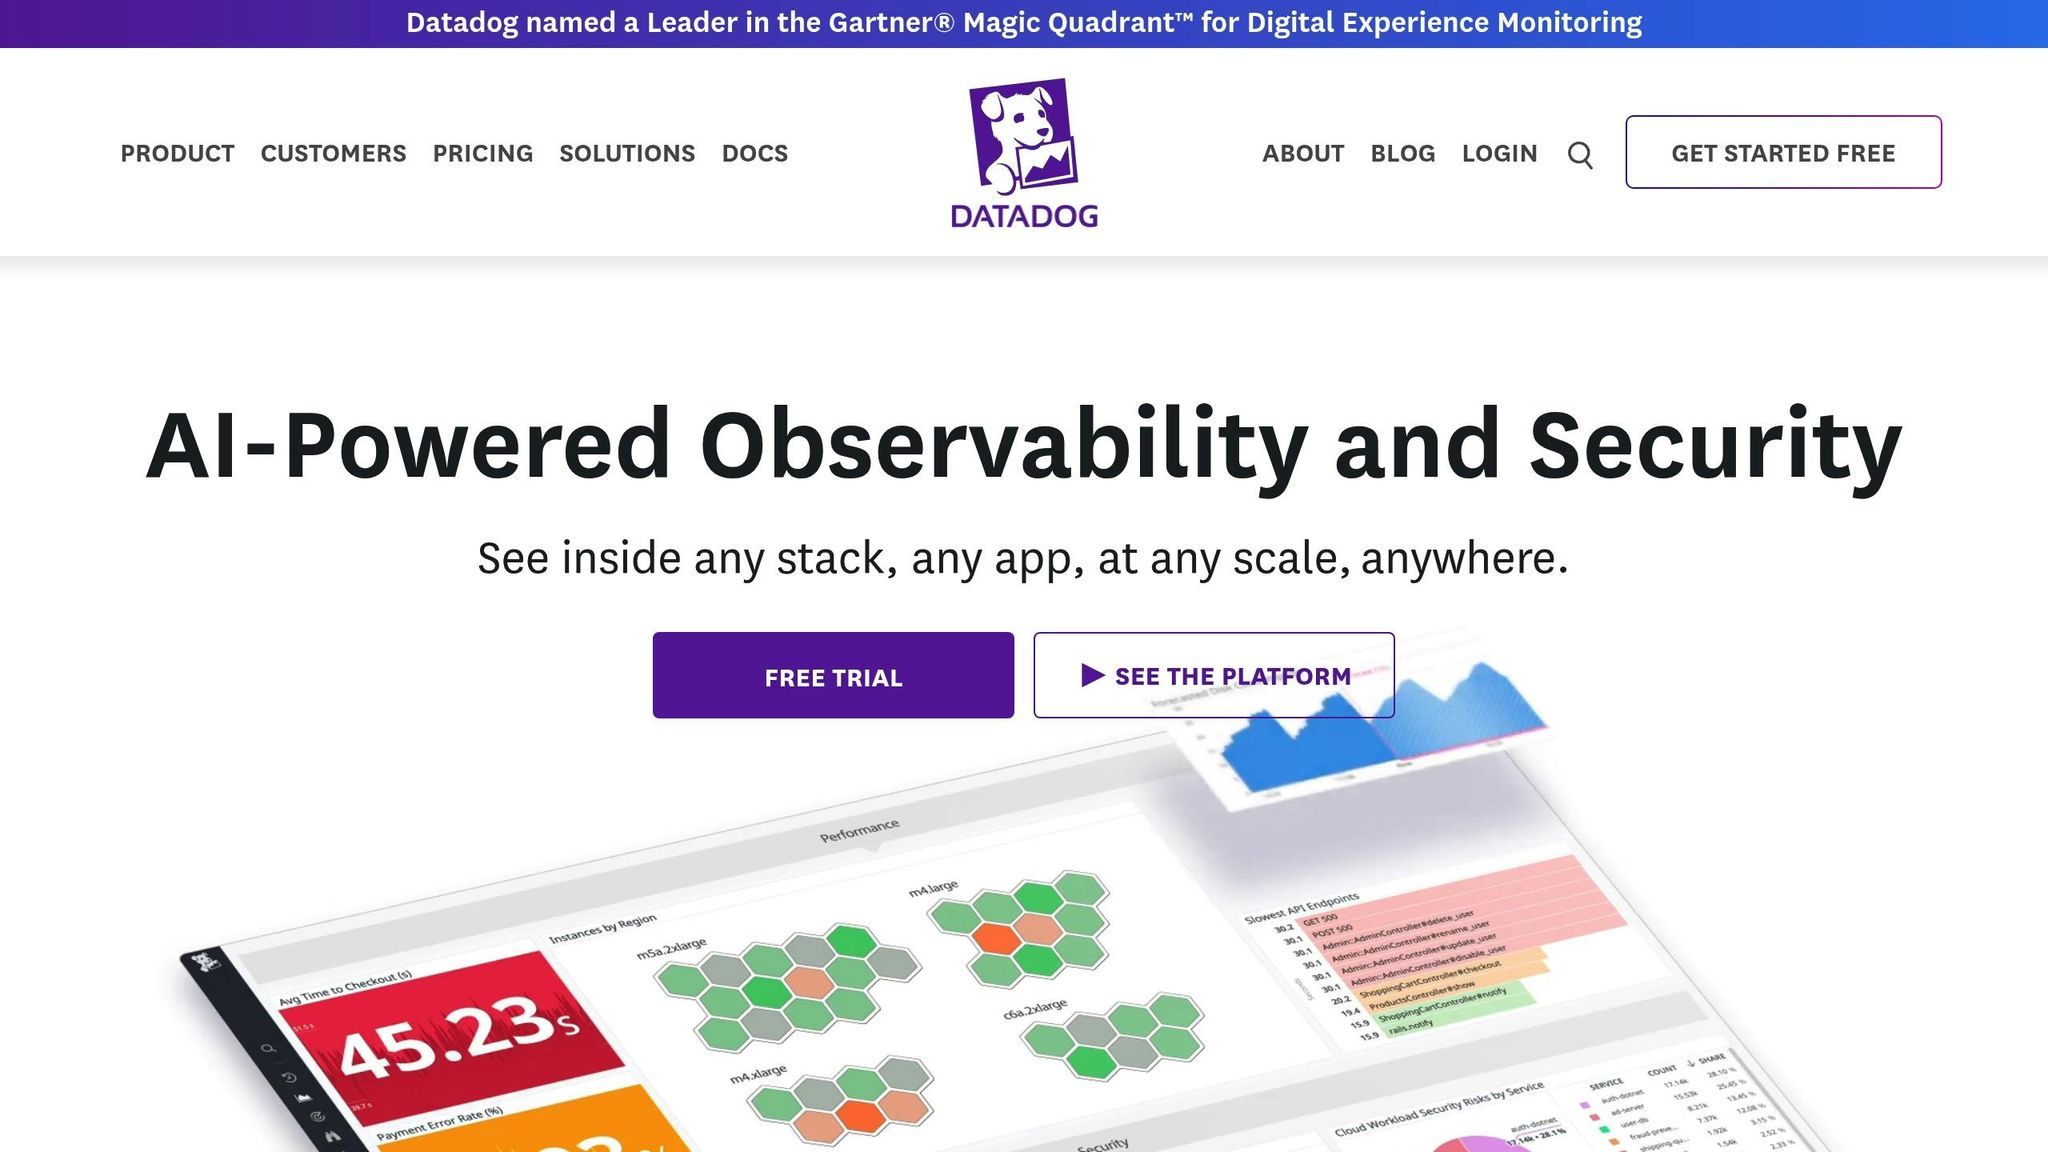
Datadog виводить моніторинг серверів та VPS на новий рівень, детально аналізуючи продуктивність на рівні коду. Завдяки розподіленому трасуванню на основі штучного інтелекту ця платформа допомагає точно виявляти вузькі місця в продуктивності та помічати аномалії в міру їх виникнення. Поєднуючи журнали додатків із системними метриками, Datadog спрощує виявлення першопричин проблем та їхнє швидке усунення, забезпечуючи безперебійну роботу вашої інфраструктури.
Сфера моніторингу
Datadog об’єднує метрики інфраструктури, журнали, трасування та сигнали безпеки в єдину платформу спостереження. Він може збирати телеметричні дані з хостів, контейнерів, безсерверних функцій, керованих хмарних сервісів та власних додатків. Його інтеграції охоплюють сотні технологій, тому ви можете відстежувати поведінку баз даних, продуктивність API, кластери Kubernetes та хмарні робочі навантаження з єдиного інтерфейсу. Дані збираються з високою частотою та корелюються між показниками, журналами та трасами для виявлення закономірностей продуктивності та вузьких місць. Такий широкий обсяг даних допомагає командам зрозуміти, як кожна частина їхнього стеку поводиться під реальним навантаженням.
Можливості роботи в режимі реального часу
Datadog надає інформаційні панелі, що оновлюються в режимі реального часу, відображаючи використання процесора, затримку запитів, стан контейнерів, пропускну здатність мережі та інші показники по мірі їх зміни. Ви можете налаштовувати інформаційні панелі, щоб виділяти важливі сигнали для швидкої діагностики. Система також підтримує оповіщення в режимі реального часу, завдяки чому такі проблеми, як сплески помилок або переповнення пам’яті, можуть викликати сповіщення одразу після їх виникнення. Навіть при великих обсягах даних агент та серверна частина SaaS розроблені так, щоб мінімізувати накладні витрати, забезпечуючи при цьому миттєву видимість у розподілених системах.
Функції штучного інтелекту та автоматизації
Datadog включає інструменти на основі штучного інтелекту, які аналізують історичні базові показники для виявлення аномалій та зменшення шуму від помилкових спрацьовувань. Набір інструментів Bits AI додає автоматизовану сортування, кореляцію між сигналами та підсумки інцидентів для прискорення розслідувань. Він може пропонувати ймовірні першопричини, рекомендувати кроки з усунення проблем на рівні коду або конфігурації та генерувати документацію після інцидентів. Ви також можете створювати робочі процеси, використовуючи природну мову, перетворюючи рутинні операційні завдання на автоматизовані послідовності без написання скриптів. Це допомагає командам оптимізувати процеси реагування, зберігаючи при цьому контроль над шляхами ескалації.
Простота розгортання
Datadog легко розгортати завдяки легкому агенту та хмарній архітектурі. Агент можна встановити за допомогою одного скрипта, використовувати образи Docker або розгорнути через Kubernetes за допомогою Helm. Його інтеграції автоматично виявляють сервіси та починають збирати телеметрію з мінімальними налаштуваннями. Оскільки все працює на хостинговій платформі Datadog, не потрібно підтримувати власний бекенд. Рішення легко інтегрується як у гібридні, так і в мультихмарні середовища, а також масштабується разом із інфраструктурою, що швидко змінюється, що робить його придатним для команд, які прагнуть повної видимості без необхідності керувати власним стеком моніторингу.
Ціни
Datadog працює за модульною ціновою моделлю: базові тарифи оплачуються за кожен моніторований хост, а додаткові функції — за фактичним використанням. Вартість тарифного плану «Pro» починається приблизно з 15 доларів за хост на місяць при щорічній оплаті, тоді як плани «Enterprise» коштують дорожче та включають розширені функції управління й штучного інтелекту. За журнали, траси, синтетичні тести, власні метрики та подовжений термін зберігання стягується додаткова плата. Це дозволяє командам використовувати лише ті компоненти, які їм потрібні, хоча витрати можуть швидко зростати в середовищах із великою кількістю хостів або інтенсивним надходженням журналів. Це залишається гнучким варіантом для організацій, які прагнуть всебічної спостережуваності, що підтримується зрілою SaaS-платформою.
Переваги та недоліки
Ознайомившись із функціоналом кожного інструменту, давайте розберемо їхні сильні сторони та обмеження, щоб допомогти вам вирішити, який із них найкраще відповідає вашим потребам. Правильний вибір залежатиме від таких факторів, як функціональність, зручність використання та бюджет.
Prometheus забезпечує видатну продуктивність завдяки ефективному збиранню даних часових рядів та потужній мові запитів (PromQL), спеціально розробленій для хмарних середовищ. Однак у ньому відсутні вбудовані інструменти візуалізації та можливості довгострокового зберігання даних, що вимагає використання зовнішніх рішень для цих функцій.
Grafana вирізняється гнучкою та просунутою візуалізацією даних, безперешкодно інтегруючись із різними джерелами даних, зокрема з Prometheus, для створення візуально привабливих інформаційних панелей. Її головним обмеженням є відсутність вбудованого збору даних, що змушує покладатися на зовнішні інструменти для їхнього отримання.
Zabbix — це масштабоване та комплексне рішення для моніторингу. Будучи програмним забезпеченням з відкритим кодом, воно усуває витрати на ліцензування, але часто вимагає більш складної настройки та постійного обслуговування, що може бути ресурсоємним.
Netdata вирізняється компактною архітектурою та моніторингом продуктивності в режимі реального часу, а також швидким процесом налаштування — часто він завершується за лічені хвилини. Це робить її чудовим вибором для малих та середніх середовищ. Однак вона має обмежені можливості для довгострокового аналізу історичних даних і пропонує більш базові функції оповіщення порівняно з платформами корпоративного рівня.
Checkmk забезпечує масштабований моніторинг із показниками в режимі реального часу та налаштовуваними сповіщеннями, що робить його ідеальним для великомасштабних серверних розгортань. Однак його розширені функції вимагають більш тривалого освоєння та збільшують складність налаштування у міру зростання масштабів розгортання.
Datadog пропонує всеосяжний досвід моніторингу з аналітикою на основі штучного інтелекту, що охоплює інфраструктуру, додатки та управління журналами. Хоча його функціонал є широким, вартість передплати може швидко зростати (наприклад, 15 доларів США за хост на місяць для інфраструктури, з додатковими платежами за APM та управління журналами). Крім того, освоєння його розширених функцій вимагає значних витрат часу та зусиль на навчання.
У таблиці нижче наведено короткий огляд основних переваг, недоліків та структури витрат кожного інструменту для швидкого порівняння:
| Інструмент | Основні переваги | Основні недоліки | Структура витрат |
|---|---|---|---|
| Prometheus | Ефективний збір даних часових рядів та потужна мова запитів | Відсутність вбудованих засобів візуалізації та зберігання даних | Відкрите програмне забезпечення (лише операційні витрати) |
| Grafana | Гнучка, розширена візуалізація з підтримкою декількох джерел | Відсутність вбудованого збору даних | Відкрите програмне забезпечення (лише експлуатаційні витрати) |
| Zabbix | Масштабований, комплексний моніторинг для традиційних ІТ-систем | Складне налаштування та обслуговування | Безкоштовно (з витратами на хостинг та обслуговування) |
| Netdata | Легкий моніторинг у режимі реального часу з швидким налаштуванням | Обмежений аналіз історичних даних та система сповіщень | Від 4,50 доларів США за вузол на місяць |
| Checkmk | Масштабований моніторинг з показниками в режимі реального часу та налаштованими сповіщеннями | Складне освоєння розширених функцій | Приблизно 80 доларів США на місяць для ~100 хостів |
| Datadog | Широкомасштабний моніторинг у хмарі з аналітикою на основі штучного інтелекту | Вищі витрати та складне освоєння | Від 15 доларів США за хост на місяць (плюс додаткові збори) |
Ваше рішення в кінцевому рахунку залежить від рівня кваліфікації вашої команди та бюджету. Інструменти з відкритим кодом, такі як Prometheus та Zabbix, можуть бути дуже ефективними, якщо ваша команда володіє технічними знаннями для їхнього управління. З іншого боку, комерційні варіанти, такі як Checkmk, Netdata та Datadog, пропонують готові до використання рішення, що зменшують внутрішні витрати, але часто пов’язані з вищими витратами.
Висновок
Вибір правильного інструменту моніторингу для вашого виділеного сервера або VPS у 2025 році зводиться до розуміння вашого конкретного середовища, технічних знань та бюджетних обмежень.
Для невеликих систем або тих, хто потребує швидких результатів, Netdata є надійним вибором. Завдяки аналітиці в режимі реального часу та простоті налаштування цей інструмент ідеально підходить для негайного моніторингу без необхідності складного конфігурування.
Більші та складніші середовища часто вимагають масштабованих рішень. Якщо ви працюєте з хмарними або контейнеризованими системами, Prometheus та Grafana є чудовими варіантами. Вони поєднують потужний збір даних часових рядів із налаштовуваними візуалізаціями, хоча для їх ефективного управління потрібен вищий рівень технічних знань.
Для підприємств варто розглянути Checkmk та Datadog. Checkmk надає широкі можливості моніторингу та може бути економічно вигідним для масштабних розгортань. З іншого боку, Datadog вирізняється аналітикою на основі штучного інтелекту та широкими можливостями інтеграції, хоча масштабування може вимагати більш ретельного планування ресурсів.
У традиційних ІТ-середовищах із різноманітною інфраструктурою Zabbix залишається сильним конкурентом. Хоча його налаштування може бути складнішим, його надійні функції та відсутність ліцензійних платежів роблять його привабливим для організацій, що мають власних системних адміністраторів.
Зрештою, найкращим рішенням для моніторингу є те, яке відповідає здатності вашої команди ефективно ним керувати. Інструмент, переповнений функціями, може швидко стати тягарем, якщо він перевантажує ваші операційні можливості. Початок роботи з легкого варіанту, такого як Netdata, дозволяє встановити базовий рівень моніторингу, залишаючи гнучкість для впровадження більш комплексних платформ у міру зростання вашої інфраструктури та накопичення досвіду.
Мета полягає в тому, щоб зосередитися на послідовному моніторингу, результати якого можна використовувати на практиці, а не гнатися за кожною передовою функцією. Застосовуючи поступовий, індивідуально адаптований підхід, ви зможете забезпечити розвиток вашої стратегії моніторингу відповідно до вимог вашого хостингового середовища.
Поширені запитання
Як штучний інтелект та автоматизація покращать моніторинг серверів у 2025 році, і які інструменти надають ці можливості?
У 2025 році штучний інтелект та автоматизація трансформують моніторинг серверів, роблячи управління виділеними серверами та VPS більш інтелектуальним, ефективним та оперативним. Завдяки системам на базі штучного інтелекту можна виявляти нетипові закономірності, передбачати потенційні збої та автоматично вирішувати рутинні проблеми. Такий підхід скорочує час простою та підвищує загальну надійність серверів.
Такі інструменти, як Dynatrace, Logz.io та Datadog, є лідерами у впровадженні штучного інтелекту та автоматизації. Вони надають аналітичні дані в режимі реального часу, виявляють аномалії та пропонують прогнозну аналітику, спеціально розроблену для високопродуктивних хостингових середовищ. Ці можливості забезпечують безперебійну та безпечну роботу серверів навіть під час інтенсивних навантажень.
Що слід врахувати, обираючи між інструментами моніторингу з відкритим кодом та платними інструментами для мого сервера або VPS?
Оцінюючи варіанти між інструментами моніторингу з відкритим кодом та платними, важливо врахувати, що найкраще відповідає вашим потребам і ресурсам. Інструменти з відкритим кодом зазвичай безкоштовні та пропонують високий рівень налаштування, що ідеально підходить, якщо ви маєте технічні знання та потребуєте гнучкого рішення. Натомість платні інструменти часто мають інтуїтивно зрозумілі інтерфейси, розширені функції та спеціалізовану підтримку, що допомагає заощадити час і спростити процес.
Щоб зробити правильний вибір, зверніть увагу на кілька ключових факторів: ваш бюджет, рівень підтримки, який може знадобитися, простоту налаштування інструменту та його здатність масштабуватися відповідно до вимог вашого сервера або VPS. Приділивши час оцінці цих елементів, ви зможете обрати варіант, який відповідає вашим цілям щодо моніторингу та продуктивності.
Як найкраще забезпечити масштабування вашого рішення для моніторингу серверів у міру розширення інфраструктури?
Щоб ваше рішення для моніторингу йшло в ногу з розширенням вашої інфраструктури, важливо зосередитися на інструментах і стратегіях, що наголошують на масштабованості та автоматизації. Обирайте платформи, здатні працювати з розподіленими архітектурами, що забезпечують безперебійний моніторинг декількох серверів або віртуальних машин у міру розширення вашої системи. Особливо корисними є такі функції, як аналітика на основі штучного інтелекту та інформаційні панелі в режимі реального часу — вони здатні обробляти великі обсяги даних і при цьому надавати змістовну інформацію без уповільнення роботи.
Також доцільно обирати інструменти, що передбачають налаштування сповіщень та легко інтегруються з вашими поточними робочими процесами. Таким чином ви зможете швидко виявляти та усувати проблеми в міру розвитку вашої інфраструктури. Привчіть себе регулярно оцінювати та налаштовувати систему моніторингу, щоб забезпечити її ефективність і надійність протягом усього процесу зростання вашого бізнесу.

Як розмістити моделі штучного інтелекту Ollama на виділених серверах
Дізнайтеся, як розміщувати моделі Ollama AI на виділених серверах для забезпечення безпеки даних, масштабованості та підвищення продуктивності.
5 хв читання - 8 вересня 2025 р.

Маєте запитання або потребуєте індивідуального рішення?

Гнучкі варіанти

Глобальне охоплення

Миттєве розгортання
Гнучкі варіанти
Глобальне охоплення
Миттєве розгортання