
Monitorizarea serverului dedicat sau a VPS-ului: care sunt opțiunile în 2025?
12 min citire - 28 noiembrie 2025
Descoperiți cele mai bune instrumente de monitorizare pentru servere dedicate și VPS în 2025, cu accent pe inteligența artificială, automatizare și analize în timp real.
Monitorizarea serverului dvs. dedicat sau a VPS-ului: care sunt opțiunile în 2025?
Monitorizarea serverului dedicat sau a VPS-ului în 2025 înseamnă să anticipați potențialele probleme cu ajutorul unor instrumente mai inteligente și mai eficiente. Soluțiile moderne utilizează acum inteligența artificială, analiza în timp real și automatizarea pentru a prevedea defecțiunile, a urmări performanța și a reduce timpul de nefuncționare. Iată o prezentare succintă a principalelor opțiuni:
- Prometheus + Grafana: un duo open-source pentru colectarea datelor din serii temporale și tablouri de bord personalizabile. Excelent pentru configurații native în cloud.
- Zabbix: Monitorizare de nivel enterprise cu funcții puternice de alertare și cartografiere a dependențelor pentru infrastructuri complexe.
- Netdata: monitorizare ușoară a performanței în timp real, cu configurare rapidă.
- Checkmk: monitorizare scalabilă cu detectare automată a dispozitivelor și informații detaliate.
- Datadog: monitorizare axată pe cloud, cu funcții bazate pe inteligență artificială și urmărire aprofundată a aplicațiilor.
Fiecare instrument răspunde unor nevoi diferite, de la configurații mici până la întreprinderi mari. Mai jos găsiți o comparație rapidă care să vă ajute să luați o decizie:
Comparație rapidă
| Instrument | Ideal pentru | Caracteristici cheie | Cost |
|---|---|---|---|
| Prometheus + Grafana | Mediile native în cloud | Date din serii temporale, tablouri de bord personalizate | Gratuit (auto-găzduit) |
| Zabbix | Configurații IT complexe | Cartografierea dependențelor, bazat pe agenți/fără agenți | Gratuit (găzduit de utilizator) |
| Netdata | Monitorizarea performanței în timp real | Indicatori simpli și instantanei | Gratuit/4,50 USD pe nod |
| Checkmk | Implementări la scară largă | Descoperire automată, domeniu larg de monitorizare | ~80 $/lună (100 de gazde) |
| Datadog | Monitorizare la nivel de cloud și de aplicație | Informații bazate pe IA, urmărirea aplicațiilor, integrări | 15 USD+/host/lună |
Alegeți în funcție de dimensiunea infrastructurii, de expertiza tehnică și de buget. Instrumentele open-source, precum Prometheus și Zabbix, sunt rentabile, dar necesită mai multă configurare, în timp ce opțiunile cu plată, precum Datadog, oferă ușurință în utilizare și funcții avansate. Începeți cu pași mici și extindeți-vă pe măsură ce nevoile dvs. cresc.
Ghid complet de monitorizare a serverelor | Curs de monitorizare nr. 2
1. Prometheus și Grafana
Prometheus și Grafana formează împreună una dintre cele mai eficiente soluții open-source de monitorizare disponibile în prezent. Prometheus se concentrează pe colectarea și stocarea datelor, în timp ce Grafana transformă aceste date în tablouri de bord intuitive din punct de vedere vizual. Această combinație oferă o modalitate flexibilă și accesibilă din punct de vedere financiar de a monitoriza serverele dedicate și mediile VPS.
Domeniul de monitorizare
Prometheus este binecunoscut pentru capacitatea sa de a colecta date din serii temporale de pe diverse sisteme. Acesta urmărește indicatori-cheie precum utilizarea procesorului, consumul de memorie și operațiunile de I/O pe disc, gestionând în același timp și statistici mai specializate, specifice aplicațiilor. Folosind un model de tip „pull”, acesta preia indicatorii de la punctele finale configurate la intervale regulate, fiind astfel potrivit pentru monitorizarea atât a configurațiilor containerizate, cât și a serverelor tradiționale de tip „bare-metal”.
Pentru a-și extinde capacitățile, Prometheus acceptă numeroși exportatori oficiali, ceea ce îi permite să colecteze date de la aproape orice serviciu sau aplicație care rulează în infrastructura dvs.
Grafana completează Prometheus prin prezentarea acestor date prin intermediul unor tablouri de bord personalizabile. Aceste tablouri de bord pot include grafice în timp real, hărți de intensitate și stări de alertă. În plus, Grafana integrează date din mai multe surse, oferindu-vă o imagine unificată și cuprinzătoare asupra performanței sistemului dumneavoastră.
Capacități în timp real
Prometheus colectează metrici la intervale care pot fi setate la o frecvență de câteva secunde, deși valoarea implicită este de obicei între 15 și 30 de secunde. Pe de altă parte, tablourile de bord Grafana se actualizează automat pe măsură ce sosesc date noi. Puteți ajusta intervalele de reîmprospătare în funcție de nevoile dvs., fie că este vorba de câteva secunde sau de perioade mai lungi. Această reacție rapidă este extrem de valoroasă pentru monitorizarea creșterilor bruște de trafic sau a blocajelor de resurse, asigurându-vă că sunteți mereu la curent cu performanța sistemului și gata să acționați în cazul apariției oricăror probleme.
Funcții de IA/automatizare
Deși Prometheus și Grafana nu sunt bazate în principal pe IA, ele includ funcții de automatizare pentru a îmbunătăți monitorizarea. Prometheus include Alertmanager, care trimite notificări pe baza unor condiții predefinite. Acest sistem acceptă reguli complexe de alertă, valorificând atât metricile în timp real, cât și datele istorice pentru precizie.
Grafana a introdus instrumente de detectare a anomaliilor care utilizează învățarea automată pentru a identifica tipare neobișnuite în metricile dvs. Aceste instrumente ajută la reducerea alarmelor false prin învățarea comportamentului tipic al sistemului dvs. De asemenea, ele pot sprijini automatizarea prin declanșarea unor acțiuni precum scalarea resurselor sau alertarea sistemelor de orchestrare atunci când pragurile sunt depășite.
Ușurința implementării
Configurarea Prometheus și Grafana este simplă. Ambele instrumente pot rula în containere Docker, asigurând instalări consistente pe diferite sisteme de operare. Cu instrumente precum docker-compose, puteți implementa un stack complet de monitorizare în doar câteva minute.
Pentru cei care utilizează servere dedicate, ambele aplicații pot fi instalate direct folosind managerii de pachete nativi pe majoritatea distribuțiilor Linux. Chiar și configurațiile avansate sunt relativ ușor de configurat și de depanat, ceea ce face ca acest duo să fie accesibil utilizatorilor cu diferite niveluri de expertiză.
Prețuri
Prometheus și Grafana sunt complet gratuite și open source, fără taxe de licență, limite de utilizatori sau restricții privind păstrarea datelor. Acest lucru le face o soluție rentabilă pentru monitorizarea infrastructurii dumneavoastră.
Pentru cei care preferă o opțiune gestionată, Grafana oferă un serviciu bazat pe cloud. Nivelul gratuit oferă funcționalități de bază, în timp ce planurile plătite scalabile includ funcții și capacitate suplimentare. Deși mulți utilizatori consideră că găzduirea proprie le satisface nevoile, serviciul gestionat este o alternativă convenabilă, în special pentru cei care doresc să simplifice sarcinile de întreținere și asistență.
2. Zabbix
Zabbix este o platformă puternică de monitorizare, perfecționată de-a lungul a două decenii pentru a răspunde nevoilor mediilor de nivel enterprise. Oferă o interfață unificată pentru gestionarea serverelor dedicate și a VPS-urilor, ceea ce o face o alegere fiabilă pentru configurații complexe.
Domeniul de monitorizare
Zabbix depășește indicatorii de bază ai sistemului, oferind vizibilitate asupra dispozitivelor de rețea, aplicațiilor, bazelor de date, serviciilor web și platformelor de virtualizare – totul dintr-un tablou de bord centralizat. Indiferent dacă preferați monitorizarea bazată pe agenți sau fără agenți, Zabbix poate urmări totul, de la utilizarea procesorului și a memoriei până la indicatorii personalizați ai aplicațiilor.
Platforma simplifică gestionarea în medii dinamice prin detectarea automată a dispozitivelor și serviciilor noi. Aceasta suportă monitorizarea dispozitivelor SNMP, executarea interogărilor de baze de date, verificarea timpilor de răspuns web și scanarea jurnalelor în căutarea erorilor.
O caracteristică remarcabilă este capacitatea sa de a mapa dependențele dintre componentele infrastructurii. Aceste hărți de dependențe oferă o imagine clară a modului în care interacționează serverele, aplicațiile și componentele de rețea, facilitând identificarea și rezolvarea problemelor.
Capacități în timp real
Zabbix colectează și prelucrează datele de monitorizare la intervale pe care le puteți configura, de obicei cuprinse între 30 de secunde și 5 minute, în funcție de importanța indicatorilor. Interfața sa web include tablouri de bord în timp real care se actualizează automat, oferindu-vă o imagine mereu actualizată a sistemelor dumneavoastră.
Puteți personaliza frecvența cu care sunt colectate diferite metrici. De exemplu, datele critice pot fi colectate mai frecvent, în timp ce metricile mai puțin esențiale sunt înregistrate mai rar. Această flexibilitate asigură utilizarea eficientă a resurselor de sistem și a spațiului de stocare.
Funcționalități predictive și automatizate
Folosind date istorice, Zabbix poate prognoza tendințele pentru a detecta anomaliile din timp. De asemenea, automatizează răspunsurile prin executarea de scripturi atunci când sunt atinse anumite praguri. De exemplu, platforma poate reporni un serviciu sau rula automat un script de întreținere atunci când apar condiții predefinite.
Sistemul său de alertare este conceput pentru a reduce suprasolicitarea cu notificări. Acesta grupează alertele conexe și gestionează dependențele, asigurându-se că numai notificările relevante sunt trimise prin canalele de comunicare alese de dumneavoastră.
Ușurința implementării
Deși Zabbix poate necesita un efort ceva mai mare în timpul configurării inițiale, acesta suportă diverse metode de implementare, inclusiv containere Docker, aparate virtuale și instalări native pe distribuții Linux populare și sisteme Windows.
Șabloanele predefinite pentru aplicații și servicii utilizate pe scară largă economisesc timp în timpul configurării. În plus, funcțiile de detectare automată și înregistrare automată ale Zabbix simplifică procesul de configurare a monitorizării pentru dispozitive și servicii noi. Puteți chiar automatiza implementarea agenților pe servere folosind instrumente de gestionare a configurației sau opțiunile încorporate ale Zabbix.
Prețuri
Zabbix este complet gratuit și open source, fără taxe de licență sau limite de utilizatori. Pentru cei care au nevoie de asistență suplimentară, sunt disponibile pachete de abonament comercial, prețurile depinzând de nivelul de asistență necesar.
Principalele costuri asociate cu Zabbix includ hardware-ul necesar pentru serverul și baza de date Zabbix, precum și timpul alocat configurării și întreținerii. Datorită funcționalităților sale extinse și lipsei taxelor de licență, Zabbix rămâne un concurent puternic în domeniul monitorizării pe măsură ce ne apropiem de anul 2025.
V-ați săturat de implementări lente sau de limitele de lățime de bandă? FDC Servers oferă putere dedicată instantanee, acoperire globală și planuri flexibile concepute pentru orice scară.
Actualizați acum3. Netdata
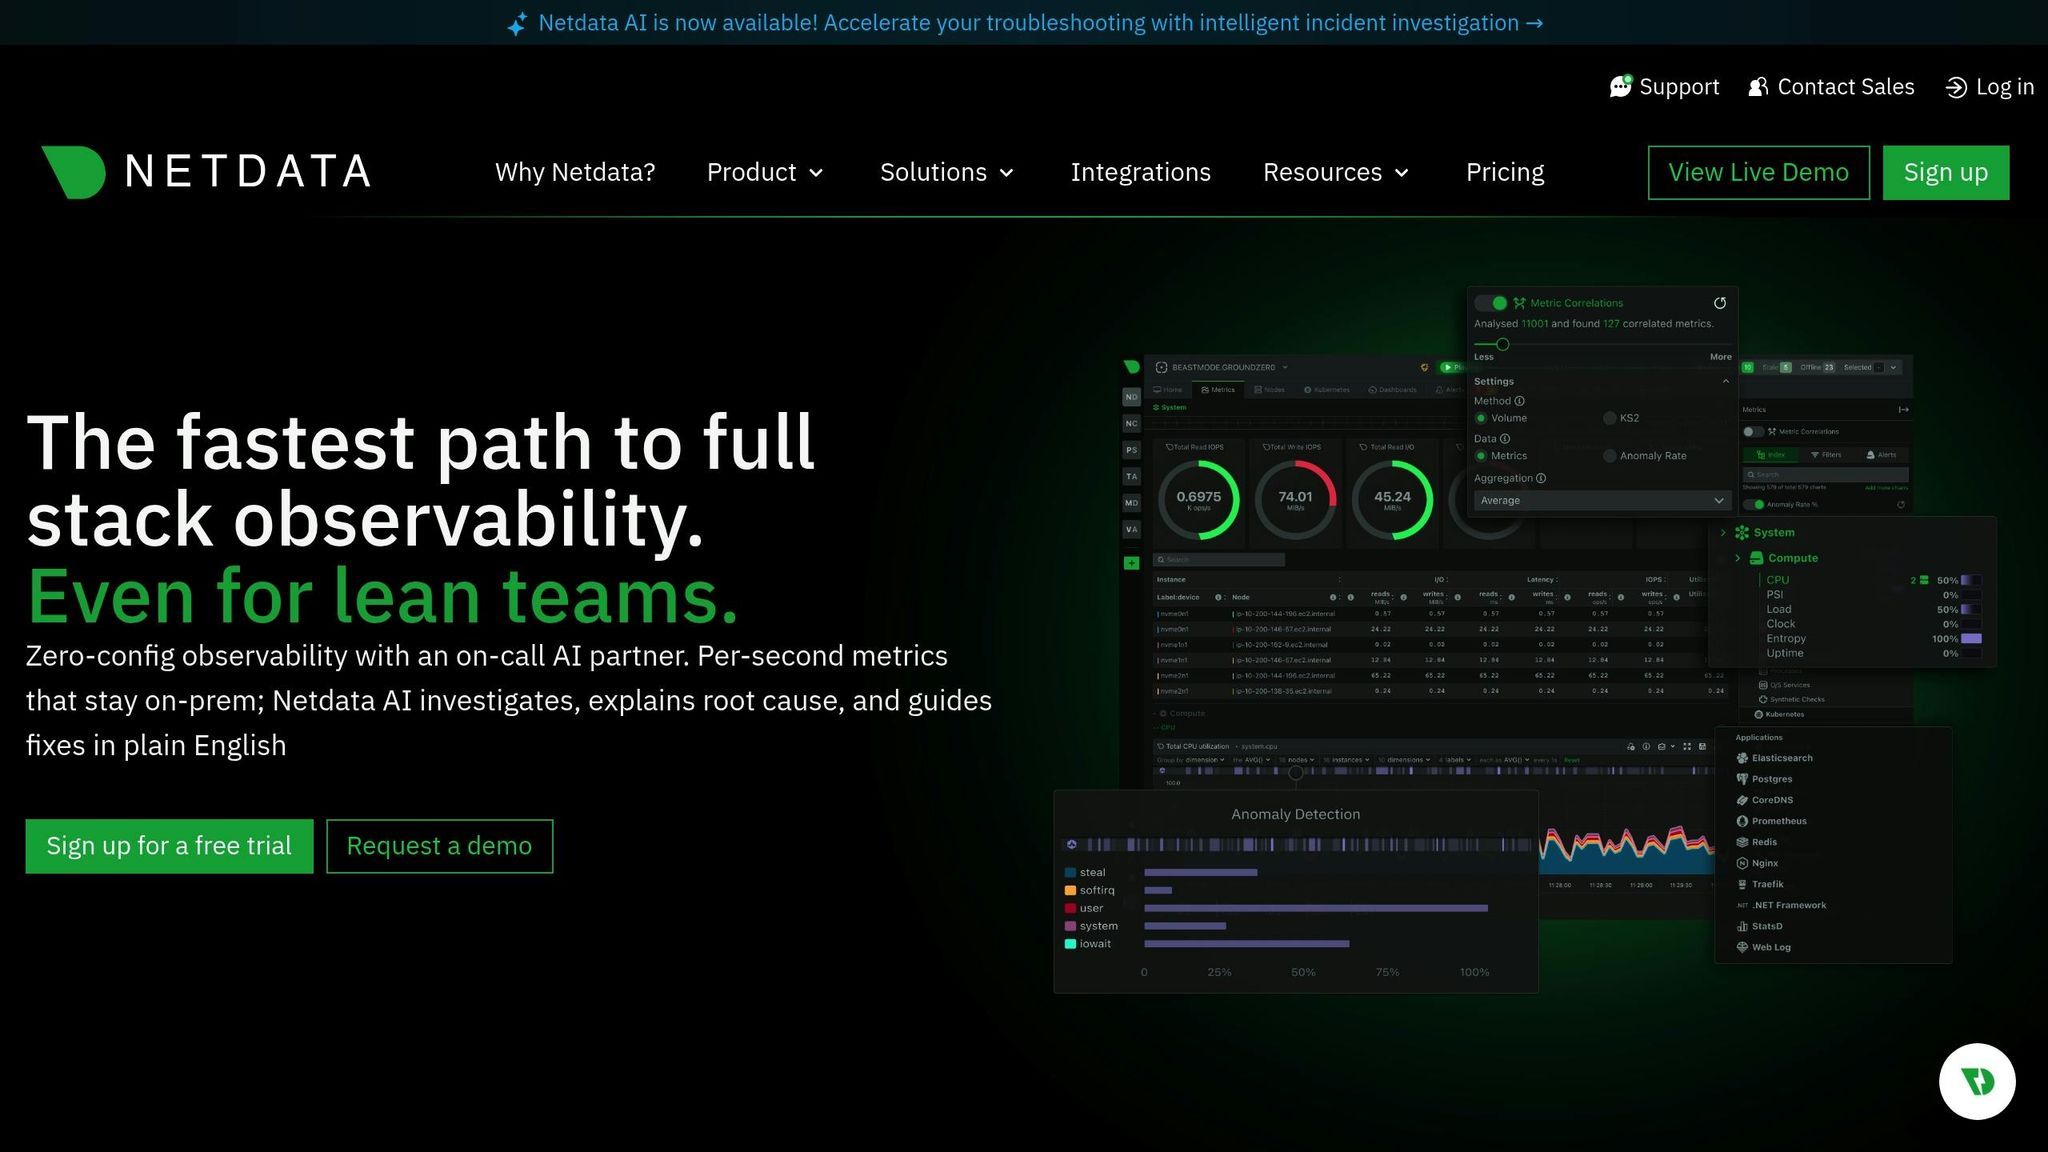
Netdata este un instrument ușor, conceput pentru monitorizarea performanței în timp real. Capacitatea sa de a oferi informații instantanee cu un impact minim asupra resurselor sistemului îl face o alegere ideală pentru organizațiile care au nevoie de vizibilitate imediată asupra infrastructurii lor.
Domeniul de monitorizare
Netdata monitorizează peste 800 de indicatori, acoperind totul, de la utilizarea procesorului și a memoriei până la operațiunile de intrare-ieșire pe disc și traficul de rețea. Funcționează fără probleme pe servere dedicate, VPS și oferă chiar și indicatori detaliați pentru containere. Prin colectarea datelor în fiecare secundă, detectează vârfurile de încărcare și anomaliile aproape instantaneu. Această colectare de date aproape în timp real completează analizele istorice mai ample oferite de alte instrumente. De asemenea, urmărește automat noile servicii, aplicații și containere pe măsură ce acestea devin active. Pentru cei care au nevoie de stocare pe termen lung sau de analize mai avansate, Netdata poate transmite indicatorii către platforme externe precum Prometheus sau OpenObserve.
Capacități în timp real
Netdata oferă tablouri de bord în timp real care se actualizează continuu, oferind o imagine în direct a stării de sănătate a sistemului dumneavoastră. Aceste tablouri de bord sunt personalizabile, permițându-vă să vă concentrați asupra metricilor care contează cel mai mult pentru depanarea rapidă. În ciuda informațiilor detaliate pe care le oferă, designul ușor al Netdata asigură funcționarea sa cu un consum minim de resurse.
Funcționalități de IA și automatizare
Netdata utilizează detectarea anomaliilor bazată pe IA pentru a învăța comportamentul normal al sistemului dvs. și semnalează abaterile ca potențiale probleme. De asemenea, include alerte preconfigurate care se adaptează la infrastructura dvs., reducând alarmele false prin luarea în considerare a tendințelor istorice și a contextului. Cu toate acestea, sistemul său de alertare mai puțin centralizat poate necesita integrarea cu instrumente externe pentru rutare mai complexă a alertelor sau fluxuri de lucru de escaladare.
Ușurința implementării
Netdata este ușor de configurat, cu opțiuni de instalare care variază de la scripturi simple la imagini Docker. Suportă atât mediile locale, cât și cele din cloud, integrându-se fără probleme cu stivele de monitorizare existente. Caracterul său open-source permite personalizarea fără a fi legat de un furnizor specific. Pentru configurațiile containerizate, imaginile Docker și diagramele Helm pentru Kubernetes simplifică implementarea, în timp ce funcția de detectare automată asigură monitorizarea imediată a noilor servicii și aplicații.
Prețuri
Netdata oferă un plan comunitar gratuit care include funcții esențiale precum monitorizarea în timp real, alerte de bază și un panou de control web ușor de utilizat – ideal pentru configurații mai mici. Pentru organizațiile mai mari sau cele care au nevoie de funcționalități avansate, cum ar fi păstrarea extinsă a datelor, alerte îmbunătățite și asistență prioritară, planurile cu plată încep de la 4,50 USD pe nod pe lună (facturate anual). Această combinație între un nivel gratuit robust și opțiuni cu plată accesibile face ca Netdata să fie accesibilă unei game largi de utilizatori. În continuare, vom analiza mai în detaliu abordarea Checkmk în ceea ce privește monitorizarea.
4. Checkmk
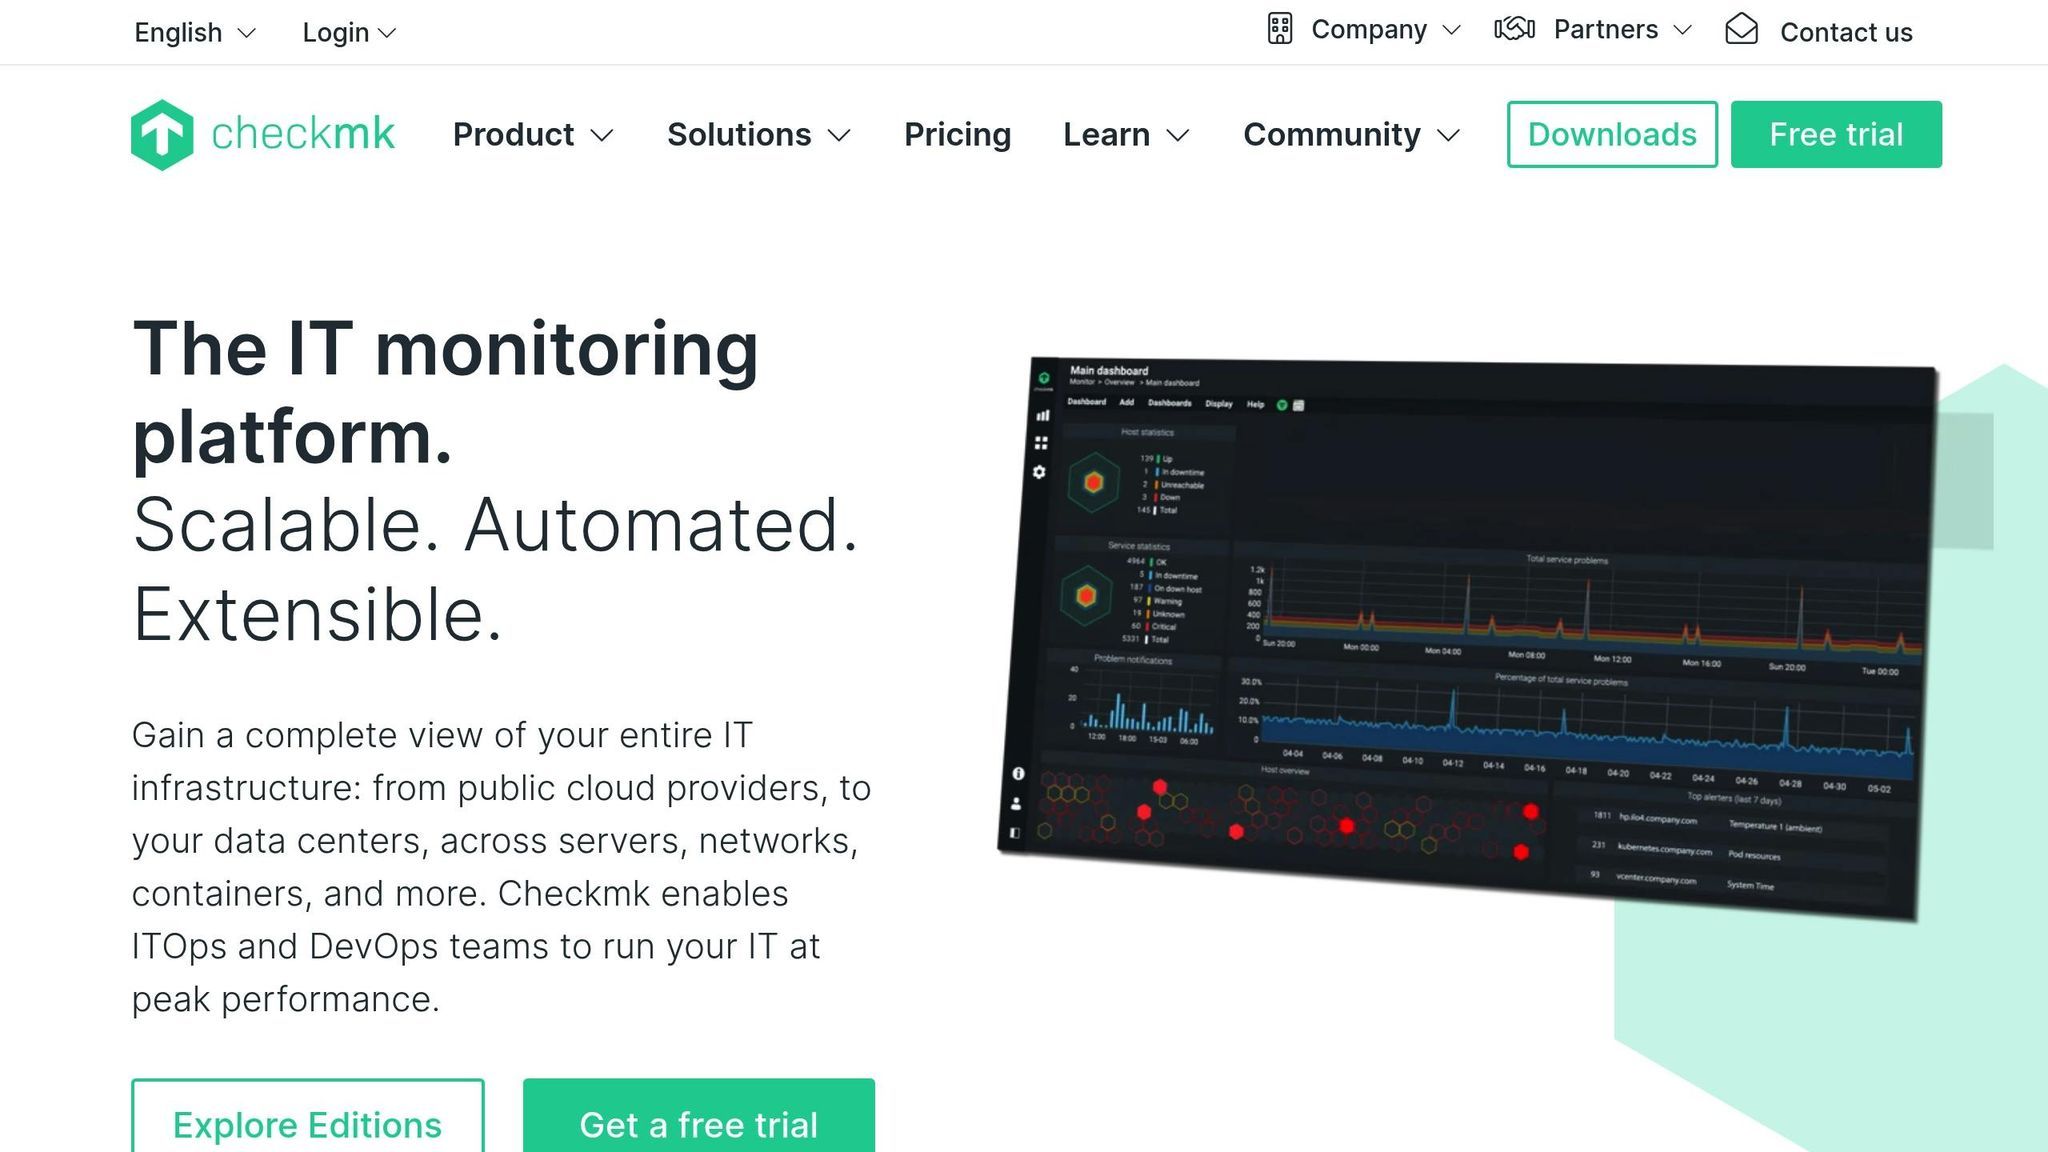
Checkmk este o platformă puternică de monitorizare concepută pentru gestionarea serverelor dedicate și a mediilor VPS. Una dintre caracteristicile sale remarcabile este capacitatea de a detecta și monitoriza automat dispozitivele de rețea, serverele și serviciile pe măsură ce acestea devin active, scutindu-vă de efortul configurării manuale.
Domeniul de monitorizare
Checkmk acoperă o arie largă de monitorizare, urmărind infrastructura, rețelele, aplicațiile, containerele și serviciile cloud dintr-o singură platformă. Oferă verificări aprofundate ale gazdelor și serviciilor prin intermediul catalogului său extins de pluginuri de monitorizare, permițându-vă să observați starea hardware-ului, bazele de date, sistemele de stocare, straturile de virtualizare și aplicațiile personalizate. Colectează metrici detaliate la intervale scurte și corelează schimbările de stare între sisteme pentru a evidenția problemele emergente. Designul său hibrid suportă atât monitorizarea bazată pe agenți, cât și cea fără agenți, oferind flexibilitate în centrele de date, în configurațiile locale și în mediile distribuite.
Capacități în timp real
Checkmk oferă tablouri de bord în timp real care se actualizează continuu, afișând starea gazdelor, verificările serviciilor și metricile de performanță pe măsură ce acestea se modifică. Suportă interogarea rapidă a gazdelor critice și poate afișa grafice în timp real pentru încărcare, memorie, rețea și starea aplicațiilor. Tablourile de bord sunt personalizabile, astfel încât echipele pot evidenția sistemele prioritare și pot identifica rapid problemele urgente. Nucleul său eficient de monitorizare menține costurile operaționale la un nivel redus chiar și cu mii de verificări pe minut, permițând configurațiilor de mari dimensiuni să mențină o vizibilitate receptivă în timp real.
Funcționalități de IA și automatizare
Checkmk include reglarea automată a pragurilor și procesarea inteligentă a regulilor, care reduc oboseala generată de alerte prin adaptarea la comportamentul de referință. Poate descoperi automat gazdele și serviciile și poate aplica reguli de monitorizare predefinite fără configurare manuală. Funcțiile predictive susțin analiza tendințelor și planificarea capacității, ajutând echipele să identifice din timp riscurile de saturație. Pentru medii complexe, sistemul său de automatizare bazat pe reguli simplifică actualizările de configurare, activarea verificărilor și logica notificărilor. Funcțiile mai avansate de IA necesită de obicei integrarea cu instrumente externe de analiză, deoarece Checkmk se concentrează pe monitorizarea deterministă, mai degrabă decât pe automatizarea completă a incidentelor.
Ușurința implementării
Checkmk este ușor de implementat, având un proces de instalare rapid și ghiduri clare de configurare. Ediția „raw” utilizează componente open source, în timp ce ediția „enterprise” include o interfață de utilizator îmbunătățită și performanțe sporite. Agenții pot fi instalați cu ajutorul unui script scurt, iar funcția de detectare automată identifică imediat serviciile noi. Se integrează bine cu mediile virtualizate și containerizate și se scalează cu ușurință prin intermediul site-urilor de monitorizare distribuite pentru implementări de amploare sau în mai multe regiuni. Deoarece oferă setări implicite solide încă de la început, echipele pot pune rapid în funcțiune un sistem complet de monitorizare fără a fi nevoie de ajustări extinse.
Prețuri
Checkmk oferă o ediție „raw” gratuită care include monitorizarea de bază, tablouri de bord și alerte, fiind potrivită pentru echipe mici sau medii de laborator. Ediția „enterprise” adaugă funcționalități avansate, precum performanță îmbunătățită, automatizare extinsă, analize predictive și raportare pe termen lung. Prețul pentru ediția „Enterprise” se bazează, de obicei, pe numărul de gazde monitorizate, începând de la un nivel de intrare accesibil și scalându-se pentru infrastructuri mai mari. Acest lucru menține costurile generale previzibile și atractive pentru organizațiile care doresc un sistem de monitorizare puternic, fără taxe de utilizare ridicate, de tip SaaS.
5. Datadog
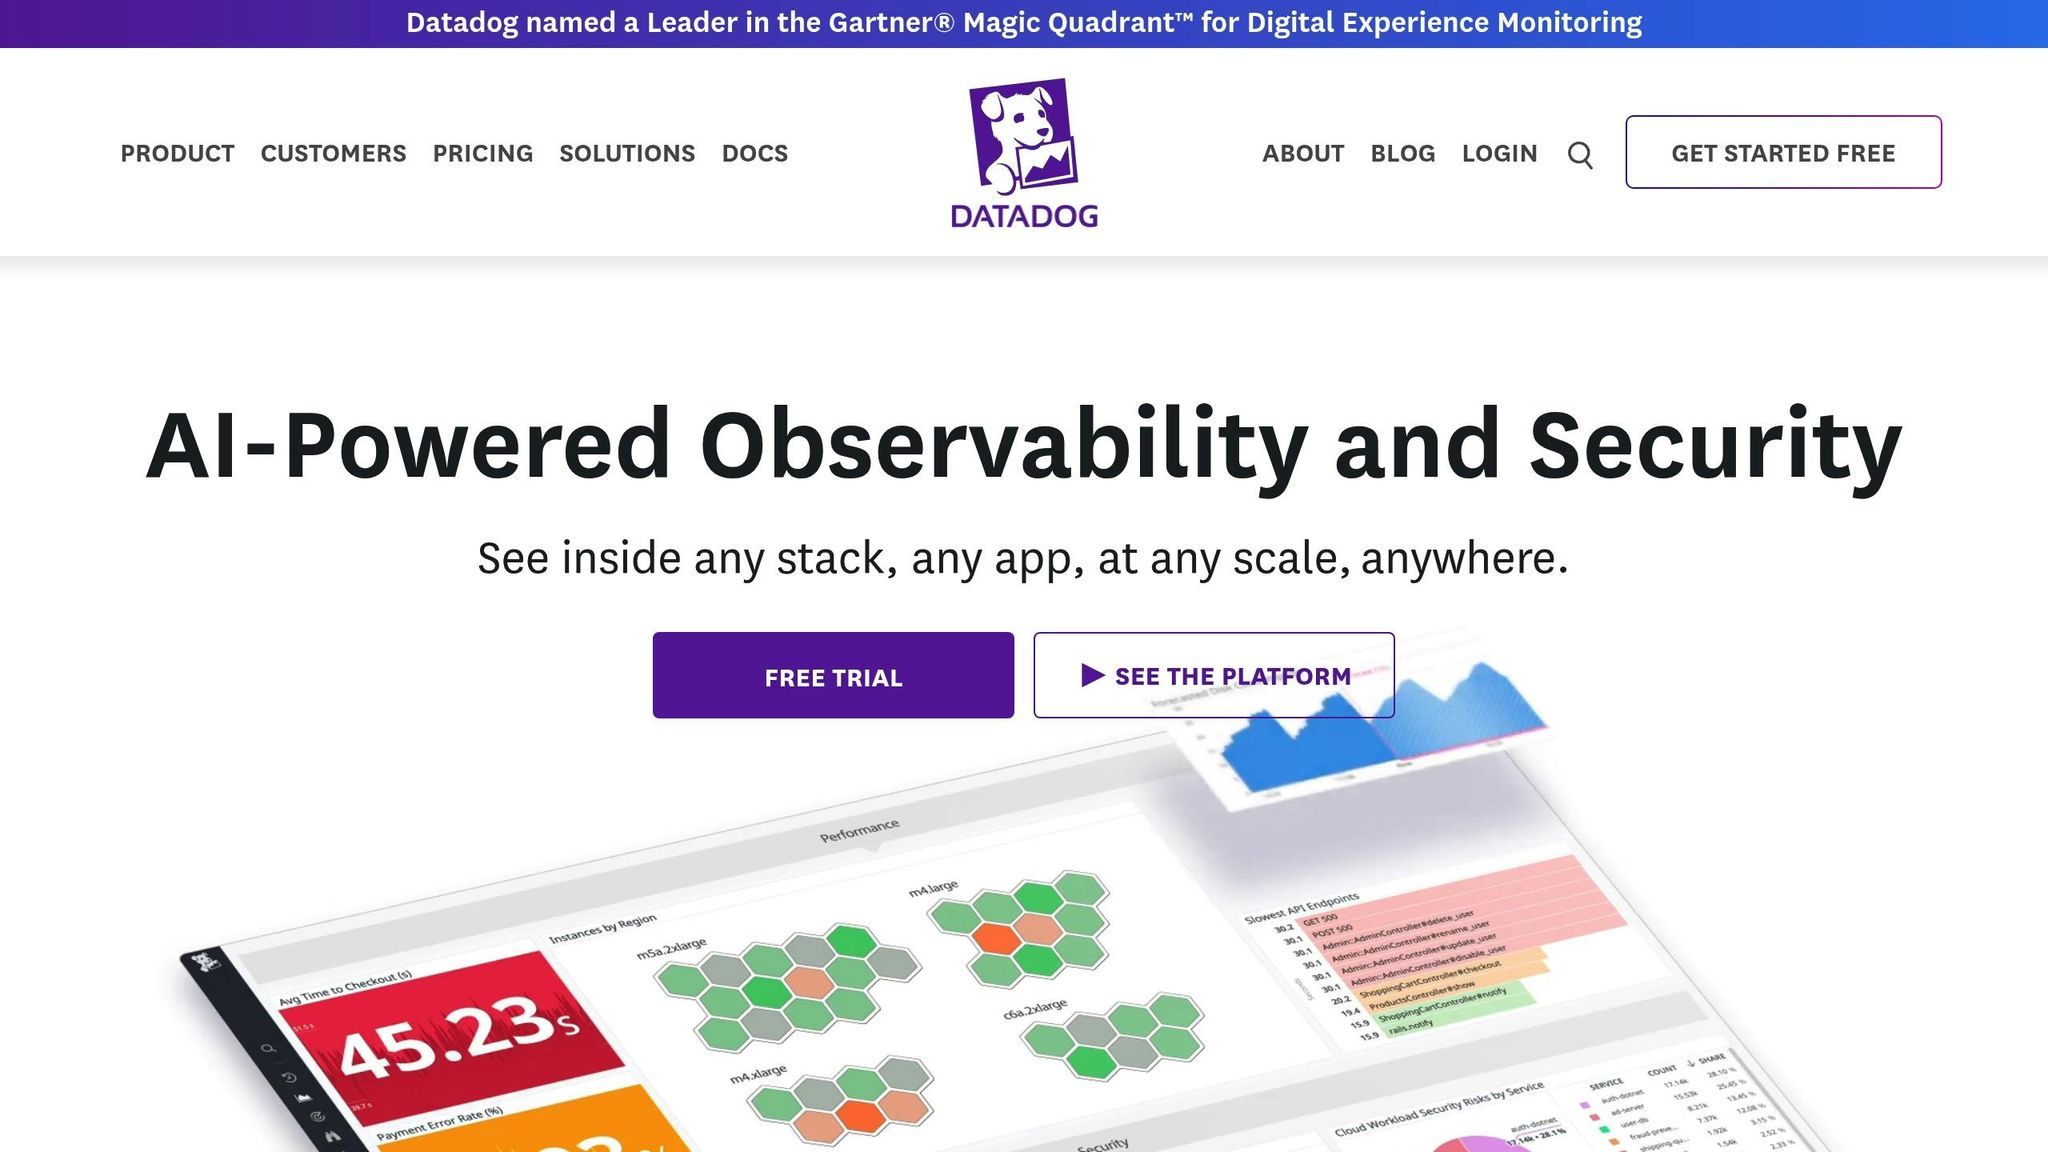
Datadog duce monitorizarea serverelor și a VPS-urilor la un nivel superior, analizând în profunzime performanța la nivel de cod. Cu ajutorul funcției de urmărire distribuită bazată pe inteligență artificială, vă ajută să identificați cu precizie blocajele de performanță și să detectați anomaliile pe măsură ce apar. Prin conectarea jurnalelor aplicațiilor cu metricile de sistem, Datadog facilitează identificarea cauzelor principale ale problemelor și rezolvarea rapidă a acestora, asigurând funcționarea fără întreruperi a infrastructurii dumneavoastră.
Domeniul de monitorizare
Datadog reunește metricile de infrastructură, jurnalele, trasările și semnalele de securitate într-o singură platformă de observabilitate. Poate prelua date telemetrice de la gazde, containere, funcții fără server, servicii cloud gestionate și aplicații personalizate. Integrările sale acoperă sute de tehnologii, astfel încât să puteți urmări comportamentul bazelor de date, performanța API-urilor, clusterele Kubernetes și sarcinile de lucru native în cloud dintr-o vizualizare unificată. Datele sunt colectate la o frecvență ridicată și corelate între indicatori, jurnale și trasee pentru a evidenția tiparele de performanță și blocajele. Acest domeniu de aplicare extins ajută echipele să înțeleagă cum se comportă fiecare componentă a stivei lor sub sarcina reală.
Capacități în timp real
Datadog oferă tablouri de bord în timp real care se actualizează continuu, afișând utilizarea procesorului, latența cererilor, starea containerelor, lățimea de bandă a rețelei și multe altele pe măsură ce acestea se modifică. Puteți personaliza tablourile de bord pentru a evidenția semnalele relevante pentru un diagnostic rapid. De asemenea, suportă alertarea în timp real, astfel încât probleme precum vârfurile de erori sau saturarea memoriei pot declanșa notificări imediat ce apar. Chiar și în cazul unor volume mari de date, agentul și backend-ul SaaS sunt concepute pentru a menține costurile de operare la un nivel redus, oferind în același timp vizibilitate la secundă în sistemele distribuite.
Funcționalități de IA și automatizare
Datadog include instrumente bazate pe IA care analizează valorile de referință istorice pentru a detecta anomalii și a reduce zgomotul generat de falsele pozitive. Suita sa Bits AI adaugă trierea automată, corelarea între semnale și rezumate ale incidentelor pentru a accelera investigațiile. Poate sugera cauze probabile, propune pași de remediere la nivel de cod sau de configurare și genera documentație după incidente. De asemenea, puteți crea fluxuri de lucru folosind limbajul natural, transformând sarcinile operaționale de rutină în secvențe automatizate fără a scrie scripturi. Acest lucru ajută echipele să eficientizeze procesele de răspuns, menținând în același timp controlul asupra căilor de escaladare.
Ușurința implementării
Datadog este ușor de implementat datorită agentului său ușor și designului nativ pentru cloud. Puteți instala agentul cu un singur script, puteți utiliza imagini Docker sau îl puteți implementa prin Kubernetes cu Helm. Integrările sale detectează automat serviciile și încep să colecteze date de telemetrie cu o configurare minimă. Deoarece totul rulează pe platforma găzduită de Datadog, nu este necesară întreținerea unui backend. Se integrează cu ușurință atât în medii hibride, cât și în medii multi-cloud și se adaptează la o infrastructură în continuă schimbare, fiind astfel potrivit pentru echipele care doresc vizibilitate completă fără a gestiona propriul stack de monitorizare.
Prețuri
Datadog funcționează pe baza unui model de prețuri modular, planurile de bază fiind taxate pe gazdă monitorizată, iar funcțiile opționale fiind facturate în funcție de utilizare. Nivelul Pro începe de la aproximativ 15 USD pe gazdă pe lună, în cazul facturării anuale, în timp ce planurile Enterprise sunt mai costisitoare și includ funcții avansate de guvernanță și de inteligență artificială. Se aplică costuri suplimentare pentru jurnale, urmăriri, teste sintetice, metrici personalizate și perioadă de păstrare extinsă. Acest lucru permite echipelor să adopte doar componentele de care au nevoie, deși costurile pot crește rapid în medii cu multe gazde sau cu un volum mare de jurnale. Rămâne o opțiune flexibilă pentru organizațiile care doresc o observabilitate cuprinzătoare, susținută de o platformă SaaS matură.
Avantaje și dezavantaje
După ce am explorat caracteristicile fiecărui instrument, să analizăm punctele forte și limitările acestora pentru a vă ajuta să decideți care dintre ele se potrivește cel mai bine nevoilor dumneavoastră. Alegerea potrivită va depinde de factori precum funcționalitatea, ușurința de utilizare și bugetul.
Prometheus oferă o performanță remarcabilă, cu o colectare eficientă a datelor din serii temporale și un limbaj de interogare robust (PromQL), adaptat pentru configurații native în cloud. Cu toate acestea, nu dispune de instrumente de vizualizare integrate și de capacități de stocare pe termen lung, fiind necesare soluții externe pentru aceste funcționalități.
Grafana excelează în vizualizarea flexibilă și avansată a datelor, integrându-se perfect cu diverse surse de date, inclusiv Prometheus, pentru a crea tablouri de bord atractive din punct de vedere vizual. Principala sa limitare este absența colectării native de date, ceea ce îl face să depindă de instrumente externe pentru preluarea datelor.
Zabbix este o soluție de monitorizare scalabilă și cuprinzătoare. Fiind open-source, elimină costurile de licențiere, dar necesită adesea o configurare mai complexă și întreținere continuă, ceea ce poate consuma multe resurse.
Netdata se remarcă prin designul său ușor și monitorizarea performanței în timp real, oferind un proces de configurare rapid – adesea finalizat în câteva minute. Acest lucru îl face o alegere excelentă pentru medii de dimensiuni mici și medii. Cu toate acestea, are capacități limitate pentru analiza datelor istorice pe termen lung și oferă un sistem de alerte mai simplu în comparație cu platformele de nivel enterprise.
Checkmk oferă monitorizare scalabilă cu metrici în timp real și alerte personalizabile, fiind astfel ideal pentru implementări de servere la scară largă. Funcționalitățile sale avansate implică însă o curbă de învățare mai abruptă și o complexitate crescută a configurării pe măsură ce dimensiunea implementării crește.
Datadog oferă o experiență de monitorizare cuprinzătoare, cu informații bazate pe inteligență artificială (AI), acoperind infrastructura, aplicațiile și gestionarea jurnalelor. Deși funcționalitățile sale sunt extinse, costurile abonamentului pot crește rapid (de exemplu, 15 USD pe gazdă/lună pentru infrastructură, cu taxe suplimentare pentru APM și gestionarea jurnalelor). În plus, stăpânirea funcționalităților sale avansate necesită o investiție semnificativă de timp și efort de învățare.
Tabelul de mai jos rezumă principalele avantaje, dezavantaje și structurile de costuri ale fiecărui instrument, pentru o comparație rapidă:
| Instrument | Puncte forte cheie | Puncte slabe principale | Structura costurilor |
|---|---|---|---|
| Prometheus | Colectare eficientă a datelor din serii temporale și limbaj de interogare puternic | Nu dispune de funcții integrate de vizualizare și stocare | Open-source (doar costuri operaționale) |
| Grafana | Vizualizare flexibilă și avansată, cu suport pentru surse multiple | Nu dispune de funcție nativă de colectare a datelor | Open-source (doar costuri operaționale) |
| Zabbix | Monitorizare scalabilă și cuprinzătoare pentru configurațiile IT tradiționale | Configurare și întreținere complexe | Gratuit (cu costuri de găzduire și întreținere) |
| Netdata | Monitorizare ușoară, în timp real, cu configurare rapidă | Analiză limitată a datelor istorice și a alertelor | Începe de la 4,50 USD pe nod pe lună |
| Checkmk | Monitorizare scalabilă cu indicatori în timp real și alerte personalizate | Curba de învățare abruptă pentru funcțiile avansate | Aproximativ 80 USD/lună pentru ~100 de gazde |
| Datadog | Monitorizare extinsă la scară cloud cu informații bazate pe IA | Costuri mai mari și o curbă de învățare abruptă | Începând de la 15 USD pe gazdă/lună (plus taxe suplimentare) |
Decizia dvs. depinde, în ultimă instanță, de expertiza și bugetul echipei dvs. Instrumentele open-source, precum Prometheus și Zabbix, pot fi extrem de eficiente dacă echipa dvs. dispune de cunoștințele tehnice necesare pentru a le gestiona. Pe de altă parte, opțiunile comerciale precum Checkmk, Netdata și Datadog oferă soluții gata de utilizare care reduc efortul intern, dar implică adesea costuri mai mari.
Concluzie
Alegerea instrumentului de monitorizare potrivit pentru serverul dvs. dedicat sau VPS în 2025 se reduce la înțelegerea mediului dvs. specific, a cunoștințelor tehnice și a constrângerilor bugetare.
Pentru configurații mai mici sau pentru cele care necesită rezultate rapide, Netdata este o alegere solidă. Informațiile în timp real și configurarea simplă îl fac ideal pentru monitorizarea imediată, fără a necesita o configurare complexă.
Mediile mai mari și mai complexe necesită adesea soluții scalabile. Dacă lucrați cu sisteme native în cloud sau containerizate, Prometheus și Grafana sunt opțiuni excelente. Acestea combină colectarea puternică de date în serii temporale cu vizualizări personalizabile, deși necesită un nivel mai ridicat de expertiză tehnică pentru a fi gestionate eficient.
Pentru întreprinderi, merită luate în considerare Checkmk și Datadog. Checkmk oferă capacități ample de monitorizare și poate fi rentabil pentru implementări la scară largă. Pe de altă parte, Datadog excelează prin informațiile bazate pe inteligență artificială și integrările extinse, deși scalarea poate necesita o planificare mai atentă a resurselor.
În mediile IT tradiționale cu infrastructuri diverse, Zabbix rămâne un concurent puternic. Deși configurarea sa poate fi mai complexă, funcționalitățile sale robuste și lipsa costurilor de licențiere îl fac atractiv pentru organizațiile care dispun de administratori de sistem dedicați.
În cele din urmă, cea mai bună soluție de monitorizare este cea care se aliniază cu capacitatea echipei dvs. de a o gestiona eficient. Un instrument plin de funcționalități poate deveni rapid o povară dacă vă depășește capacitatea operațională. Începerea cu o opțiune ușoară, precum Netdata, vă permite să stabiliți un punct de referință pentru monitorizare, cu flexibilitatea de a adopta platforme mai cuprinzătoare pe măsură ce infrastructura și expertiza dvs. cresc.
Obiectivul este să vă concentrați pe o monitorizare consecventă și utilă, mai degrabă decât să urmăriți fiecare funcționalitate avansată. Adoptând o abordare treptată și personalizată, vă puteți asigura că strategia de monitorizare evoluează odată cu cerințele mediului dumneavoastră de găzduire.
Întrebări frecvente
Cum îmbunătățesc IA și automatizarea monitorizarea serverelor în 2025 și ce instrumente oferă aceste funcționalități?
În 2025, IA și automatizarea transformă monitorizarea serverelor, făcând gestionarea serverelor dedicate și a VPS-urilor mai inteligentă, mai eficientă și mai receptivă. Cu ajutorul sistemelor bazate pe IA, se pot identifica tiparele neobișnuite, se pot anticipa potențialele defecțiuni și se pot rezolva automat problemele de rutină. Această abordare reduce timpul de nefuncționare și sporește fiabilitatea generală a serverelor.
Instrumente precum Dynatrace, Logz.io și Datadog sunt pionieri în acest domeniu, integrând IA și automatizarea. Acestea oferă informații în timp real, detectează anomalii și pun la dispoziție analize predictive concepute special pentru medii de găzduire de înaltă performanță. Aceste capacități asigură funcționarea fără probleme și în condiții de siguranță a serverelor, chiar și în condiții de încărcare intensă.
Ce ar trebui să iau în considerare atunci când aleg între instrumentele de monitorizare open-source și cele cu plată pentru serverul meu sau VPS-ul meu?
Atunci când evaluați opțiunile dintre instrumentele de monitorizare open-source și cele cu plată, este esențial să luați în considerare ce se potrivește cel mai bine nevoilor și resurselor dumneavoastră. Instrumentele open-source sunt de obicei gratuite și oferă un grad ridicat de personalizare, ceea ce este ideal dacă aveți cunoștințele tehnice necesare și aveți nevoie de o soluție flexibilă. În schimb, instrumentele cu plată vin adesea cu interfețe intuitive, funcții avansate și asistență dedicată, ajutându-vă să economisiți timp și să simplificați procesul.
Pentru a face alegerea potrivită, ia în considerare câțiva factori cheie: bugetul tău, nivelul de asistență de care ai putea avea nevoie, cât de ușor se configurează instrumentul și dacă acesta se poate adapta pe măsură ce cerințele serverului sau ale VPS-ului tău cresc. Dacă îți acorzi timpul necesar pentru a evalua aceste elemente, vei putea alege opțiunea care se potrivește cel mai bine cu obiectivele tale de monitorizare și performanță.
Care este cea mai bună modalitate de a vă asigura că soluția de monitorizare a serverului se adaptează pe măsură ce infrastructura dvs. se extinde?
Pentru ca soluția dvs. de monitorizare să țină pasul cu infrastructura dvs. în expansiune, este esențial să vă concentrați pe instrumente și strategii care pun accentul pe scalabilitate și automatizare. Alegeți platforme capabile să gestioneze arhitecturi distribuite, permițând monitorizarea fără probleme a mai multor servere sau mașini virtuale pe măsură ce sistemul dvs. se extinde. Funcționalități precum analizele bazate pe inteligență artificială și tablourile de bord în timp real sunt deosebit de utile – ele pot gestiona volume mai mari de date și pot oferi în continuare informații relevante fără a încetini sistemul.
De asemenea, este recomandabil să alegeți instrumente care includ alerte personalizabile și se integrează ușor în fluxurile de lucru actuale. În acest fel, puteți identifica și rezolva rapid problemele pe măsură ce infrastructura dvs. evoluează. Obisnuiți-vă să evaluați și să optimizați periodic configurația de monitorizare pentru a vă asigura că rămâne eficientă și fiabilă pe tot parcursul procesului de creștere.

Cum să găzduiți modelele Ollama AI pe servere dedicate
Aflați cum să găzduiți modelele Ollama AI pe servere dedicate pentru a menține securitatea datelor, a asigura scalabilitatea și a îmbunătăți performanța.
5 min citire - 8 septembrie 2025
Cum se instalează și se utilizează Redis pe un VPS
9 min citire - 7 ianuarie 2026

Aveți întrebări sau aveți nevoie de o soluție personalizată?

Opțiuni flexibile

Acoperire globală

Implementare instantanee
Opțiuni flexibile
Acoperire globală
Implementare instantanee